
Mittwoch, 11. November 2026
Die Bereitstellung eines Content Delivery Networks (CDN) zur Verteilung der Assets Ihrer Website auf schnelle, global verteilte Edge-Server, die sich näher an den Nutzern befinden, kann für jede wachsende Website ein großes Upgrade sein: Es verringert die Latenz für Besucher und schützt Ihren Ursprungsserver (die Backend-Quelle der Wahrheit, die Ihre Originalinhalte enthält) vor hohem Traffic.
Klingt perfekt, oder? Nun, die Übergangsphase kann etwas seltsam sein.
Wir hören manchmal von Websiteinhabern, dass der Crawler-Traffic auf ihrem Server direkt nach der Bereitstellung ihrer Website hinter einem CDN fast sofort in die Höhe schießt – genau das, was sie eigentlich verhindern wollten. Bevor diese Edge-Server ihre Caches füllen, müssen sowohl Nutzerbesuche als auch Crawler-Anfragen weiterhin direkt vom Ursprung abgerufen werden.
Wenn ihr zu einem CDN wechselt, solltet ihr euch sowohl mit der Funktionsweise des Crawling-Budgets als auch mit der Reduzierung der Crawling-Frequenz von Google in Notfällen vertraut machen. In diesem Blogpost möchten wir Ihnen zeigen, was Sie bei einem solchen Wechsel erwartet und welche Herausforderungen damit verbunden sind. Deshalb haben wir uns (mit Schutzhelm und Feuerwehrschlauch) in Folge 5 von „The Non-Canonical Cabinet“ auf den Weg gemacht, um Sie durch die Umstellung zu führen. Wenn Sie schon einmal zu einem CDN gewechselt sind und sich über den neuen Traffic gewundert haben oder wenn Sie vermeiden möchten, dass Ihre Website versehentlich aus der Google Suche entfernt wird, ist dieser Artikel genau das Richtige für Sie.
Warum wird also alles gleichzeitig gecrawlt?
Wenn Sie zum CDN wechseln, kann es zu einem Anstieg des Crawler-Traffics kommen, da die Crawling-Infrastruktur von Google das Crawling-Kapazitätslimit (auch als Hostload bezeichnet) Ihrer Website berechnet:
- Immer langsamere Antworten verringern die Crawling-Frequenz. Die automatisierte Crawling-Infrastruktur von Google überwacht kontinuierlich den Zustand und die Reaktionsfähigkeit Ihres Hostservers. Wenn sich die Antwortzeiten erhöhen, werden unsere Crawler langsamer, damit wir Ihren Server nicht überlasten und die Nutzerfreundlichkeit Ihrer Website nicht beeinträchtigen.
- Schnelle und stabile Antworten beschleunigen das Crawling. Wenn ein Server schnell und konsistent antwortet, interpretieren unsere Systeme diese Geschwindigkeit als Zeichen einer fehlerfreien, leistungsfähigen Infrastruktur. Sofern Crawling-Bedarf besteht, wird das Crawling-Kapazitätslimit schrittweise erhöht.
Sobald Ihr DNS auf ein schnelles CDN-Edge-Netzwerk verweist, sinken die Verbindungs- und Antwortzeiten drastisch. Für unsere Crawling-Systeme sieht es so aus, als hätte Ihr Server gerade ein massives Hardware-Upgrade erhalten. Daher erhöhen unsere Crawler ihre Anforderungsrate entsprechend.
Das Problem: Cache-Fehler auf den Edge-Servern.
Eine höhere Crawling-Frequenz wäre kein Problem, wenn das CDN alle diese Anfragen am Edge-Server abfangen würde. Der Haken ist, dass ein brandneues CDN mit einem leeren (kalten) Cache beginnt.
Bei der allerersten Anfrage für eine URL an einem Edge-Standort hat das CDN noch keine Kopie dieses Assets (HTML-Dokumente, CSS, JavaScript, Bilder usw.). Es handelt sich um einen Cache-Fehler. Um die Anfrage zu erfüllen, muss der Edge-Server den gesamten Weg zurück zu Ihrem Ursprungsserver „gehen“, die Antwort abrufen, eine im Cache speicherbare Kopie für sich selbst speichern und dann den Client bedienen. Erst nachfolgende Anfragen für dieselbe im Cache gespeicherte URL werden zu Cache-Treffern, die direkt vom Edge-Server bereitgestellt werden, ohne Ihren Ursprungsserver zu belasten. In unserem Video wurde der Edge-Server durch ein Gummihuhn dargestellt, das zwischen einem Stapel Haftnotizen hin und her läuft. Netzwerkdiagramme sind subjektiv.
Im Grunde ist der eigentliche Engpass bei der Einführung eines CDN immer noch der Ursprungsserver.
Menschliche Besucher konzentrieren sich in der Regel auf eine relativ kleine Gruppe beliebter Seiten (Ihre Startseite, Top-Artikel oder aktive Werbeaktionen), die den CDN-Cache schnell aufwärmen. Crawler tun genau das Gegenteil. Ihre Aufgabe ist es, systematisch die gesamte Bandbreite Ihres URL-Inventars zu erkunden.
Kombinieren Sie nun diese beiden Verhaltensweisen:
- Schnelle Edge-Antworten signalisieren den Crawlern von Google, dass es sicher ist, schneller zu crawlen.
- Wenn Crawler diese große Anzahl von URLs zum ersten Mal durchgehen, löst jede nicht im Cache gespeicherte URL einen Cache-Fehler aus, der direkt an Ihren Ursprungsserver weitergeleitet wird.
Crawler erhöhen ihre Crawling-Frequenz nicht sofort und viele CDNs enthalten ein integriertes Verbindungs-Pacing, das Traffic-Spitzen ausgleicht. Bis Ihre Edge-Caches gefüllt (aufgewärmt) sind, fungiert Ihr CDN jedoch noch nicht als Schutzschild. Ihr Ursprungsserver übernimmt weiterhin die Hauptarbeit.
Du darfst nicht crawlen! Wenn der pauschale Botschutz zu weit geht
Ein unerwarteter Anstieg automatisierter Anfragen in den Ursprungsprotokollen direkt nach einer Migration kann Administratoren verständlicherweise nervös machen, wenn ihnen nicht klar ist, warum dies geschieht. Es ist verlockend, sich die Diagramme mit den steigenden Anfragen anzusehen, während der Cache aufgewärmt wird, und zu versuchen, dieses Problem zu beheben, indem man sich im CDN-Dashboard anmeldet und den pauschalen Botschutz aktiviert. Um Cherry zu zitieren: „BOTS SHALL NOT PASS!“ („Bots dürfen nicht passieren!“)
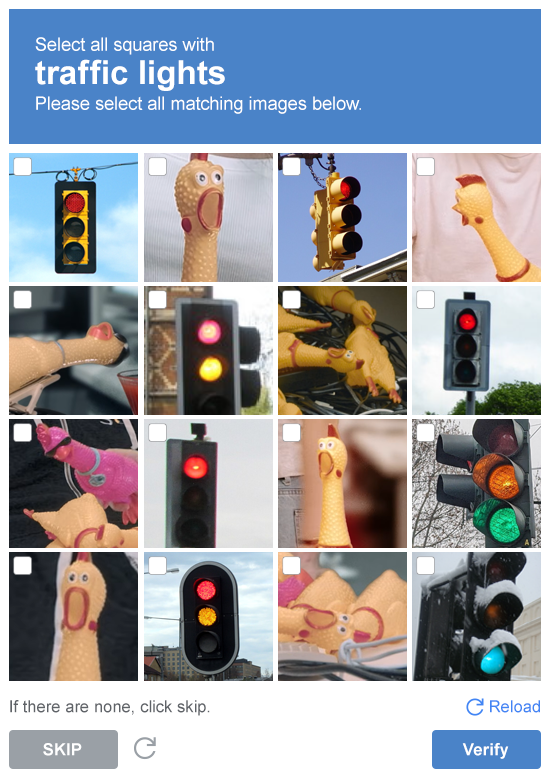
Das Problem mit pauschalen Sicherheitsregeln liegt auf der Hand: Ohne Ausnahmen behandeln sie den gesamten automatisierten Traffic gleich, einschließlich des Traffics von Crawlern, die für Sie wichtig sind. Wenn ein CDN oder eine Web Application Firewall (WAF) automatisierte Anfragen kennzeichnet und sie mit einer Sicherheitsabfrage wie CAPTCHA abfängt, bestehen die Crawler von Google den Test nicht. Der Googlebot hat viele Talente, aber das Erkennen von Ampeln und Hühnern gehört nicht dazu. Sogar Gary kann sie manchmal nicht lösen.
Wenn der pauschale Botschutz aktiviert bleibt, ohne dass verifizierte Crawler ausgenommen werden, bleiben Crawler im Grunde auf einer Fehlerseite hängen, die für die Google Suche oder andere Produkte, die auf gecrawlten Daten basieren, nicht nützlich ist. Aus unserer Sicht erscheint Ihre Website absichtlich eingeschränkt oder fehlerhaft. Wenn dies so bleibt, ziehen sich unsere Crawler zurück und Ihre Seiten, Produkteinträge und Ihre Hühnerbilder werden nicht mehr in der Google Suche angezeigt.
So trainieren Sie Ihr CDN (ohne Ihren Ursprungsserver zu überlasten)
Sie müssen keinen Brandschutzbeauftragten einstellen, um ein CDN bereitzustellen. Sie benötigen die richtigen Erwartungen und einen Plan, z. B.:
- Wenn Sie Bots blockieren müssen, lassen Sie verifizierte Bots in Ihren CDN- und Firewall-Einstellungen zu. Die meisten großen CDNs und WAFs bieten einen integrierten Ein/Aus-Button oder eine verwaltete Regel, um bekannte/verifizierte Bots zuzulassen. So können Ihre bevorzugten Crawler CAPTCHA-Sicherheitsabfragen umgehen, während unerwünschter Traffic weiterhin gefiltert wird. Sie können unsere Crawler anhand der von Google veröffentlichten IP-Bereiche identifizieren. Oder noch besser: Konfigurieren Sie Ihre robots.txt-Datei oder verwenden Sie Regeln, um bestimmte unerwünschte Bots gezielt zu blockieren, anstatt alle automatisierten Clients zu blockieren.
- Wärmen Sie Ihre Caches vor, bevor Sie die Schleusen öffnen. Bevor Sie den gesamten Traffic über das neue CDN leiten, rufen Sie Ihre Seiten mit dem höchsten Traffic, die Seiten mit dem bevorstehenden Spitzen-Traffic (z. B. Werbeaktionen oder saisonale Markteinführungen) und die am häufigsten gecrawlten URLs programmatisch in einem kontrollierten Tempo über das CDN ab, damit die Edge-Caches bereit sind, Traffic zu verarbeiten. Oder, wenn Sie im Gegensatz zu Gary tatsächlich Freunde haben, bitten Sie sie, jeweils auf zwei unterschiedliche URLs zuzugreifen. Das funktioniert auch.
-
Verwenden Sie
429oder503, wenn Sie eine vorübergehende Bremse benötigen. Wenn das Crawling-Volumen Ihren Ursprungsserver während des Aufwärmens der Caches immer noch kritisch belastet, konfigurieren Sie die Ratenbegrenzungsregeln Ihres Servers oder CDNs so, dass für einen kurzen Zeitraum (einige Stunden oder maximal 1–2 Tage) der HTTP-Statuscode429 (Too Many Requests)oder503 (Service Unavailable)zurückgegeben wird, wie in unserem Leitfaden zur dringenden Reduzierung der Google-Crawling-Frequenz beschrieben.
Kurzfassung (Wer setzt eine Kurzfassung ans Ende?!)
Bevor Sie ein Ethernet-Kabel um den Serverschrank wickeln und Feierabend machen, sollten Sie beim Wechsel zu einem CDN drei Dinge beachten:
- Schnellere Antworten bedeuten schnelleres Crawling: Eine niedrige CDN-Edge-Latenz signalisiert den Crawlern von Google, dass Ihre Website fehlerfrei ist und eine höhere Crawling-Frequenz verarbeiten kann.
- Caches schützen Sie nur beim zweiten Besuch: Bei einem kalten Cache ist die erste Anfrage für jede eindeutige URL ein Cache-Fehler, der direkt an Ihren Ursprungsserver weitergeleitet wird. Wärmen Sie Ihre Caches vor, wo immer möglich.
-
Nehmen Sie verifizierte Crawler bei Bedarf von Bot-Sicherheitsabfragen aus: Lassen Sie nicht zu, dass pauschale WAF- oder CAPTCHA-Regeln die Crawler von Google mit
403-Wänden oder Sicherheitsabfrageseiten blockieren. Verwenden Sie Ausnahmen für verifizierte Bots und nutzen Sie vorübergehende429- oder503-Antworten, wenn Ihr Ursprungsserver wirklich eine Pause braucht.
Nicht unterhaltsam genug? Folge ansehen
Sehen Sie sich das Finale der ersten Staffel (Folge 5) von „The Non-Canonical Cabinet“ an. Wir erklären die Netzwerkarchitektur anhand eines Schutzhelms aus Kunststoff, eines rauchenden Aktenschranks und eines Gummihuhns, das als Edge-Server fungiert – alles Dinge, die wir ziemlich sicher nicht in unseren ursprünglichen Stellenbeschreibungen hatten.
Interessiert an der gesamten ersten Staffel? Wir haben versucht, URLs und robots.txt auseinanderzunehmen. Wir haben über 404-Fehler und Weiterleitungen gesprochen.
Sehen Sie sich alle 5 Folgen an.
Wir garantieren eine Überdosis Geflügel.
Haben Sie einen seltsamen Grenzfall, den wir in der nächsten Staffel (je nach Budget) aus dem (leicht angekokelten) Schrank holen sollen? Hinterlassen Sie einen Kommentar zu dem Video.
Halten Sie Ihre Caches warm, Ihre Firewalls aufgeräumt und Ihre Gummihühner in Luftpolsterfolie verpackt.