

PLACES_COUNT_PER_TYPE_V2 फ़ंक्शन, BigQuery टेबल दिखाता है. इसमें जगहों की संख्या और सैंपल के तौर पर जगह के आईडी शामिल होते हैं. इन्हें जगह के टाइप के हिसाब से, कई इनपुट जगहों के लिए बांटा जाता है. इस फ़ंक्शन को बैच प्रोसेसिंग को बेहतर बनाने के लिए डिज़ाइन किया गया है. इसके लिए, यह जगहों के इनपुट टेबल पैरामीटर को स्वीकार करता है. इनपुट टेबल की मदद से, जगहों की जानकारी दी जाती है. साथ ही, जगहों के टाइप को कलेक्शन के तौर पर बताया जाता है.
सिंटैक्स
SELECT * FROM `PROJECT_NAME.LINKED_DATASET_NAME.PLACES_COUNT_PER_TYPE_V2`(
  TABLE input_geographies,
  target_types,
  filters
)
पैरामीटर
PROJECT_NAME: आपके Google Cloud प्रोजेक्ट का नाम.LINKED_DATASET_NAME: उस BigQuery डेटासेट का नाम जिसमें जगहों की अहम जानकारी वाले फ़ंक्शन शामिल हैं (उदाहरण के लिए,places_insights___us).input_geographies: BigQuery टेबल, जिसमें विश्लेषण के लिए भौगोलिक जानकारी शामिल है. इस टेबल में ये कॉलम शामिल होने चाहिए:target_types(ARRAY<STRING>): जगह के टाइप की स्ट्रिंग का कलेक्शन, जिसकी संख्या आपको चाहिए. जगहों की गिनती तब की जाएगी, जब वे उनकेtypesकलेक्शन में मौजूद किसी भी टाइप से मैच करेंगी, न कि सिर्फ़primary_typeसे.filters(JSON): यह एक JSON ऑब्जेक्ट है, जिसमें जगहों को और फ़िल्टर करने के लिए की-वैल्यू पेयर शामिल होते हैं. फ़िल्टर पैरामीटर देखें.
आउटपुट टेबल स्कीमा
PLACES_COUNT_PER_TYPE_V2 फ़ंक्शन, इन कॉलम वाली टेबल दिखाता है:
| कॉलम का नाम | डेटा टाइप | ब्यौरा |
|---|---|---|
geo_id |
STRING | input_geographies टेबल से, इनपुट की गई जगह की जानकारी के लिए यूनीक आइडेंटिफ़ायर. |
input_geography |
GEOGRAPHY | input_geographies टेबल का ओरिजनल GEOGRAPHY ऑब्जेक्ट. |
place_type |
STRING | target_types कलेक्शन में मौजूद जगह का टाइप, जिसे यह लाइन दिखाती है. |
place_count |
INTEGER | इलाके में या उसके आस-पास, place_type और अन्य फ़िल्टर से मैच करने वाली जगहों की संख्या. |
sample_place_ids |
ARRAY<STRING> | इस टाइप और जगह की जानकारी की शर्तों से मैच करने वाले, ज़्यादा से ज़्यादा 250 जगह के आईडी का कलेक्शन. |
आउटपुट में, target_types कलेक्शन में बताए गए geo_id और place_type के हर कॉम्बिनेशन के लिए एक लाइन होगी. भले ही, संख्या शून्य हो.
यह कैसे काम करता है
यह फ़ंक्शन, input_geographies टेबल में दी गई हर जगह के लिए काम करता है.
हर देश/इलाके के लिए, यह उन जगहों की गिनती करता है जो target_types कलेक्शन में मौजूद किसी भी टाइप से मैच करती हैं. साथ ही, filters JSON ऑब्जेक्ट में मौजूद सभी शर्तों को पूरा करती हैं. नतीजों को एग्रीगेट किया जाता है और हर geo_id और target_types में मौजूद हर टाइप के हिसाब से बांटा जाता है.
उदाहरण: न्यूयॉर्क शहर की काउंटी में अलग-अलग तरह के रेस्टोरेंट की गिनती करें
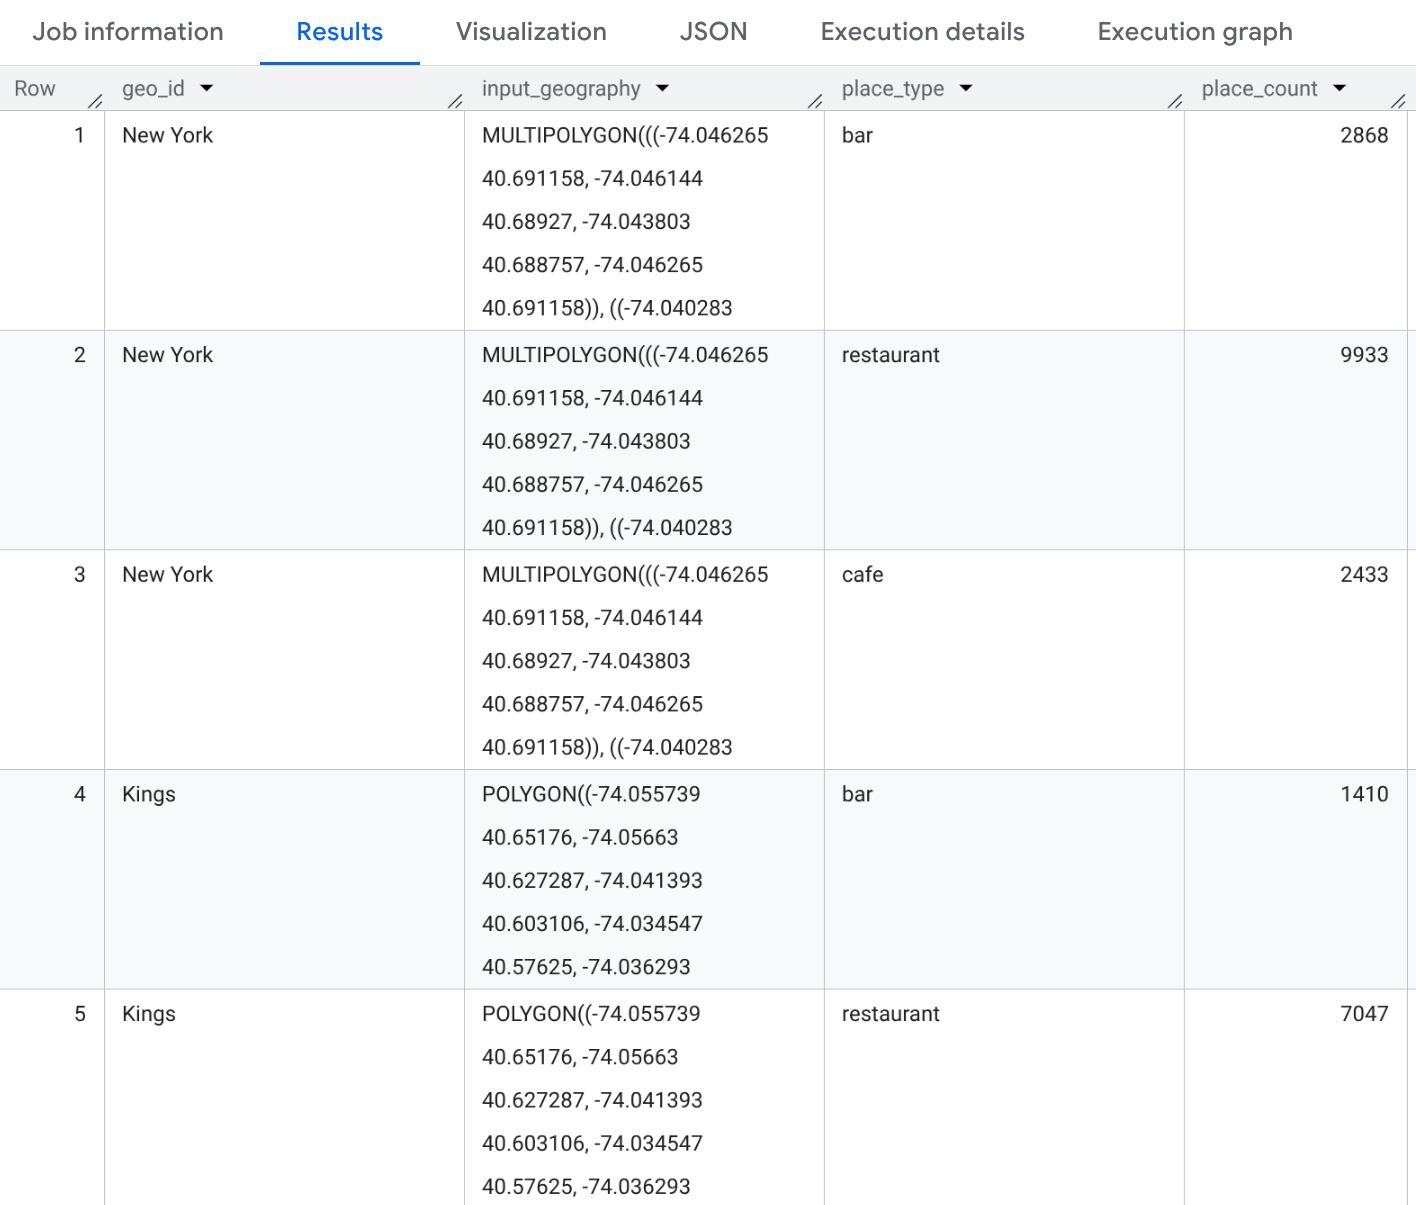
इस उदाहरण में, न्यूयॉर्क शहर की तीन काउंटी में "रेस्टोरेंट", "कैफ़े", और "बार" टाइप की संख्या वाली टेबल जनरेट की गई है.
SELECT geo_id, input_geography, place_type, place_count
FROM `PROJECT_NAME.places_insights___us.PLACES_COUNT_PER_TYPE_V2`(
  (
    SELECT county_name AS geo_id,
           ST_SIMPLIFY(county_geom, 100) AS geo
    FROM
      `bigquery-public-data.geo_us_boundaries.counties`
    WHERE
      state_fips_code = "36"  -- New York State
      AND county_name IN ("Queens", "Kings", "New York")
  ),
  ['restaurant', 'cafe', 'bar'],  -- target_types
  JSON_OBJECT(
      'business_status', ['OPERATIONAL']
  )
);
नतीजे के तौर पर, नौ लाइनों वाली एक टेबल दिखेगी (तीन काउंटी * तीन टाइप). हर लाइन में, हर काउंटी में मौजूद "रेस्टोरेंट", "कैफ़े" या "बार" की संख्या दिखेगी. अगर आपको अपने SELECT स्टेटमेंट में जगह के आईडी जोड़ने हैं, तो सैंपल के तौर पर कुछ आईडी भी शामिल किए जा सकते हैं.
PLACES_COUNT_PER_TYPE_V2 का इस्तेमाल करने के फ़ायदे
PLACES_COUNT_PER_TYPE_V2 के कई अहम फ़ायदे हैं. खास तौर पर, पुराने PLACES_COUNT_PER_TYPE फ़ंक्शन की तुलना में:
- देशों या इलाकों की बैच प्रोसेसिंग:
PLACES_COUNT_PER_TYPEएक बार में एक देश या इलाके को प्रोसेस करता है. वहीं,PLACES_COUNT_PER_TYPE_V2इनपुट के तौर पर दिए गए देशों या इलाकों कीTABLEको स्वीकार करता है. इसकी मदद से, एक ही क्वेरी में कई भौगोलिक जगहों (पॉइंट, पॉलीगॉन) के लिए, टाइप के हिसाब से विश्लेषण किया जा सकता है और उनकी संख्या का पता लगाया जा सकता है. इसके लिए, आपको कई फ़ंक्शन कॉल करने की ज़रूरत नहीं पड़ती. - बेहतर परफ़ॉर्मेंस और बढ़ाए जा सकने की योग्यता: टेबल इनपुट का इस्तेमाल करके,
PLACES_COUNT_PER_TYPE_V2BigQuery के ऑप्टिमाइज़ किए गए जियोस्पेशल जॉइन और पैरलल प्रोसेसिंग की सुविधाओं का फ़ायदा ले सकता है. ये सुविधाएं, उपलब्ध कराई गई सभी जगहों पर एक साथ काम करती हैं. इससे परफ़ॉर्मेंस में काफ़ी सुधार होता है. साथ ही, कई जगहों के लिए डेटा मैनेज करने की क्षमता भी बेहतर होती है. - शून्य संख्याएं शामिल हैं: बैच में किसी खास इलाके में नहीं मिलने वाले टाइप के लिए, 0 संख्या वाली लाइनें दिखाता है. इससे, टाइप और देश/इलाके के सभी कॉम्बिनेशन के लिए, नतीजों का पूरा सेट मिलता है.
- पुराने स्नैपशॉट: वैकल्पिक
snapshot_dateफ़िल्टर का इस्तेमाल करके, किसी खास महीने के लिए जगहों की संख्या का डेटा क्वेरी करें.
उदाहरण: खास फ़िल्टर की मदद से, टाइप के हिसाब से लोकप्रिय जगहों की पुरानी संख्या के बारे में क्वेरी करना
इस उदाहरण में, ईवी चार्जिंग स्टेशन जैसी खास जगहों की संख्या का पता लगाने का तरीका बताया गया है. इसके लिए, snapshot_date पैरामीटर का इस्तेमाल करके, पिछले महीने की संख्या का पता लगाया जाता है. यह regular_opening_hours के लिए अतिरिक्त फ़िल्टर लागू करता है, ताकि सिर्फ़ ऐसी जगहों को खोजा जा सके जो वीकेंड पर पूरे दिन खुली रहती हैं. साथ ही, min_ev_charge_connector_count के मुताबिक ईवी चार्जिंग की सुविधा (कम से कम 10 कनेक्टर उपलब्ध हों) उपलब्ध हो.
SELECT *
FROM `PROJECT_NAME.places_insights___us.PLACES_COUNT_PER_TYPE_V2`(
  (
    SELECT county_name AS geo_id,
           ST_SIMPLIFY(county_geom, 100) AS geo
    FROM
      `bigquery-public-data.geo_us_boundaries.counties`
    WHERE
      state_fips_code = "36"  -- New York State
      AND county_name IN ("Queens", "Kings", "New York")
  ),
  ['electric_vehicle_charging_station'], -- target_types array
  JSON_OBJECT(
    'geography_radius', 10000,
    'snapshot_date', '2026-01', -- Target snapshot month (YYYY-MM)
    'min_ev_charge_connector_count', 10, -- Look for a min amount of chargers
    'regular_opening_hours', JSON_OBJECT(
      'saturday', [JSON_OBJECT('start_time', '00:00', 'end_time', '23:59')], 'sunday', [JSON_OBJECT('start_time', '00:00', 'end_time', '23:59')]
    )
  )
);