

Visão geral
Ao lidar com grandes conjuntos de dados, transmitir dados brutos diretamente pelo modelo causa problemas: diminui a velocidade das respostas, aumenta os custos de token e introduz erros de raciocínio. Os dados de RMI podem abranger milhões de linhas. Portanto, permitir que o agente consulte uma quantidade ilimitada e ingira tudo para análise é caro em termos de tokens e aumenta a janela de contexto, degradando a performance do agente em todas as próximas interações.
Por exemplo, uma consulta na tabela historical_travel_time do RMI pode retornar milhares de linhas de trechos de via. Colocar o conjunto de resultados completo de volta no histórico de conversas deixa mais lento cada turno posterior, aumenta o custo e distrai o modelo da síntese da resposta final.
As instruções de comando sozinhas não resolvem esses problemas. A única abordagem confiável é interceptar chamadas de ferramentas e encaminhar grandes payloads de dados para fora da janela de contexto do modelo.
Callbacks de ferramentas do ADK
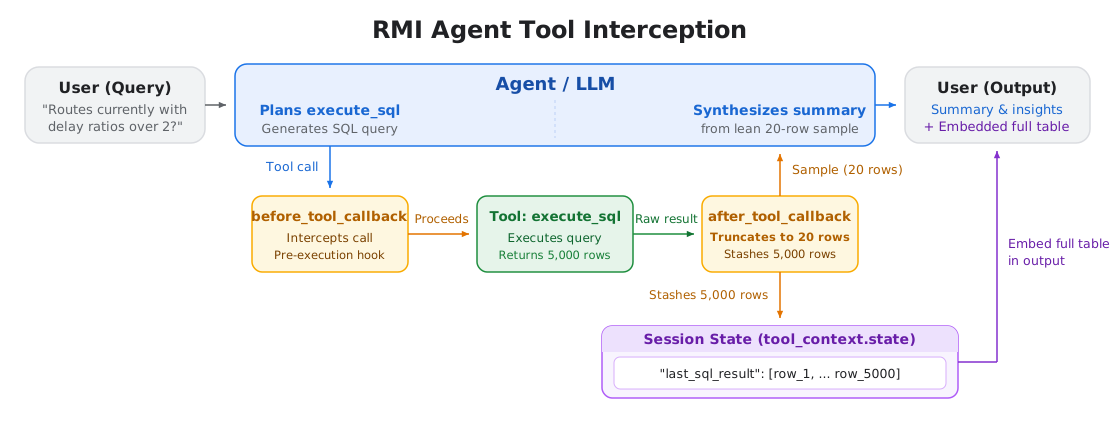
O ADK oferece ganchos de callback para interceptar a execução da ferramenta. Para processar grandes conjuntos de resultados, use after_tool_callback:
before_tool_callback(tool, args, tool_context): é executado depois que o modelo seleciona uma ferramenta, mas antes da execução dela.after_tool_callback(tool, args, tool_context, tool_response): é executado depois que a ferramenta termina, mas antes que o resultado volte para o modelo. Use-o para modificar a resposta da ferramenta.
O callback recebe um objeto tool_context com acesso à sessão state.
Isso permite armazenar grandes conjuntos de dados na memória em segundo plano em vários turnos de conversa sem colocá-los no comando do modelo.
# root_agent = llm_agent.Agent(
#     ...,
#     after_tool_callback=stash_and_truncate_results,
# )
Truncagem e armazenamento pós-execução
Objetivo: mostrar ao modelo uma pequena amostra de resultados de consultas para tomada de decisões, salvando o conjunto de dados completo para a saída final.
Para o agente RMI, um after_tool_callback intercepta os resultados de execute_sql,
salva a lista completa de linhas no estado da sessão e retorna uma pequena amostra junto
com a contagem total de linhas:
def stash_and_truncate_results(tool, args, tool_context, tool_response):
  if tool.name == "execute_sql" and "rows" in tool_response:
    rows = tool_response["rows"]
    tool_context.state["last_sql_result"] = rows      # keep everything
    tool_response["total_rows_fetched"] = len(rows)
    tool_response["rows"] = rows[:SAMPLE_LIMIT]        # show a sample
    tool_response["message"] = (
        f"Showing {SAMPLE_LIMIT} of {len(rows)} rows. "
        "Full result stashed in background state."
    )
  return tool_response
Retornar uma amostra reduz os tokens de entrada em todas as conversas futuras, diminuindo os custos e os tempos de resposta. Isso também evita que resultados de consultas grandes sobrecarreguem a janela de contexto e prejudiquem a capacidade do modelo de seguir instruções.
Verifique se o comando do agente explica explicitamente que as ferramentas retornam uma amostra por design. Sem esse contexto, o modelo pode ficar confuso com dados parciais, desperdiçando tokens de computação e raciocínio ao tentar conciliar registros ausentes ou iniciar chamadas de ferramentas redundantes para buscar o restante.
Exemplo: processar um grande conjunto de resultados
- O usuário pergunta "Quais rotas têm taxas de atraso acima de 2 agora?"
- A consulta do agente em
historical_travel_timeretorna milhares de linhas. - O
after_tool_callbacksalva o resultado completo no estado da sessão e retorna apenas uma pequena amostra mais a contagem total de linhas. - O modelo analisa essa amostra para criar o resumo.
- O aplicativo ou as ferramentas downstream leem o conjunto de dados completo diretamente do estado da sessão para renderizar a tabela completa ou exportar para o usuário.
Pontos principais
- Não use payloads grandes em comandos: armazene grandes conjuntos de dados no estado da sessão em vez de transmiti-los de um lado para o outro pelo histórico de comandos.
- Truncar saídas de ferramentas grandes: use
after_tool_callbackpara retornar pequenas amostras ao modelo e salvar os resultados completos no estado da sessão. - Informe o modelo sobre as amostras: adicione uma regra de solicitação explicando que os resultados são amostrados para evitar confusão no modelo, desperdício de tokens de raciocínio e chamadas de ferramentas redundantes.
Próximas etapas
- Referência de callbacks do ADK: leia o guia oficial de callbacks do ADK para detalhes sobre interceptação no nível do modelo, do agente e da ferramenta.
Colaboradores
Nathaniel Thomas | Estagiário de engenharia de software, Plataforma Google Maps