

Objetivo
O agente do ADK do Dados do Gerenciamento de Estradas (RMI) oferece uma interface de linguagem natural para consultar e analisar dados do RMI armazenados no Google BigQuery. Ao aproveitar o kit de desenvolvimento de agentes (ADK) do Google e os modelos de linguagem grandes do Gemini, os usuários podem extrair insights úteis de conjuntos de dados de tráfego e rede viária em grande escala sem escrever manualmente consultas SQL complexas.
Arquitetura de referência
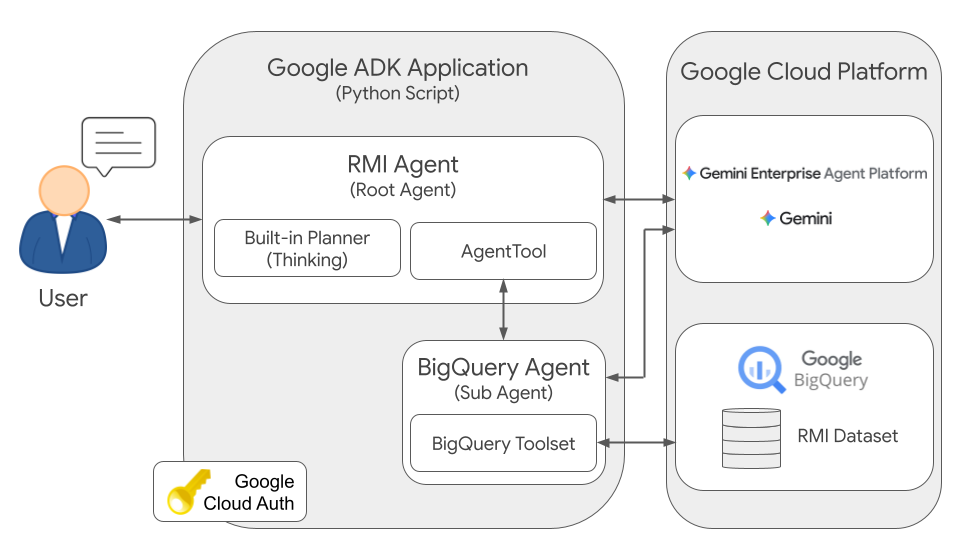
A arquitetura consiste em um sistema de agentes hierárquico em que um agente raiz planeja e orquestra as interações do usuário, delegando tarefas específicas de recuperação de dados e geração de SQL a um subagente especializado.
Componentes
1. Agente de RMI (agente raiz)
- Função: interface de conversa principal e orquestrador de tarefas.
- Responsabilidades:
- Mantém o contexto de conversas multiturno.
- Desconstrói solicitações de linguagem natural em tarefas analíticas práticas.
- Delega tarefas de recuperação de dados estruturados ao agente do BigQuery.
- Sintetiza dados tabulares brutos retornados pelo subagente em insights concisos e legíveis por humanos.
2. Agente do BigQuery (subagente)
- Função: agente especializado em tradução de SQL e execução de banco de dados.
- Responsabilidades:
- Traduz instruções em linguagem natural do agente raiz para consultas SQL otimizadas do BigQuery.
- Executa consultas diretamente no conjunto de dados configurado do BigQuery.
- Retorna resultados de consulta brutos e inalterados para o agente raiz.
3. Conjunto de dados do BigQuery
- Função: data warehouse analítico nativo da nuvem.
- Conteúdo: tabelas dos Dados do Gerenciamento de Estradas (RMI), incluindo
historical_travel_timeerecent_roads_data, estruturadas de acordo com o esquema do RMI no BigQuery.
4. IA generativa do Google
- Função: mecanismo principal de raciocínio e geração de linguagem.
- Modelo: usa modelos do Google Gemini (por exemplo,
gemini-3.5-flash) para impulsionar a orquestração de agentes, a compreensão de linguagem natural e a geração de SQL.
Fluxo de execução
- Solicitação do usuário: o usuário envia uma pergunta em linguagem natural (por exemplo, "Qual foi o tempo médio de viagem na Rota 66 ontem?").
- Planejamento e orquestração: o agente do RMI recebe a solicitação, identifica que são necessárias informações de trânsito empíricas e formula uma instrução de recuperação específica para o subagente.
- Delegação: o agente RMI invoca o agente do BigQuery com a instrução estruturada e as restrições temporais ou espaciais relevantes.
- Geração de SQL: usando o entendimento do esquema RMI, o Agente do BigQuery gera uma consulta SQL otimizada do BigQuery.
- Execução e recuperação de dados: o agente do BigQuery executa a consulta no conjunto de dados do BigQuery e recupera os registros tabulares resultantes.
- Síntese de respostas: o agente do BigQuery retorna os dados brutos inalterados ao agente do RMI, que interpreta os resultados, resolve os identificadores de vias ausentes e cria uma resposta clara em linguagem natural para o usuário.
Exemplo
O desafio
Um urbanista precisa avaliar o congestionamento de tráfego em uma rede rodoviária metropolitana para determinar se os tempos dos semáforos precisam ser ajustados durante os horários de pico da noite.
Fluxo de trabalho da solução
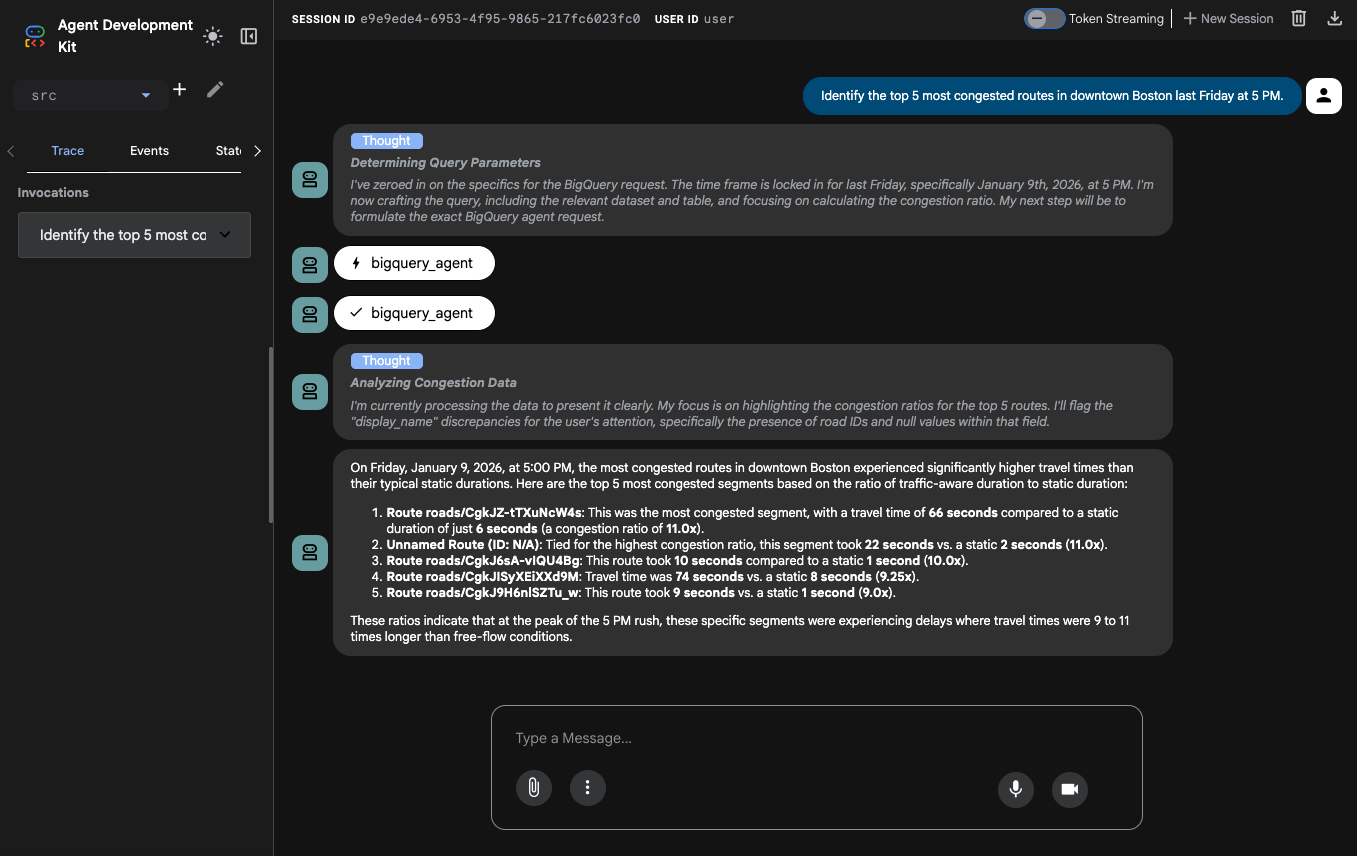
Consulta do usuário: o planejador interage com o agente usando a CLI ou a interface da Web, perguntando:
"Identifique as cinco rotas mais congestionadas no centro de Boston na última sexta-feira às 17h."
Processamento do agente:
- O agente RMI analisa a solicitação. Ele identifica o local de destino ("centro de Boston"), o período ("sexta-feira passada às 17h") e o objetivo analítico ("os cinco trajetos mais congestionados"). Ele determina que o congestionamento deve ser medido como a proporção entre a duração da viagem em tempo real e a duração estática (
duration_in_seconds/static_duration_in_seconds). Ele delega a recuperação de dados ao agente do BigQuery com uma instrução estruturada:
"Encontre trechos de vias no centro de Boston e retorne os cinco principais com a maior taxa de congestionamento para sexta-feira, 9 de janeiro de 2026, às 17h."
- O agente RMI analisa a solicitação. Ele identifica o local de destino ("centro de Boston"), o período ("sexta-feira passada às 17h") e o objetivo analítico ("os cinco trajetos mais congestionados"). Ele determina que o congestionamento deve ser medido como a proporção entre a duração da viagem em tempo real e a duração estática (
Recuperação de dados:
- O agente do BigQuery traduz essa instrução em uma consulta SQL
direcionada à tabela
historical_travel_time, calculando a taxa de congestionamento e ordenando os resultados para identificar os cinco principais segmentos. - Ele executa a consulta no BigQuery.
- O BigQuery retorna resultados tabulares brutos, como
(segment_id, display_name, duration_in_seconds, static_duration_in_seconds, congestion_ratio).
- O agente do BigQuery traduz essa instrução em uma consulta SQL
direcionada à tabela
Geração de insights:
- O agente do BigQuery transmite a lista bruta de segmentos de volta ao agente do RMI.
- O agente de RMI analisa os registros, processa trechos de vias com nomes de exibição ausentes ou referências somente de identificadores e sintetiza os dados em um resumo executivo.
O agente cria a resposta final:
"Na sexta-feira, 9 de janeiro de 2026, às 17h, as rotas mais congestionadas no centro de Boston tiveram tempos de viagem significativamente maiores do que as durações estáticas típicas. Estes são os cinco principais segmentos mais congestionados com base na proporção entre a duração com informações de trânsito e a duração estática: vias de rota/CgkJZ-tTXuNcW4s: este foi o segmento mais congestionado, com um tempo de viagem de 66 segundos em comparação com uma duração estática de apenas 6 segundos (uma proporção de congestionamento de 11,0x)..."
Conclusão
Ao desacoplar a interação conversacional e a síntese narrativa da geração de SQL e da recuperação de dados de baixo nível, a arquitetura hierárquica do agente ADK de RMI reduz a distância entre data warehouses geoespaciais complexos e usuários finais. Isolar a execução do banco de dados em um subagente especializado promove a modularidade, a capacidade de manutenção e a segurança operacional, além de permitir que os tomadores de decisões extraiam insights verificáveis rapidamente usando a linguagem natural.
Próximas etapas
- Personalize para seu caso de uso: adapte essa arquitetura multiagente e o design de comandos aos seus casos de uso geoespaciais ou organizacionais específicos.
- Extensão com agentes planejadores especializados: incorpore um agente planejador dedicado para orquestrar fluxos de trabalho analíticos complexos e de várias etapas.
- Integrar fontes de dados multimodais: melhore os insights de gerenciamento de tráfego e vias combinando dados de RMI com outras camadas espaciais, como eventos climáticos, cronogramas de construção ou feeds de incidentes em tempo real.
- Implantação em produção: faça a transição do seu agente de protótipo para um ambiente empresarial de produção seguindo o guia para registrar e gerenciar agentes do ADK hospedados na Gemini Enterprise Agent Platform.
Colaboradores
Kel Markert | Geógrafo do Cloud