

Panoramica
Quando si gestiscono set di dati di grandi dimensioni, il passaggio diretto dei dati non elaborati attraverso il modello causa problemi: rallenta le risposte, aumenta i costi dei token e introduce errori di ragionamento. I dati RMI possono estendersi su milioni di righe, quindi consentire all'agente di eseguire query su una quantità illimitata e di inserirli tutti per l'analisi è costoso in termini di token e gonfia la finestra contestuale, peggiorando le prestazioni dell'agente a ogni turno successivo.
Ad esempio, una query sulla tabella RMI historical_travel_time può restituire
migliaia di righe di segmenti stradali. L'inserimento dell'intero insieme di risultati nella cronologia della conversazione rallenta ogni turno successivo, aumenta i costi e distrae il modello dalla sintesi della risposta finale.
Le istruzioni del prompt da sole non possono risolvere questi problemi. L'unico approccio affidabile è intercettare le chiamate agli strumenti e indirizzare i payload di dati di grandi dimensioni al di fuori della finestra contestuale del modello.
Callback degli strumenti ADK
L'ADK fornisce hook di callback per intercettare l'esecuzione dello strumento. Per gestire set di risultati
di grandi dimensioni, utilizza after_tool_callback:
before_tool_callback(tool, args, tool_context): viene eseguito dopo che il modello seleziona uno strumento, ma prima che lo strumento venga eseguito.after_tool_callback(tool, args, tool_context, tool_response): viene eseguito dopo il completamento dello strumento, ma prima che il risultato venga restituito al modello. Usalo per modificare la risposta dello strumento.
Il callback riceve un oggetto tool_context con accesso alla sessione state.
In questo modo, puoi archiviare set di dati di grandi dimensioni nella memoria di background durante i turni di conversazione senza inserirli nel prompt del modello.
# root_agent = llm_agent.Agent(
#     ...,
#     after_tool_callback=stash_and_truncate_results,
# )
Troncamento e archiviazione post-esecuzione
Obiettivo: mostrare al modello un piccolo campione di risultati della query per il processo decisionale, salvando il set di dati completo per l'output finale.
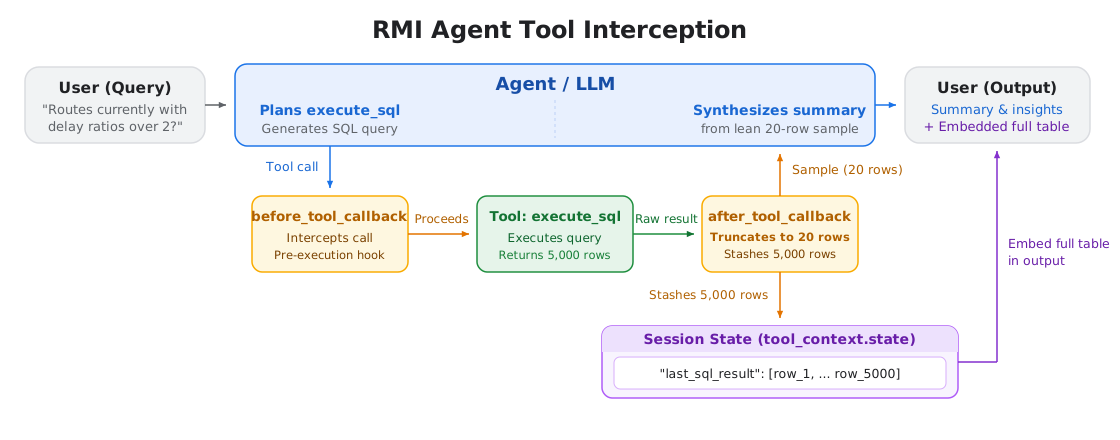
Per l'agente RMI, un after_tool_callback intercetta i risultati execute_sql,
salva l'elenco completo delle righe nello stato della sessione e restituisce un breve campione insieme
al conteggio totale delle righe:
def stash_and_truncate_results(tool, args, tool_context, tool_response):
  if tool.name == "execute_sql" and "rows" in tool_response:
    rows = tool_response["rows"]
    tool_context.state["last_sql_result"] = rows      # keep everything
    tool_response["total_rows_fetched"] = len(rows)
    tool_response["rows"] = rows[:SAMPLE_LIMIT]        # show a sample
    tool_response["message"] = (
        f"Showing {SAMPLE_LIMIT} of {len(rows)} rows. "
        "Full result stashed in background state."
    )
  return tool_response
Restituire un campione riduce i token di input in tutti i turni futuri, diminuendo i costi e i tempi di risposta. Inoltre, impedisce ai risultati di query di grandi dimensioni di affollare la finestra contestuale e di compromettere la capacità del modello di seguire le istruzioni.
Assicurati che il prompt dell'agente spieghi esplicitamente che gli strumenti restituiscono un campione per progettazione. Senza questo contesto, il modello può confondersi con dati parziali, sprecando token di calcolo e ragionamento per cercare di riconciliare i record mancanti o avviando chiamate di strumenti ridondanti per recuperare il resto.
Esempio: gestione di un set di risultati di grandi dimensioni
- L'utente chiede "Quali sono gli itinerari che hanno rapporti di ritardo superiori a 2 in questo momento?"
- La query dell'agente su
historical_travel_timerestituisce migliaia di righe. after_tool_callbacksalva il risultato completo nello stato della sessione e restituisce solo un piccolo campione più il conteggio totale delle righe.- Il modello esamina questo campione per comporre il riepilogo.
- L'applicazione o gli strumenti downstream leggono l'intero set di dati direttamente dallo stato della sessione per visualizzare la tabella completa o esportarla per l'utente.
Concetti chiave
- Evita payload di grandi dimensioni nei prompt: archivia i set di dati di grandi dimensioni nello stato della sessione anziché trasferirli avanti e indietro nella cronologia dei prompt.
- Tronca output di grandi dimensioni degli strumenti: utilizza
after_tool_callbackper restituire piccoli campioni al modello, salvando i risultati completi nello stato della sessione. - Informa il modello sugli esempi: aggiungi una regola del prompt che spieghi che i risultati vengono campionati per evitare confusione nel modello, token di ragionamento sprecati e chiamate di strumenti ridondanti.
Passaggi successivi
- Riferimento ai callback ADK: leggi la guida ai callback ADK ufficiale per informazioni dettagliate sull'intercettazione a livello di modello, agente e strumento.
Collaboratori
Nathaniel Thomas | Software Engineering Intern, Google Maps Platform