

Obiettivo
L'agente ADK Insight di gestione stradale (RMI) fornisce un'interfaccia in linguaggio naturale per eseguire query e analizzare i dati RMI archiviati in Google BigQuery. Sfruttando l'Agent Development Kit (ADK) di Google e i modelli LLM Gemini, consente agli utenti di estrarre informazioni utili da set di dati su larga scala relativi a reti stradali e traffico senza scrivere manualmente query SQL complesse.
Architettura di riferimento
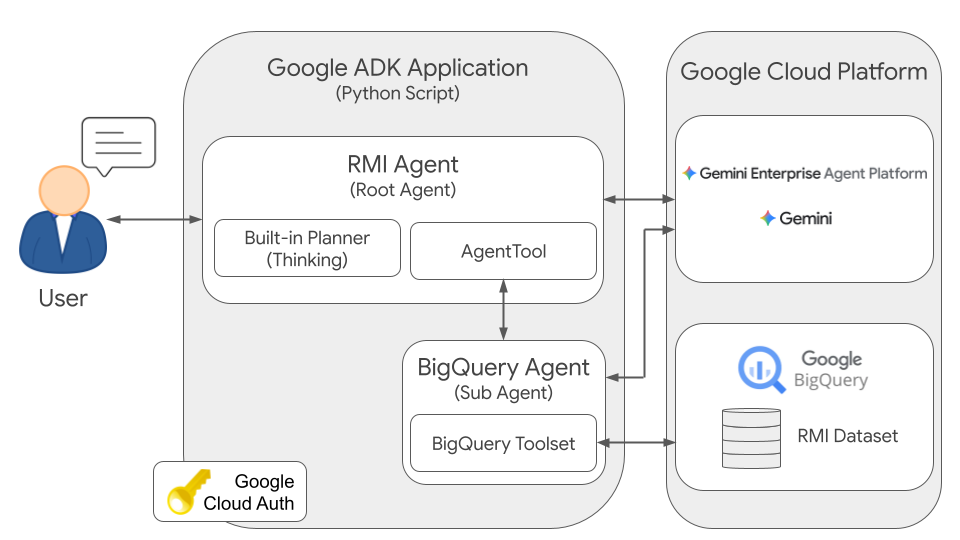
L'architettura è costituita da un sistema di agenti gerarchico in cui un agente principale pianifica e coordina le interazioni degli utenti, delegando il recupero di dati specifici e le attività di generazione di SQL a un sub-agente specializzato.
Componenti
1. Agente RMI (agente principale)
- Ruolo: interfaccia conversazionale principale e orchestratore di attività.
- Responsabilità:
- Mantiene il contesto delle conversazioni multi-turno.
- Scompone le richieste in linguaggio naturale in attività di analisi eseguibili.
- Delega le attività di recupero dei dati strutturati all'agente BigQuery.
- Sintetizza i dati tabellari non elaborati restituiti dal subagente in insight concisi e leggibili.
2. Agente BigQuery (agente secondario)
- Ruolo: agente specializzato per la traduzione SQL e l'esecuzione di database.
- Responsabilità:
- Traduce le istruzioni in linguaggio naturale dell'agente principale in query BigQuery SQL ottimizzate.
- Esegue query direttamente sul set di dati BigQuery configurato.
- Restituisce i risultati della query non elaborati e non modificati all'agente root.
3. Set di dati BigQuery
- Ruolo: data warehouse analitico cloud-native.
- Contenuti: tabelle Insight di gestione stradale (RMI), tra cui
historical_travel_timeerecent_roads_data, strutturate in base allo schema BigQuery RMI.
4. Google GenAI
- Ruolo: motore principale di ragionamento e generazione del linguaggio.
- Modello: utilizza i modelli Google Gemini (ad es.
gemini-3.5-flash) per potenziare l'orchestrazione degli agenti, la comprensione del linguaggio naturale e la generazione di SQL.
Flusso di esecuzione
- Richiesta dell'utente: l'utente invia una domanda in linguaggio naturale (ad es. "Qual è stato il tempo di percorrenza medio sulla Route 66 ieri?").
- Pianificazione e orchestrazione: l'agente RMI riceve la richiesta, identifica che sono necessari dati sul traffico empirici e formula un'istruzione di recupero specifica per l'agente secondario.
- Delega: l'agente RMI richiama l'agente BigQuery con le istruzioni strutturate e i vincoli temporali o spaziali pertinenti.
- Generazione di SQL: sfruttando la sua comprensione dello schema RMI, l'agente BigQuery genera una query SQL di BigQuery ottimizzata.
- Esecuzione e recupero dei dati: l'agente BigQuery esegue la query sul set di dati BigQuery sottostante e recupera i record tabulari risultanti.
- Sintesi della risposta: l'agente BigQuery restituisce i dati non elaborati all'agente RMI, che interpreta i risultati, risolve gli identificatori stradali mancanti e crea una risposta chiara in linguaggio naturale per l'utente.
Scenario di esempio
La sfida
Un urbanista deve valutare la congestione del traffico in una rete stradale metropolitana per determinare se i tempi dei semafori richiedono un aggiustamento durante le ore di punta del pendolarismo serale.
Workflow della soluzione
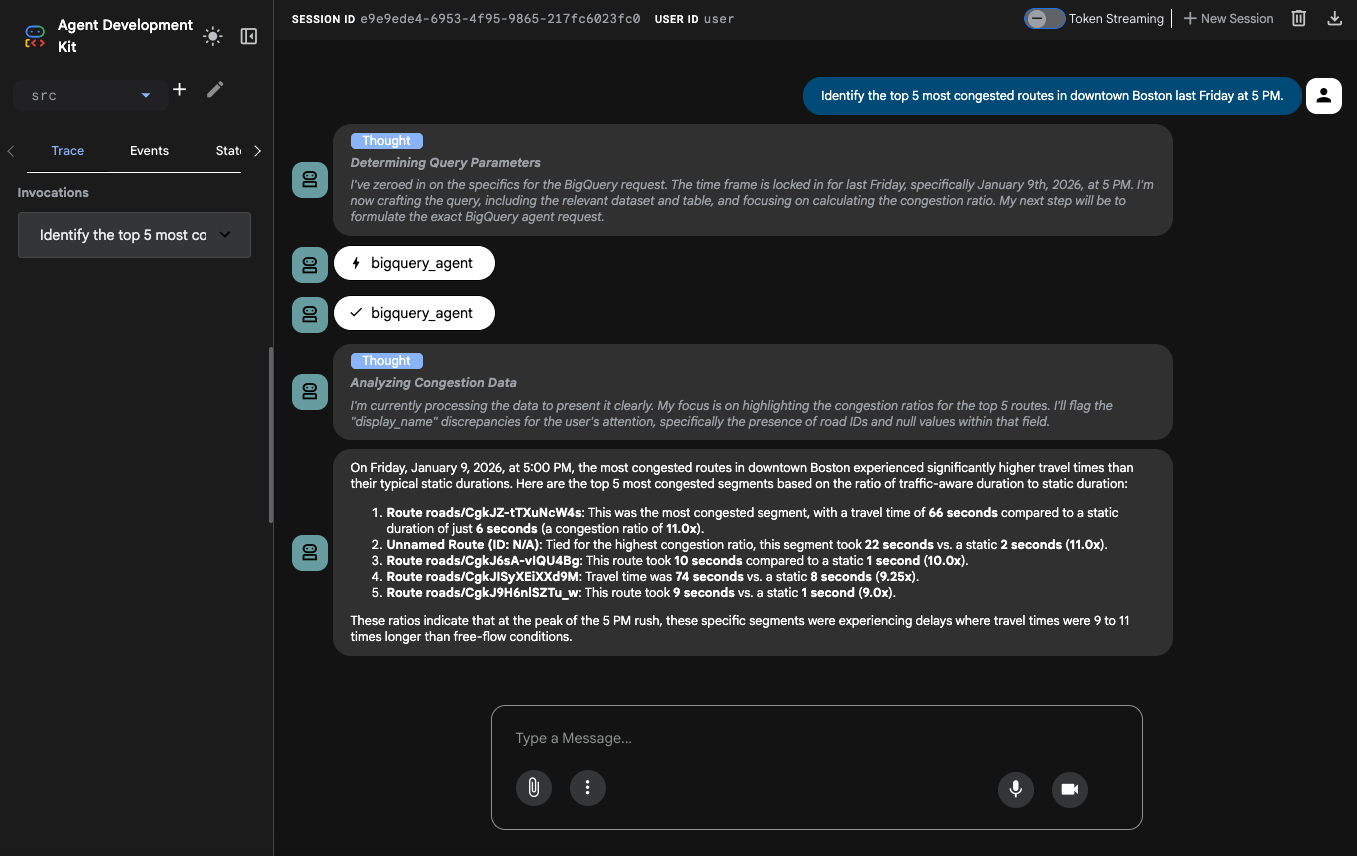
Query dell'utente: il pianificatore interagisce con l'agente utilizzando la CLI o l'interfaccia utente web, chiedendo:
"Identifica i 5 percorsi più congestionati nel centro di Boston venerdì scorso alle 17:00".
Agent Processing:
- L'agente RMI analizza la richiesta. Identifica la località di destinazione ("centro di Boston"), la finestra temporale ("venerdì scorso alle 17:00") e l'obiettivo analitico ("i 5 percorsi più trafficati"). Determina che
la "congestione" deve essere misurata come il rapporto tra la durata del viaggio in tempo reale
e la durata statica (
duration_in_seconds/static_duration_in_seconds). Delega il recupero dei dati all'agente BigQuery con un'istruzione strutturata:
"Trova i segmenti stradali nel centro di Boston e restituisci i primi 5 con il rapporto di congestione più elevato per venerdì 9 gennaio 2026 alle ore 17:00."
- L'agente RMI analizza la richiesta. Identifica la località di destinazione ("centro di Boston"), la finestra temporale ("venerdì scorso alle 17:00") e l'obiettivo analitico ("i 5 percorsi più trafficati"). Determina che
la "congestione" deve essere misurata come il rapporto tra la durata del viaggio in tempo reale
e la durata statica (
Recupero dei dati:
- L'agente BigQuery traduce questa istruzione in una query SQL
che ha come target la tabella
historical_travel_time, calcolando il rapporto di congestione e ordinando i risultati per identificare i primi 5 segmenti. - Esegue la query su BigQuery.
- BigQuery restituisce risultati tabulari non elaborati, ad esempio
(segment_id, display_name, duration_in_seconds, static_duration_in_seconds, congestion_ratio).
- L'agente BigQuery traduce questa istruzione in una query SQL
che ha come target la tabella
Generazione di insight:
- L'agente BigQuery trasmette l'elenco non elaborato dei segmenti all'agente RMI.
- L'agente RMI analizza i record, gestisce i segmenti stradali con nomi visualizzati mancanti o riferimenti solo identificativi e sintetizza i dati in un riepilogo.
L'agente crea la risposta finale:
"Venerdì 9 gennaio 2026, alle 17:00, i percorsi più congestionati del centro di Boston hanno registrato tempi di percorrenza significativamente più elevati rispetto alle loro durate statiche tipiche. Ecco i primi 5 segmenti più congestionati in base al rapporto tra la durata in base al traffico e la durata statica: Route roads/CgkJZ-tTXuNcW4s: questo è il segmento più congestionato, con un tempo di percorrenza di 66 secondi rispetto a una durata statica di soli 6 secondi (un rapporto di congestione di 11 volte)…"
Conclusione
Separando l'interazione conversazionale e la sintesi narrativa dalla generazione di SQL e dal recupero dei dati di basso livello, l'architettura dell'agente ADK RMI gerarchico colma il divario tra i complessi data warehouse di dati geospaziali e gli utenti finali. L'isolamento dell'esecuzione del database all'interno di un sub-agente specializzato promuove la modularità, la manutenibilità e la sicurezza operativa, consentendo ai responsabili delle decisioni di estrarre rapidamente insight verificabili tramite il linguaggio naturale.
Passaggi successivi
- Personalizzazione per il tuo caso d'uso: adatta questa architettura multi-agente e la progettazione dei prompt ai tuoi casi d'uso specifici a livello organizzativo o geospaziale.
- Estendi con agenti di pianificazione specializzati: incorpora un agente di pianificazione dedicato per orchestrare workflow analitici complessi in più fasi.
- Integra origini dati multimodali: arricchisci le informazioni sulla gestione del traffico e delle strade combinando i dati RMI con ulteriori livelli spaziali, come eventi meteorologici, programmi di costruzione o feed di incidenti in tempo reale.
- Deployment in produzione: esegui la transizione del tuo agente dal prototipo a un ambiente aziendale di produzione seguendo la guida per registrare e gestire gli agenti ADK ospitati su Gemini Enterprise Agent Platform.
Collaboratori
Kel Markert | Cloud Geographer