

Présentation
Lorsque vous traitez de grands ensembles de données, le fait de transmettre directement les données brutes au modèle pose problème : cela ralentit les réponses, augmente les coûts en jetons et introduit des erreurs de raisonnement. Les données RMI peuvent s'étendre sur des millions de lignes. Par conséquent, laisser l'agent interroger une quantité illimitée de données et les ingérer toutes pour analyse est coûteux en jetons et augmente la taille de la fenêtre de contexte, ce qui dégrade les performances de l'agent à chaque tour suivant.
Par exemple, une requête sur la table RMI historical_travel_time peut renvoyer des milliers de lignes de segments de route. Le fait de remettre l'ensemble complet des résultats dans l'historique des conversations ralentit chaque tour suivant, augmente les coûts et empêche le modèle de synthétiser la réponse finale.
Les instructions de requête seules ne peuvent pas résoudre ces problèmes. La seule approche fiable consiste à intercepter les appels d'outils et à acheminer les charges utiles de données volumineuses en dehors de la fenêtre de contexte du modèle.
Rappels d'outils ADK
ADK fournit des hooks de rappel pour intercepter l'exécution des outils. Pour gérer les grands ensembles de résultats, utilisez after_tool_callback :
before_tool_callback(tool, args, tool_context): s'exécute après que le modèle a sélectionné un outil, mais avant que l'outil ne s'exécute.after_tool_callback(tool, args, tool_context, tool_response): s'exécute une fois l'outil terminé, mais avant que le résultat ne soit renvoyé au modèle. Utilisez-le pour modifier la réponse de l'outil.
Le rappel reçoit un objet tool_context avec accès à la session state.
Cela vous permet de stocker de grands ensembles de données dans la mémoire en arrière-plan au fil des tours de conversation, sans les inclure dans l'invite du modèle.
# root_agent = llm_agent.Agent(
#     ...,
#     after_tool_callback=stash_and_truncate_results,
# )
Troncation et mise en cache post-exécution
Objectif : montrer au modèle un petit échantillon de résultats de requête pour la prise de décision, tout en conservant l'ensemble de données complet pour le résultat final.
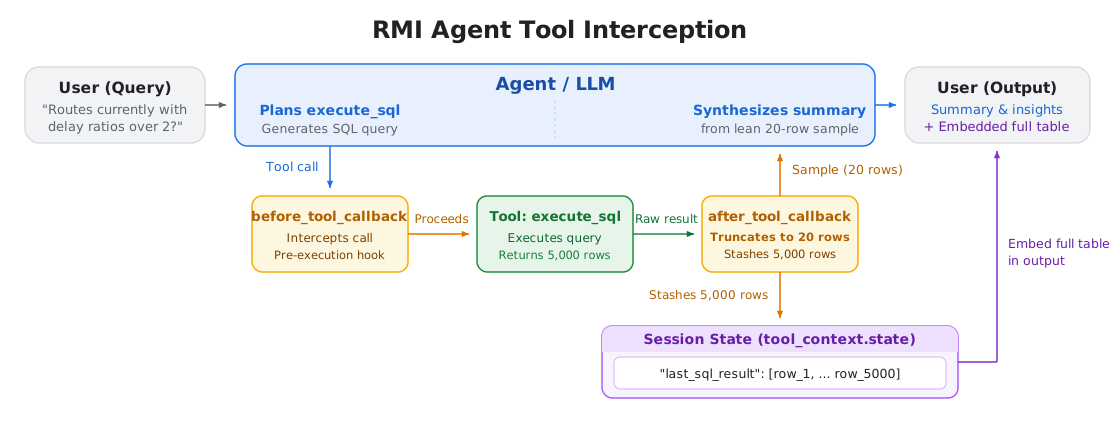
Pour l'agent RMI, un after_tool_callback intercepte les résultats execute_sql, enregistre la liste complète des lignes dans l'état de session et renvoie un court échantillon ainsi que le nombre total de lignes :
def stash_and_truncate_results(tool, args, tool_context, tool_response):
  if tool.name == "execute_sql" and "rows" in tool_response:
    rows = tool_response["rows"]
    tool_context.state["last_sql_result"] = rows      # keep everything
    tool_response["total_rows_fetched"] = len(rows)
    tool_response["rows"] = rows[:SAMPLE_LIMIT]        # show a sample
    tool_response["message"] = (
        f"Showing {SAMPLE_LIMIT} of {len(rows)} rows. "
        "Full result stashed in background state."
    )
  return tool_response
Le renvoi d'un échantillon réduit le nombre de jetons d'entrée pour tous les tours futurs, ce qui diminue les coûts et les temps de réponse. Cela empêche également les résultats de requête volumineux d'encombrer la fenêtre de contexte et de nuire à la capacité du modèle à suivre les instructions.
Assurez-vous que l'invite de votre agent explique explicitement que les outils renvoient un échantillon par conception. Sans ce contexte, le modèle peut être dérouté par des données partielles, ce qui gaspille des jetons de calcul et de raisonnement pour essayer de concilier les enregistrements manquants ou lancer des appels d'outils redondants pour récupérer le reste.
Exemple : Gérer un grand ensemble de résultats
- L'utilisateur demande "Quels sont les itinéraires dont le ratio de retard est supérieur à 2 en ce moment ?"
- La requête de l'agent sur
historical_travel_timerenvoie des milliers de lignes. after_tool_callbackenregistre le résultat complet dans l'état de la session et ne renvoie qu'un petit échantillon ainsi que le nombre total de lignes.- Le modèle raisonne sur cet échantillon pour composer son résumé.
- L'application ou les outils en aval lisent l'ensemble de données complet directement à partir de l'état de la session pour afficher le tableau complet ou l'exporter pour l'utilisateur.
Points à retenir
- Évitez d'inclure de grandes charges utiles dans les requêtes : stockez les grands ensembles de données dans l'état de la session au lieu de les transmettre dans l'historique des requêtes.
- Tronquer les sorties d'outils volumineuses : utilisez
after_tool_callbackpour renvoyer de petits échantillons au modèle tout en enregistrant les résultats complets dans l'état de la session. - Informer le modèle sur les échantillons : ajoutez une règle d'invite expliquant que les résultats sont échantillonnés pour éviter toute confusion du modèle, tout gaspillage de jetons de raisonnement et tout appel d'outil redondant.
Étapes suivantes
- Documentation de référence sur les rappels ADK : consultez le guide officiel sur les rappels ADK pour en savoir plus sur l'interception au niveau du modèle, de l'agent et de l'outil.
Contributeurs
Nathaniel Thomas | Stagiaire en ingénierie logicielle, Google Maps Platform