

Objectif
L'agent ADK d'Insights de gestion des routes (RMI) fournit une interface en langage naturel pour interroger et analyser les données RMI stockées dans Google BigQuery. En s'appuyant sur l'Agent Development Kit (ADK) de Google et les grands modèles de langage Gemini, il permet aux utilisateurs d'extraire des insights pratiques à partir d'ensembles de données à grande échelle sur le réseau routier et le trafic, sans avoir à écrire manuellement des requêtes SQL complexes.
Architecture de référence
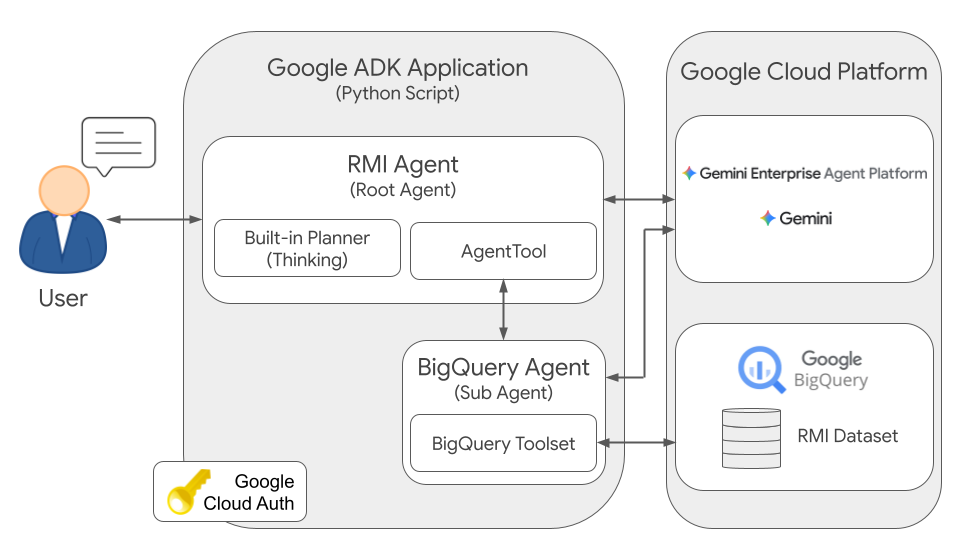
L'architecture se compose d'un système d'agents hiérarchique dans lequel un agent racine planifie et orchestre les interactions des utilisateurs, en déléguant des tâches spécifiques de récupération de données et de génération de code SQL à un sous-agent spécialisé.
Composants
1. Agent RMI (agent racine)
- Rôle : interface conversationnelle principale et orchestrateur de tâches.
- Responsabilités :
- Maintient le contexte de la conversation multitour.
- Décompose les requêtes en langage naturel en tâches analytiques exploitables.
- Délègue les tâches de récupération de données structurées à l'agent BigQuery.
- Synthétise les données tabulaires brutes renvoyées par le sous-agent en insights concis et lisibles par l'humain.
2. Agent BigQuery (sous-agent)
- Rôle : agent spécialisé dans la traduction SQL et l'exécution de bases de données.
- Responsabilités :
- Traduit les instructions en langage naturel de l'agent racine en requêtes SQL BigQuery optimisées.
- Exécute des requêtes directement sur l'ensemble de données BigQuery configuré.
- Renvoie les résultats bruts et non modifiés de la requête à l'agent racine.
3. Ensemble de données BigQuery
- Rôle : entrepôt de données d'analyse cloud natif.
- Contenu : tables Insights de gestion des routes (RMI), y compris
historical_travel_timeetrecent_roads_data, structurées selon le schéma BigQuery RMI.
4. IA générative de Google
- Rôle : moteur principal de raisonnement et de génération de langage.
- Modèle : exploite les modèles Google Gemini (par exemple,
gemini-3.5-flash) pour optimiser l'orchestration des agents, la compréhension du langage naturel et la génération de code SQL.
Flux d'exécution
- Requête utilisateur : l'utilisateur envoie une question en langage naturel (par exemple, "Quel était le temps de trajet moyen sur la Route 66 hier ?").
- Planification et orchestration : l'agent RMI reçoit la requête, identifie que des données empiriques sur le trafic sont requises et formule une instruction de récupération spécifique pour le sous-agent.
- Délégation : l'agent RMI appelle l'agent BigQuery avec l'instruction structurée et les contraintes temporelles ou spatiales pertinentes.
- Génération de code SQL : en s'appuyant sur sa compréhension du schéma RMI, l'agent BigQuery génère une requête SQL BigQuery optimisée.
- Exécution et récupération des données : l'agent BigQuery exécute la requête sur l'ensemble de données BigQuery sous-jacent et récupère les enregistrements tabulaires obtenus.
- Synthèse de la réponse : l'agent BigQuery renvoie les données brutes non modifiées à l'agent RMI, qui interprète les résultats, résout les identifiants de route manquants et construit une réponse claire en langage naturel pour l'utilisateur.
Exemple de scénario
Le défi
Un urbaniste doit évaluer les embouteillages sur un réseau routier métropolitain pour déterminer si les feux de circulation doivent être ajustés pendant les heures de pointe du soir.
Workflow de la solution
Requête utilisateur : le planificateur interagit avec l'agent à l'aide de la CLI ou de l'interface utilisateur Web, en demandant :
"Identifie les cinq itinéraires les plus encombrés dans le centre-ville de Boston vendredi dernier à 17h."
Traitement par l'agent :
- L'agent RMI analyse la requête. Elle identifie l'emplacement cible ("centre-ville de Boston"), la période ("vendredi dernier à 17h") et l'objectif analytique ("les cinq itinéraires les plus encombrés"). Il détermine que la "congestion" doit être mesurée comme le rapport entre la durée du trajet en temps réel et la durée statique (
duration_in_seconds/static_duration_in_seconds). Il délègue la récupération des données à l'agent BigQuery avec une instruction structurée :
"Trouve les segments de route dans le centre-ville de Boston et renvoie les cinq segments présentant le taux de congestion le plus élevé le vendredi 9 janvier 2026 à 17h00."
- L'agent RMI analyse la requête. Elle identifie l'emplacement cible ("centre-ville de Boston"), la période ("vendredi dernier à 17h") et l'objectif analytique ("les cinq itinéraires les plus encombrés"). Il détermine que la "congestion" doit être mesurée comme le rapport entre la durée du trajet en temps réel et la durée statique (
Récupération des données :
- L'agent BigQuery traduit cette instruction en une requête SQL ciblant la table
historical_travel_time, calculant le taux de congestion et classant les résultats pour identifier les cinq segments les plus congestionnés. - Elle exécute la requête sur BigQuery.
- BigQuery renvoie des résultats tabulaires bruts, tels que
(segment_id, display_name, duration_in_seconds, static_duration_in_seconds, congestion_ratio).
- L'agent BigQuery traduit cette instruction en une requête SQL ciblant la table
Génération d'insights :
- L'agent BigQuery renvoie la liste brute des segments à l'agent RMI.
- L'agent RMI analyse les enregistrements, gère les segments de route dont le nom à afficher est manquant ou qui ne comportent que des références d'identifiant, et synthétise les données dans un résumé.
L'agent construit la réponse finale :
"Le vendredi 9 janvier 2026 à 17h, les temps de trajet sur les itinéraires les plus encombrés du centre-ville de Boston étaient nettement plus élevés que les durées statiques habituelles. Voici les cinq segments les plus encombrés, d'après le ratio entre la durée tenant compte du trafic et la durée statique : Route roads/CgkJZ-tTXuNcW4s : il s'agit du segment le plus encombré, avec un temps de trajet de 66 secondes contre une durée statique de seulement 6 secondes (ratio d'encombrement de 11,0x)..."

Conclusion
En dissociant l'interaction conversationnelle et la synthèse narrative de la génération SQL de bas niveau et de la récupération des données, l'architecture hiérarchique de l'agent ADK RMI comble l'écart entre les entrepôts de données géospatiales complexes et les utilisateurs finaux. Isoler l'exécution de la base de données dans un sous-agent spécialisé favorise la modularité, la facilité de maintenance et la sécurité opérationnelle, tout en permettant aux décideurs d'extraire rapidement des insights vérifiables en langage naturel.
Étapes suivantes
- Personnaliser pour votre cas d'utilisation : adaptez cette architecture multi-agent et cette conception de requêtes à vos cas d'utilisation géospatiaux ou organisationnels spécifiques.
- Étendre avec des agents de planification spécialisés : intégrez un agent de planification dédié pour orchestrer des workflows d'analyse complexes en plusieurs étapes.
- Intégrer des sources de données multimodales : enrichissez les insights sur la gestion du trafic et des routes en combinant les données RMI avec des couches spatiales supplémentaires telles que les événements météorologiques, les calendriers de travaux ou les flux d'incidents en direct.
- Déployer en production : faites passer votre agent du prototype à un environnement d'entreprise de production en suivant le guide pour enregistrer et gérer les agents ADK hébergés sur Gemini Enterprise Agent Platform.
Contributeurs
Kel Markert | Cloud Geographer