
इस दस्तावेज़ में, Places Insights से मिले जगह के आईडी के सैंपल डेटा का इस्तेमाल करने का तरीका बताया गया है. इसके लिए, जगह की संख्या बताने वाले फ़ंक्शन और टारगेट किए गए जगह की जानकारी लुकअप का इस्तेमाल किया जाता है, ताकि आपको अपने नतीजों पर भरोसा हो सके.
इस पैटर्न को लागू करने के बारे में ज़्यादा जानने के लिए, यह जानकारी देने वाली नोटबुक देखें:
 Google Colab में चलाएं
 GitHub पर सोर्स देखें
आर्किटेक्चरल पैटर्न
इस आर्किटेक्चरल पैटर्न से, आपको एक ऐसा वर्कफ़्लो मिलता है जिसे बार-बार इस्तेमाल किया जा सकता है. इससे, आपको हाई-लेवल के स्टैटिस्टिकल विश्लेषण और ग्राउंड-ट्रुथ की पुष्टि के बीच के अंतर को कम करने में मदद मिलती है. BigQuery की मदद से बड़े पैमाने पर डेटा को प्रोसेस किया जा सकता है. साथ ही, Places API से सटीक जानकारी मिलती है. इन दोनों को मिलाकर, विश्लेषण के नतीजों की पुष्टि आसानी से की जा सकती है. यह खास तौर पर, साइट चुनने, प्रतिस्पर्धी कारोबार का विश्लेषण करने, और मार्केट रिसर्च के लिए फ़ायदेमंद है. इन कामों में, डेटा पर भरोसा करना सबसे ज़रूरी होता है.
इस पैटर्न में चार मुख्य चरण शामिल हैं:
- बड़े पैमाने पर विश्लेषण करना: BigQuery में जगहों की अहम जानकारी का जगह की गिनती करने वाला फ़ंक्शन इस्तेमाल करें. इससे किसी बड़े इलाके, जैसे कि पूरे शहर या क्षेत्र के डेटा का विश्लेषण किया जा सकता है.
- सैंपल अलग करना और निकालना: एग्रीगेट किए गए नतीजों से, दिलचस्पी वाले क्षेत्रों (जैसे कि ज़्यादा घनत्व वाले "हॉटस्पॉट") की पहचान करें. साथ ही, फ़ंक्शन से मिले
sample_place_idsको निकालें. - ग्राउंड-ट्रुथ की जानकारी पाना: निकाले गए जगह के आईडी का इस्तेमाल करके, Place Details API को टारगेट किए गए कॉल करें. इससे हर जगह के बारे में ज़्यादा जानकारी और असल दुनिया से जुड़ी जानकारी मिलेगी.
- कंबाइंड विज़ुअलाइज़ेशन बनाएं: जगह की जानकारी वाले डेटा को शुरुआती हाई-लेवल के स्टैटिस्टिकल मैप के ऊपर लेयर करें, ताकि यह विज़ुअली पुष्टि की जा सके कि एग्रीगेट किए गए काउंट, असल में मौजूद डेटा से मेल खाते हैं.
समस्या हल करने से जुड़ा वर्कफ़्लो
इस वर्कफ़्लो की मदद से, बड़े लेवल के रुझानों और छोटे लेवल के तथ्यों के बीच के अंतर को कम किया जा सकता है. इसकी शुरुआत, आंकड़ों वाले बड़े व्यू से होती है. इसके बाद, रणनीति के तहत डेटा की बारीकी से जांच की जाती है. ऐसा, असल दुनिया से जुड़े उदाहरणों की मदद से डेटा की पुष्टि करने के लिए किया जाता है.
Places Insights की मदद से, जगहों की संख्या का बड़े पैमाने पर विश्लेषण करना
सबसे पहले, आपको बड़े लेवल पर लैंडस्केप को समझना होगा. हज़ारों अलग-अलग दिलचस्पी की जगहों (पीओआई) की जानकारी पाने के बजाय, एक क्वेरी चलाकर आंकड़ों की खास जानकारी पाई जा सकती है.
इसके लिए, जगहों की अहम जानकारी PLACES_COUNT_PER_H3
फ़ंक्शन
सबसे सही है. यह पीओआई की संख्या को षट्कोणीय ग्रिड सिस्टम (H3) में इकट्ठा करता है.इससे आपको अपनी खास शर्तों के आधार पर, ज़्यादा या कम घनत्व वाले इलाकों की पहचान करने में मदद मिलती है. उदाहरण के लिए, ज़्यादा रेटिंग वाले ऐसे रेस्टोरेंट जो खुले हैं.
क्वेरी का एक उदाहरण यहां दिया गया है. ध्यान दें कि आपको खोज के लिए चुने गए इलाके की जानकारी देनी होगी. भौगोलिक सीमा का डेटा पाने के लिए, Overture Maps Data जैसे सावर्जनिक तौर पर उपलब्ध डेटासेट का इस्तेमाल किया जा सकता है. यह BigQuery का सार्वजनिक डेटासेट है.
हमारा सुझाव है कि अक्सर इस्तेमाल की जाने वाली सावर्जनिक तौर पर उपलब्ध डेटासेट की सीमाओं को अपने प्रोजेक्ट की टेबल में सेव करें. इससे BigQuery की लागत काफ़ी कम हो जाती है और क्वेरी की परफ़ॉर्मेंस बेहतर हो जाती है.
-- This query counts all highly-rated, operational restaurants
-- across a large geography, grouping them into H3 cells.
SELECT *
FROM
  `places_insights___gb.PLACES_COUNT_PER_H3`(
    JSON_OBJECT(
      'geography', your_defined_geography,
      'h3_resolution', 8,
      'types', ['restaurant'],
      'business_status', ['OPERATIONAL'],
      'min_rating', 3.5
    )
  );
ब्रैंड आईडी के हिसाब से फ़िल्टर करना और पुष्टि करना
अगर आपको किसी ब्रैंड के लिए, जगह के आईडी की संख्या और सैंपल की पुष्टि करनी है, तो brand_ids फ़िल्टर का इस्तेमाल करके, ब्रैंड आईडी की सूची उपलब्ध कराएं.
टारगेट ब्रैंड के लिए ब्रैंड आईडी पाने के लिए, BigQuery में मौजूद brands टेबल को क्वेरी करें:
SELECT id, name
FROM `YOUR_PROJECT.places_insights___us.brands`
WHERE LOWER(name) LIKE "%starbucks%";
टारगेट ब्रैंड आईडी (उदाहरण के लिए, "1413758728321880760"
Starbucks के लिए) पाने के बाद, इसे brand_ids फ़िल्टर ऐरे में पास करें:
SELECT *
FROM
  `places_insights___us.PLACES_COUNT_PER_H3`(
    JSON_OBJECT(
      'geography', your_defined_geography,
      'h3_resolution', 8,
      'brand_ids', ["1413758728321880760"]
    )
  );
तीसरे चरण में, ग्राउंड-ट्रुथ की पुष्टि के दौरान, यह पुष्टि करने के बजाय कि कोई जगह सामान्य कैटगरी से मेल खाती है, प्रोग्राम के हिसाब से Place Details API से मिले डिसप्ले नेम की तुलना, अपने ब्रैंड के नाम से की जा सकती है. इसके लिए, रेगुलर एक्सप्रेशन मैच का इस्तेमाल करें. उदाहरण के लिए, response.display_name.text फ़ील्ड की तुलना की जा सकती है.
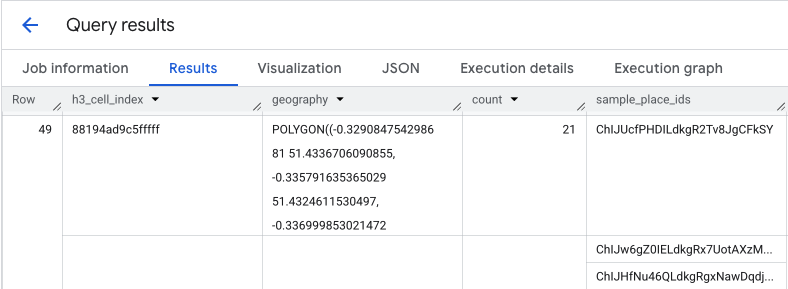
इस क्वेरी के आउटपुट में, आपको H3 सेल और हर सेल में मौजूद जगहों की संख्या वाली टेबल मिलती है. इससे डेंसिटी हीटमैप बनाने में मदद मिलती है.
हॉटस्पॉट अलग करना और जगह के आईडी के सैंपल निकालना
PLACES_COUNT_PER_H3 फ़ंक्शन से मिले नतीजे में, sample_place_ids का एक ऐरे भी दिखता है. इसमें जवाब के हर एलिमेंट के लिए, ज़्यादा से ज़्यादा 250 प्लेस आईडी होते हैं. ये आईडी, एग्रीगेट किए गए आंकड़ों को उन जगहों से लिंक करते हैं जिनसे ये आंकड़े मिले हैं.
आपका सिस्टम, शुरुआती क्वेरी के आधार पर सबसे काम की सेल की पहचान कर सकता है.
उदाहरण के लिए, सबसे ज़्यादा संख्या वाली टॉप 20 सेल चुनी जा सकती हैं. इसके बाद, इन हॉटस्पॉट से sample_place_ids को एक ही सूची में इकट्ठा करें.
इस सूची में, सबसे काम की जगहों के सबसे दिलचस्प पीओएस का चुना गया सैंपल शामिल होता है. इससे आपको टारगेट की गई पुष्टि के लिए तैयार होने में मदद मिलती है.
अगर BigQuery के नतीजों को Python में pandas DataFrame का इस्तेमाल करके प्रोसेस किया जा रहा है, तो इन आईडी को निकालने का तरीका आसान है:
# Assume 'results_df' is a pandas DataFrame from your BigQuery query.

# 1. Identify the 20 busiest H3 cells by sorting and taking the top results.
top_hotspots_df = results_df.sort_values(by='count', ascending=False).head(20)

# 2. Extract and flatten the lists of sample_place_ids from these hotspots.
# The .explode() function creates a new row for each ID in the lists.
all_sample_ids = top_hotspots_df['sample_place_ids'].explode()

# 3. Create a final list of unique Place IDs to verify.
place_ids_to_verify = all_sample_ids.unique().tolist()

print(f"Consolidated {len(place_ids_to_verify)} unique Place IDs for spot-checking.")
अगर अन्य प्रोग्रामिंग भाषाओं का इस्तेमाल किया जा रहा है, तो इसी तरह का लॉजिक लागू किया जा सकता है.
Places API की मदद से, ग्राउंड-ट्रुथ की जानकारी पाना
जगह के आईडी की एक साथ दी गई सूची की मदद से, अब बड़े पैमाने पर विश्लेषण करने के बजाय, खास डेटा को वापस पाया जा सकता है. इन आईडी का इस्तेमाल करके, Place Details API से हर सैंपल लोकेशन के बारे में ज़्यादा जानकारी के लिए क्वेरी की जाएगी.
पुष्टि करने का यह एक ज़रूरी चरण है. जगहों के बारे में अहम जानकारी देने वाली सुविधा से आपको यह पता चलता था कि किसी इलाके में कितने रेस्टोरेंट हैं. वहीं, Places API से आपको यह पता चलता है कि वे कौनसे रेस्टोरेंट हैं. साथ ही, आपको उनके नाम, पूरा पता, अक्षांश/देशांतर, उपयोगकर्ता रेटिंग, और Google Maps पर उनकी जगह की जानकारी का डायरेक्ट लिंक भी मिलता है. इससे आपके सैंपल डेटा को बेहतर बनाया जाता है. साथ ही, ऐब्सट्रैक्ट आईडी को ऐसी जगहों में बदला जाता है जिनकी पुष्टि की जा सकती है.
Place Details API से उपलब्ध डेटा की पूरी सूची और उसे वापस पाने से जुड़ी लागत के बारे में जानने के लिए, एपीआई का दस्तावेज़ पढ़ें.
Python क्लाइंट लाइब्रेरी का इस्तेमाल करके, किसी आईडी के लिए Places API को किया गया अनुरोध इस तरह दिखेगा. ज़्यादा जानकारी के लिए, Places API (New) की क्लाइंट लाइब्रेरी के उदाहरण देखें.
# A request to fetch details for a single Place ID.
request = {"name": f"places/{place_id}"}

# Define the fields you want returned in the response as a comma-separated string.
fields_to_request = "formattedAddress,location,displayName,googleMapsUri"

# The response contains ground truth data.
response = places_client.get_place(
    request=request,
    metadata=[("x-goog-fieldmask", fields_to_request)]
)
ध्यान दें कि इस अनुरोध में मौजूद फ़ील्ड, दो अलग-अलग बिलिंग एसकेयू से डेटा पुल करते हैं.
formattedAddressऔरlocation, Place Details Essentials SKU का हिस्सा हैं.displayNameऔरgoogleMapsUri, जगह की जानकारी देने वाले Place Details Pro SKU का हिस्सा हैं.
जब Place Details के लिए किए गए किसी अनुरोध में, एक से ज़्यादा एसकेयू के फ़ील्ड शामिल होते हैं, तो पूरे अनुरोध का बिल सबसे ऊंचे टियर वाले एसकेयू की दर से लिया जाता है. इसलिए, इस कॉल के लिए Place Details Pro के अनुरोध के तौर पर बिल भेजा जाएगा.
लागत को कंट्रोल करने के लिए, हमेशा FieldMask का इस्तेमाल करें. इससे सिर्फ़ उन फ़ील्ड के लिए अनुरोध किया जा सकेगा जिनकी आपके ऐप्लिकेशन को ज़रूरत है.
पुष्टि करने के लिए, एक कंबाइंड विज़ुअलाइज़ेशन बनाना
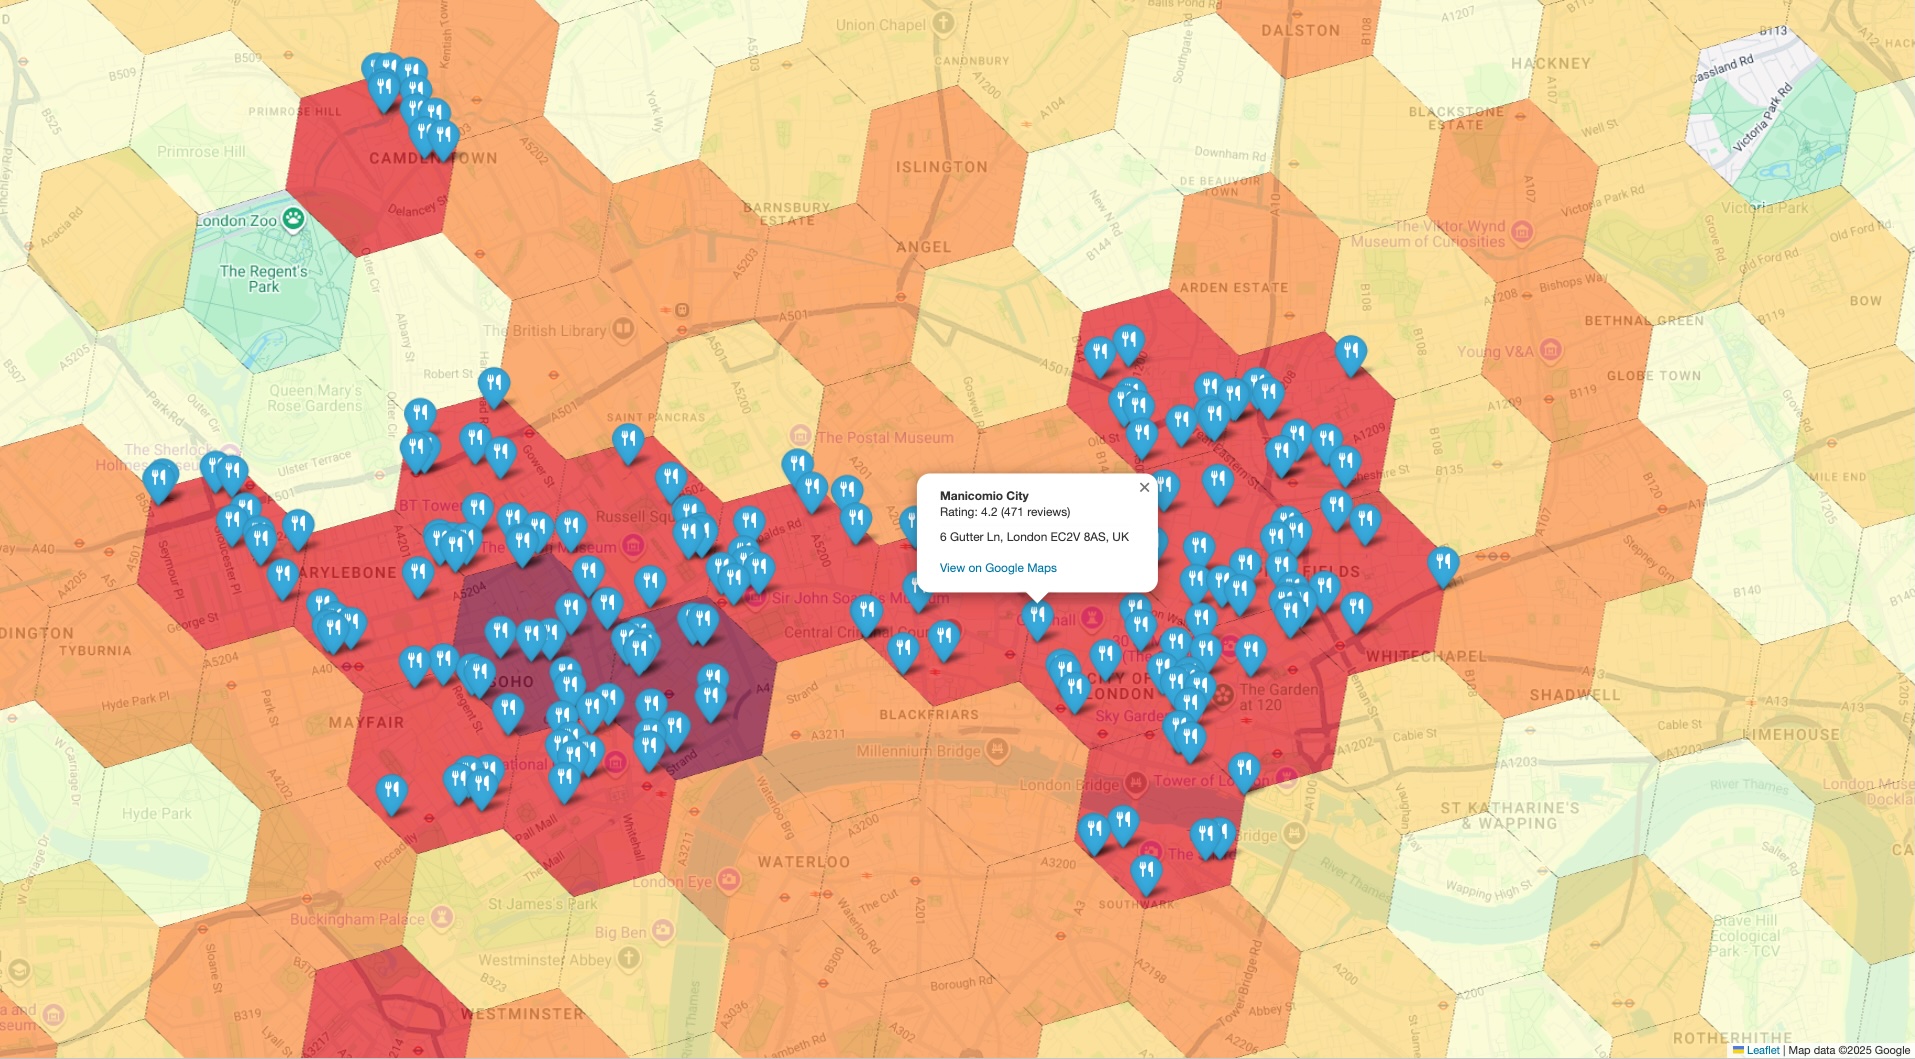
आखिरी चरण में, दोनों डेटासेट को एक ही व्यू में लाया जाता है. इससे, शुरुआती विश्लेषण की तुरंत और आसानी से जांच की जा सकती है. आपके विज़ुअलाइज़ेशन में दो लेयर होनी चाहिए:
- बेस लेयर: यह शुरुआती
PLACES_COUNT_PER_H3नतीजों से जनरेट किया गया कोरोप्लेथ या हीटमैप होता है. इसमें आपकी भौगोलिक स्थिति के हिसाब से, जगहों की कुल डेंसिटी दिखाई जाती है. - सबसे ऊपर वाली लेयर: इसमें हर सैंपल POI के लिए अलग-अलग मार्कर का सेट होता है. इन्हें पिछले चरण में Places API से मिले सटीक कोऑर्डिनेट का इस्तेमाल करके प्लॉट किया जाता है.
इस इमेज में, ऑफ़िस और निजी कामों की जानकारी को साथ में दिखाने के लिए इस्तेमाल किया गया लॉजिक दिखाया गया है.
# Assume 'h3_density_data' is your aggregated data from Step 1.
# Assume 'detailed_places_data' is your list of place objects from Step 3.

# Create the base choropleth map from the H3 density data.
# The 'count' column determines the color of each hexagon.
combined_map = create_choropleth_map(
    data=h3_density_data,
    color_by_column='count'
)

# Iterate through the detailed place data to add individual markers.
for place in detailed_places_data:
    # Construct the popup information with key details and a link.
    popup_html = f"""
    <b>{place.name}</b><br>
    Address: {place.address}<br>
    <a href="{place.google_maps_uri}" target="_blank">View on Maps</a>
    """

    # Add a marker for the current place to the base map.
    combined_map.add_marker(
        location=[place.latitude, place.longitude],
        popup=popup_html,
        tooltip=place.name
    )

# Display the final map with both layers.
display(combined_map)
ज़्यादा घनत्व वाले मैप पर, सटीक और भरोसेमंद मार्कर ओवरले करके, तुरंत पुष्टि की जा सकती है कि हॉटस्पॉट के तौर पर पहचाने गए इलाकों में, उन जगहों की संख्या ज़्यादा है जिनका विश्लेषण किया जा रहा है. इस तरह से पुष्टि करने पर, डेटा के आधार पर निकाले गए नतीजों पर लोगों का भरोसा बढ़ता है.
नतीजा
यह आर्किटेक्चरल पैटर्न, बड़े पैमाने पर भू-स्थानिक जानकारी की पुष्टि करने का एक मज़बूत और असरदार तरीका उपलब्ध कराता है. जगहों की अहम जानकारी का इस्तेमाल करके, बड़े पैमाने पर विश्लेषण किया जा सकता है. साथ ही, Place Details API का इस्तेमाल करके, ज़मीनी हकीकत की पुष्टि की जा सकती है. इससे आपको बेहतर फ़ीडबैक लूप बनाने में मदद मिलती है. इससे यह पक्का होता है कि आपके रणनीतिक फ़ैसले, आंकड़ों के हिसाब से अहम होने के साथ-साथ सटीक भी हों. चाहे ये फ़ैसले, खुदरा साइट चुनने से जुड़े हों या लॉजिस्टिक्स की योजना बनाने से.
अगले चरण
- जगह की गिनती करने वाले अन्य फ़ंक्शन एक्सप्लोर करें. इससे आपको यह पता चलेगा कि वे विश्लेषण से जुड़े अलग-अलग सवालों के जवाब कैसे दे सकते हैं.
- Places API से जुड़ा दस्तावेज़ देखें. इससे आपको उन अन्य फ़ील्ड के बारे में पता चलेगा जिनके लिए अनुरोध किया जा सकता है, ताकि विश्लेषण को और बेहतर बनाया जा सके.
योगदानकर्ता
हेनरिक वाल्व | DevX इंजीनियर