

總覽
處理大型資料集時,直接透過模型傳遞原始資料會導致問題:回應速度變慢、權杖費用增加,以及產生推論錯誤。RMI 資料可能多達數百萬列,因此讓代理程式查詢無限量的資料並全數擷取以供分析,會耗費大量權杖,並使內容視窗膨脹,導致代理程式在後續每次輪流時效能下降。
舉例來說,對 RMI historical_travel_time 資料表執行的查詢可能會傳回數千個路段資料列。將完整結果集放回對話記錄會拖慢後續每一輪的對話、增加成本,並分散模型注意力,導致無法統整出最終答案。
光靠提示指令無法解決這些問題。唯一可靠的方法是攔截工具呼叫,並將大型資料酬載傳送至模型脈絡窗口以外的位置。
ADK 工具回呼
ADK 提供回呼掛鉤,可攔截工具執行作業。如要處理大型結果集,請使用 after_tool_callback:
before_tool_callback(tool, args, tool_context):在模型選取工具後執行,但會在工具執行前執行。after_tool_callback(tool, args, tool_context, tool_response):在工具完成後執行,但會在結果傳回模型之前執行。你可以使用這項功能修改工具回覆。
回呼會收到 tool_context 物件,可存取工作階段 state。這樣一來,您就能在對話輪次中,將大型資料集儲存在背景記憶體,不必將資料集放入模型的提示中。
# root_agent = llm_agent.Agent(
#     ...,
#     after_tool_callback=stash_and_truncate_results,
# )
執行後截斷和暫存
目標:向模型顯示一小部分查詢結果樣本,供決策之用,同時保留完整資料集以供最終輸出。
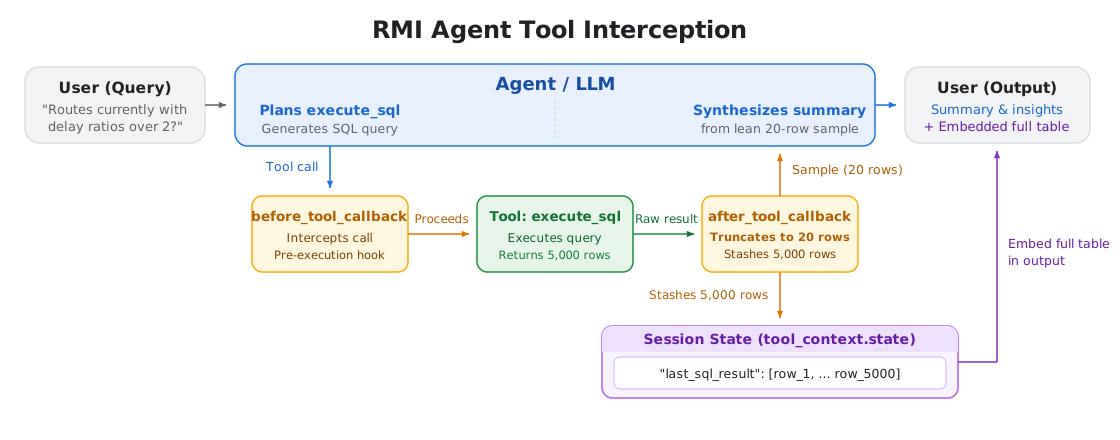
如果是 RMI 代理程式,after_tool_callback 會攔截 execute_sql 結果、將完整資料列清單儲存至工作階段狀態,並傳回簡短樣本和資料列總數:
def stash_and_truncate_results(tool, args, tool_context, tool_response):
  if tool.name == "execute_sql" and "rows" in tool_response:
    rows = tool_response["rows"]
    tool_context.state["last_sql_result"] = rows      # keep everything
    tool_response["total_rows_fetched"] = len(rows)
    tool_response["rows"] = rows[:SAMPLE_LIMIT]        # show a sample
    tool_response["message"] = (
        f"Showing {SAMPLE_LIMIT} of {len(rows)} rows. "
        "Full result stashed in background state."
    )
  return tool_response
傳回範例可減少所有後續回合的輸入權杖,降低成本並縮短回覆時間。此外,這也能避免大型查詢結果擠滿脈絡窗口,進而影響模型遵循指令的能力。
請務必在代理程式提示中明確說明,工具會依設計傳回樣本。如果沒有這個脈絡,模型可能會因部分資料而感到困惑,浪費運算和推論權杖來調解遺失的記錄,或啟動多餘的工具呼叫來擷取其餘資料。
範例:處理大型結果集
- 使用者詢問「目前延誤率超過 2 的路線有哪些?」
- 服務專員對
historical_travel_time執行的查詢會傳回數千列。 after_tool_callback會將完整結果儲存在工作階段狀態中,並只傳回一小部分樣本和總列數。- 模型會根據該樣本推論,然後撰寫摘要。
- 應用程式或下游工具會直接從工作階段狀態讀取完整資料集,以便算繪完整表格或匯出供使用者使用。
重點整理
- 避免在提示中加入大型酬載:將大型資料集儲存在工作階段狀態中,而不是透過提示記錄來回傳遞。
- 截斷大型工具輸出內容:使用
after_tool_callback將小型樣本傳回模型,同時將完整結果儲存在工作階段狀態中。 - 向模型說明樣本:新增提示規則,說明結果會經過取樣,避免模型混淆、浪費推論詞元,以及產生多餘的工具呼叫。
後續步驟
- ADK 回呼參考資料:請參閱官方 ADK 回呼指南,瞭解模型、代理程式和工具層級的攔截作業。
貢獻者
Nathaniel Thomas | Google Maps Platform 軟體工程實習生