

ภาพรวม
เมื่อต้องจัดการกับชุดข้อมูลขนาดใหญ่ การส่งข้อมูลดิบผ่านโมเดลโดยตรงจะทำให้เกิดปัญหาต่างๆ เช่น การตอบสนองช้าลง ต้นทุนโทเค็นสูงขึ้น และเกิดข้อผิดพลาดในการให้เหตุผล ข้อมูล RMI อาจมีหลายล้านแถว ดังนั้นการอนุญาตให้ Agent ค้นหาข้อมูลจำนวนไม่จำกัดและนำเข้าข้อมูลทั้งหมดเพื่อการวิเคราะห์จึงมีค่าใช้จ่ายสูงในโทเค็นและทำให้หน้าต่างบริบทมีขนาดใหญ่ขึ้น ซึ่งจะลดประสิทธิภาพของ Agent ในทุกๆ รอบถัดไป
เช่น การค้นหาในตาราง RMI historical_travel_time อาจแสดงผลแถวของส่วนถนนหลายพันแถว การใส่ชุดผลลัพธ์ทั้งหมดกลับไปในประวัติการสนทนาจะทำให้ทุกๆ เทิร์นต่อมาทำงานช้าลง เพิ่มต้นทุน และทำให้โมเดลเสียสมาธิจากการสังเคราะห์คำตอบสุดท้าย
คำสั่งพรอมต์เพียงอย่างเดียวไม่สามารถแก้ไขปัญหาเหล่านี้ได้ วิธีที่เชื่อถือได้เพียงวิธีเดียวคือสกัดกั้นการเรียกใช้เครื่องมือและกำหนดเส้นทางเพย์โหลดข้อมูลขนาดใหญ่ นอกหน้าต่างบริบทของโมเดล
การเรียกกลับของเครื่องมือ ADK
ADK มี Hook การเรียกกลับเพื่อสกัดกั้นการเรียกใช้เครื่องมือ หากต้องการจัดการชุดผลลัพธ์ขนาดใหญ่ ให้ใช้after_tool_callback
before_tool_callback(tool, args, tool_context): ทำงานหลังจากที่โมเดล เลือกเครื่องมือ แต่ก่อนที่เครื่องมือจะดำเนินการafter_tool_callback(tool, args, tool_context, tool_response): ทำงานหลังจาก เครื่องมือทำงานเสร็จ แต่ก่อนที่ผลลัพธ์จะกลับไปที่โมเดล ใช้เพื่อแก้ไขคำตอบของเครื่องมือ
Callback จะได้รับออบเจ็กต์ tool_context ที่มีสิทธิ์เข้าถึงเซสชัน state
ซึ่งช่วยให้คุณจัดเก็บชุดข้อมูลขนาดใหญ่ไว้ในหน่วยความจำเบื้องหลังได้ตลอดการสนทนา
โดยไม่ต้องใส่ไว้ในพรอมต์ของโมเดล
# root_agent = llm_agent.Agent(
#     ...,
#     after_tool_callback=stash_and_truncate_results,
# )
การตัดทอนและการซ่อนหลังการดำเนินการ
วัตถุประสงค์: แสดงตัวอย่างผลการค้นหาเล็กๆ ให้โมเดลเพื่อใช้ในการตัดสินใจ ขณะเดียวกันก็บันทึกชุดข้อมูลที่สมบูรณ์ไว้สำหรับเอาต์พุตสุดท้าย
สำหรับตัวแทน RMI after_tool_callback จะสกัดกั้นผลลัพธ์ execute_sql
บันทึกรายการแถวทั้งหมดในสถานะเซสชัน และส่งกลับตัวอย่างสั้นๆ พร้อม
จำนวนแถวทั้งหมด
def stash_and_truncate_results(tool, args, tool_context, tool_response):
  if tool.name == "execute_sql" and "rows" in tool_response:
    rows = tool_response["rows"]
    tool_context.state["last_sql_result"] = rows      # keep everything
    tool_response["total_rows_fetched"] = len(rows)
    tool_response["rows"] = rows[:SAMPLE_LIMIT]        # show a sample
    tool_response["message"] = (
        f"Showing {SAMPLE_LIMIT} of {len(rows)} rows. "
        "Full result stashed in background state."
    )
  return tool_response
การส่งคืนตัวอย่างจะช่วยลดโทเค็นอินพุตในทุกรอบในอนาคต ซึ่งจะช่วยลด ต้นทุนและเวลาในการตอบกลับ นอกจากนี้ยังช่วยป้องกันไม่ให้ผลการค้นหาขนาดใหญ่ทำให้หน้าต่างบริบทแน่นเกินไปและส่งผลเสียต่อความสามารถของโมเดลในการทำตามคำสั่ง
ตรวจสอบว่าพรอมต์ของเอเจนต์อธิบายอย่างชัดเจนว่าเครื่องมือจะแสดงตัวอย่างตาม การออกแบบ หากไม่มีบริบทนี้ โมเดลอาจสับสนกับข้อมูลบางส่วน ทำให้เสียโทเค็นการคำนวณและการให้เหตุผลไปกับการพยายามปรับข้อมูลที่ขาดหายไป หรือเรียกใช้เครื่องมือที่ซ้ำซ้อนเพื่อดึงข้อมูลที่เหลือ
ตัวอย่าง: การจัดการชุดผลลัพธ์ขนาดใหญ่
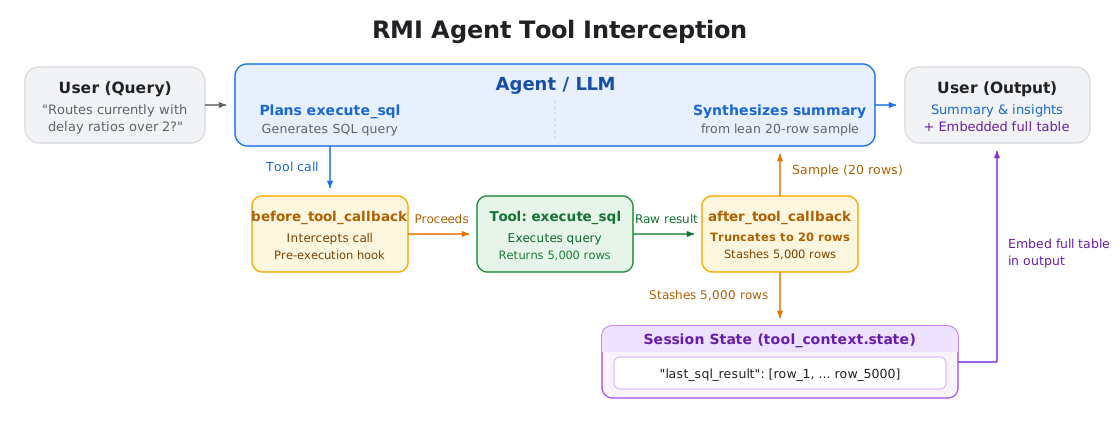
- ผู้ใช้ถามว่า "ตอนนี้มีเส้นทางใดบ้างที่มีอัตราส่วนความล่าช้ามากกว่า 2"
- คำค้นหาของ Agent กับ
historical_travel_timeแสดงผลหลายพันแถว after_tool_callbackจะบันทึกผลลัพธ์ทั้งหมดในสถานะเซสชันและ แสดงตัวอย่างขนาดเล็กพร้อมจำนวนแถวทั้งหมดเท่านั้น- โมเดลจะใช้เหตุผลวิเคราะห์ตัวอย่างดังกล่าวเพื่อเขียนสรุป
- แอปพลิเคชันหรือเครื่องมือปลายทางจะอ่านชุดข้อมูลทั้งหมดจากสถานะเซสชันโดยตรงเพื่อแสดงตารางที่สมบูรณ์หรือส่งออกให้ผู้ใช้
สรุปประเด็นสำคัญ
- หลีกเลี่ยงการใช้เพย์โหลดขนาดใหญ่ในพรอมต์: จัดเก็บชุดข้อมูลขนาดใหญ่ในสถานะเซสชันแทนการส่งไปมาผ่านประวัติพรอมต์
- ตัดเอาต์พุตเครื่องมือขนาดใหญ่ออก: ใช้
after_tool_callbackเพื่อส่งตัวอย่างขนาดเล็ก ไปยังโมเดลในขณะที่บันทึกผลลัพธ์ทั้งหมดในสถานะเซสชัน - แจ้งให้โมเดลทราบเกี่ยวกับตัวอย่าง: เพิ่มกฎพรอมต์ที่อธิบายว่า ผลลัพธ์เป็นแบบสุ่มตัวอย่างเพื่อป้องกันไม่ให้โมเดลสับสน โทเค็นการให้เหตุผลสูญเปล่า และการเรียกใช้เครื่องมือที่ซ้ำซ้อน
ขั้นตอนถัดไป
- ข้อมูลอ้างอิงการเรียกกลับของ ADK: อ่านรายละเอียดเกี่ยวกับการสกัดกั้นระดับโมเดล เอเจนต์ และเครื่องมือได้ใน คู่มือการเรียกกลับของ ADK อย่างเป็นทางการ
ผู้ร่วมให้ข้อมูล
Nathaniel Thomas | นักศึกษาฝึกงานด้านวิศวกรรมซอฟต์แวร์, Google Maps Platform