

Przegląd
W przypadku dużych zbiorów danych przekazywanie nieprzetworzonych danych bezpośrednio przez model powoduje problemy: spowalnia odpowiedzi, zwiększa koszty tokenów i powoduje błędy rozumowania. Dane RMI mogą obejmować miliony wierszy, więc umożliwienie agentowi wysyłania zapytań o nieograniczoną ilość danych i pozyskiwania ich wszystkich do analizy jest kosztowne pod względem tokenów i powiększa okno kontekstu, co pogarsza wydajność agenta w każdej kolejnej turze.
Na przykład zapytanie dotyczące tabeli RMI historical_travel_time może zwrócić tysiące wierszy z segmentami dróg. Umieszczenie pełnego zestawu wyników z powrotem w historii rozmowy spowalnia każdą kolejną turę, zwiększa koszty i odwraca uwagę modelu od syntezy ostatecznej odpowiedzi.
Same instrukcje w promptach nie rozwiążą tych problemów. Jedynym niezawodnym podejściem jest przechwytywanie wywołań narzędzi i kierowanie dużych ładunków danych poza okno kontekstu modelu.
Wywołania zwrotne narzędzi ADK
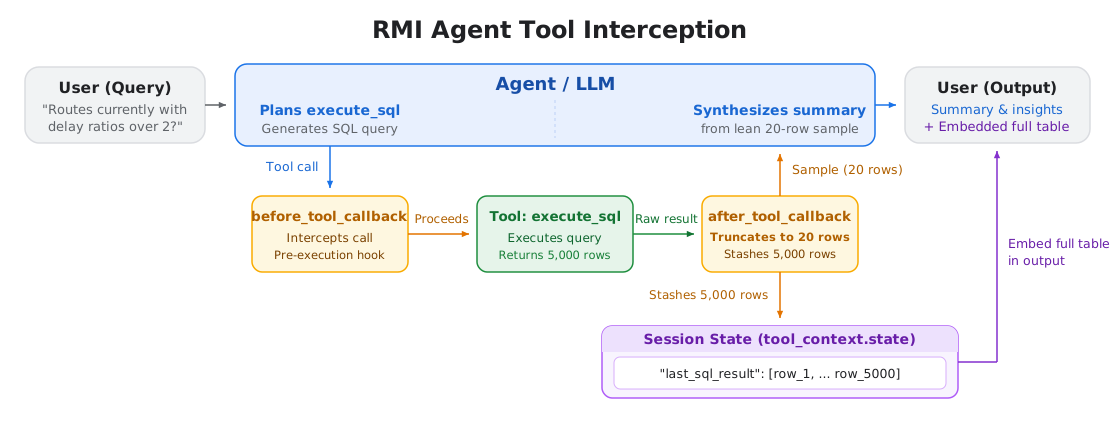
Pakiet ADK udostępnia punkty zaczepienia wywołania zwrotnego, które umożliwiają przechwytywanie wykonywania narzędzia. Aby obsługiwać duże zbiory wyników, użyj after_tool_callback:
before_tool_callback(tool, args, tool_context): uruchamia się po wybraniu narzędzia przez model, ale przed jego wykonaniem.after_tool_callback(tool, args, tool_context, tool_response): uruchamia się po zakończeniu działania narzędzia, ale przed zwróceniem wyniku do modelu. Użyj go, aby zmodyfikować odpowiedź narzędzia.
Wywołanie zwrotne otrzymuje obiekt tool_context z dostępem do sesji state.
Dzięki temu możesz przechowywać duże zbiory danych w pamięci w tle podczas rozmowy bez umieszczania ich w prompcie modelu.
# root_agent = llm_agent.Agent(
#     ...,
#     after_tool_callback=stash_and_truncate_results,
# )
Skracanie i ukrywanie po wykonaniu procesu
Cel: pokaż modelowi małą próbkę wyników zapytania, aby mógł podjąć decyzję, a pełny zbiór danych zachowaj na potrzeby ostatecznych danych wyjściowych.
W przypadku agenta RMI after_tool_callback przechwytuje wyniki execute_sql, zapisuje pełną listę wierszy w stanie sesji i zwraca krótką próbkę wraz z łączną liczbą wierszy:
def stash_and_truncate_results(tool, args, tool_context, tool_response):
  if tool.name == "execute_sql" and "rows" in tool_response:
    rows = tool_response["rows"]
    tool_context.state["last_sql_result"] = rows      # keep everything
    tool_response["total_rows_fetched"] = len(rows)
    tool_response["rows"] = rows[:SAMPLE_LIMIT]        # show a sample
    tool_response["message"] = (
        f"Showing {SAMPLE_LIMIT} of {len(rows)} rows. "
        "Full result stashed in background state."
    )
  return tool_response
Zwrócenie próbki zmniejsza liczbę tokenów wejściowych we wszystkich przyszłych turach, co obniża koszty i skraca czas odpowiedzi. Zapobiega to również przepełnieniu okna kontekstu przez duże wyniki zapytań i pogorszeniu zdolności modelu do wykonywania instrukcji.
Upewnij się, że prompt agenta wyraźnie wyjaśnia, że narzędzia zwracają próbkę. Bez tego kontekstu model może zostać wprowadzony w błąd przez częściowe dane, marnując tokeny obliczeniowe i tokeny rozumowania na próby uzgodnienia brakujących rekordów lub uruchamiając zbędne wywołania narzędzi w celu pobrania reszty.
Przykład: obsługa dużego zbioru wyników
- Użytkownik pyta: „Które trasy mają obecnie współczynnik opóźnienia powyżej 2 w tej chwili?”.
- Zapytanie agenta do
historical_travel_timezwraca tysiące wierszy. after_tool_callbackzapisuje pełny wynik w stanie sesji i zwraca tylko małą próbkę oraz łączną liczbę wierszy.- Model analizuje tę próbkę, aby utworzyć podsumowanie.
- Aplikacja lub narzędzia podrzędne odczytują pełny zbiór danych bezpośrednio ze stanu sesji, aby wyrenderować pełną tabelę lub wyeksportować ją dla użytkownika.
Najważniejsze punkty
- Unikaj dużych ładunków w promptach: przechowuj duże zbiory danych w stanie sesji, zamiast przekazywać je tam i z powrotem w historii promptów.
- Skracanie dużych danych wyjściowych narzędzia: użyj
after_tool_callback, aby zwracać do modelu małe próbki, zapisując pełne wyniki w stanie sesji. - Poinformuj model o próbkach: dodaj regułę prompta wyjaśniającą, że wyniki są próbkowane, aby zapobiec dezorientacji modelu, marnowaniu tokenów rozumowania i zbędnym wywołaniom narzędzi.
Dalsze kroki
- Dokumentacja wywołań zwrotnych ADK: przeczytaj oficjalny przewodnik po wywołaniach zwrotnych ADK, aby dowiedzieć się więcej o przechwytywaniu na poziomie modelu, agenta i narzędzia.
Współtwórcy
Nathaniel Thomas | Software Engineering Intern, Google Maps Platform