

개요
대규모 데이터 세트를 처리할 때 모델을 통해 원시 데이터를 직접 전달하면 응답 속도가 느려지고 토큰 비용이 증가하며 추론 오류가 발생합니다. RMI 데이터는 수백만 개의 행에 걸쳐 있을 수 있으므로 에이전트가 무제한의 양을 쿼리하고 분석을 위해 모두 수집하도록 하면 토큰 비용이 많이 들고 컨텍스트 창이 커져 후속 턴마다 에이전트의 성능이 저하됩니다.
예를 들어 RMI historical_travel_time 테이블에 대한 쿼리는 수천 개의 도로 구간 행을 반환할 수 있습니다. 전체 결과 집합을 대화 기록에 다시 넣으면 후속 턴마다 속도가 느려지고 비용이 증가하며 모델이 최종 대답을 종합하는 데 방해가 됩니다.
프롬프트 안내만으로는 이러한 문제를 해결할 수 없습니다. 유일한 안정적인 접근 방식은 도구 호출을 가로채고 모델의 컨텍스트 윈도우 외부로 대규모 데이터 페이로드를 라우팅하는 것입니다.
ADK 도구 콜백
ADK는 도구 실행을 가로채는 콜백 후크를 제공합니다. 대규모 결과 집합을 처리하려면 after_tool_callback을 사용하세요.
before_tool_callback(tool, args, tool_context): 모델이 도구를 선택한 후 실행되지만 도구가 실행되기 전에 실행됩니다.after_tool_callback(tool, args, tool_context, tool_response): 도구가 완료된 후 실행되지만 결과가 모델로 돌아가기 전에 실행됩니다. 이를 사용하여 도구 응답을 수정 합니다.
콜백은 세션 state에 액세스할 수 있는 tool_context 객체를 수신합니다.
이를 통해 모델의 프롬프트에 넣지 않고도 대화 턴 전반에 걸쳐 백그라운드 메모리에 대규모 데이터 세트를 저장할 수 있습니다.
# root_agent = llm_agent.Agent(
#     ...,
#     after_tool_callback=stash_and_truncate_results,
# )
실행 후 자르기 및 스태싱
목표: 최종 출력을 위해 전체 데이터 세트를 저장하면서 의사 결정을 위해 모델에 쿼리 결과의 작은 샘플을 표시합니다.
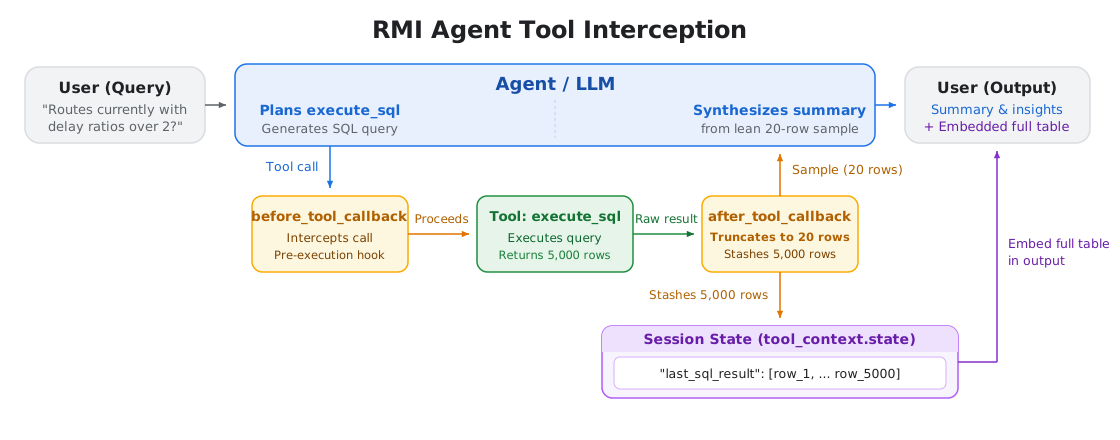
RMI 에이전트의 경우 after_tool_callback이 execute_sql 결과를 가로채고 세션 상태에 전체 행 목록을 저장하며 총 행 수와 함께 짧은 샘플을 반환합니다.
def stash_and_truncate_results(tool, args, tool_context, tool_response):
  if tool.name == "execute_sql" and "rows" in tool_response:
    rows = tool_response["rows"]
    tool_context.state["last_sql_result"] = rows      # keep everything
    tool_response["total_rows_fetched"] = len(rows)
    tool_response["rows"] = rows[:SAMPLE_LIMIT]        # show a sample
    tool_response["message"] = (
        f"Showing {SAMPLE_LIMIT} of {len(rows)} rows. "
        "Full result stashed in background state."
    )
  return tool_response
샘플을 반환하면 향후 모든 턴에서 입력 토큰이 줄어들어 비용과 응답 시간이 단축됩니다. 또한 대규모 쿼리 결과가 컨텍스트 윈도우를 가득 채우고 모델의 안내를 따르는 기능을 저해하는 것을 방지합니다.
에이전트 프롬프트에서 도구가 설계상 샘플을 반환한다고 명시적으로 설명해야 합니다. 이 컨텍스트가 없으면 모델이 부분 데이터로 인해 혼동되어 누락된 레코드를 조정하거나 나머지 레코드를 가져오기 위해 중복된 도구 호출을 실행하는 데 컴퓨팅 및 추론 토큰을 낭비할 수 있습니다.
예: 대규모 결과 집합 처리
- 사용자가 "현재 지연 비율이 2를 초과하는 경로는 무엇인가요?" 라고 묻습니다.
historical_travel_time에 대한 에이전트의 쿼리는 수천 개의 행을 반환합니다.after_tool_callback은 전체 결과를 세션 상태에 저장하고 작은 샘플과 총 행 수만 반환합니다.- 모델은 해당 샘플을 추론하여 요약을 작성합니다.
- 애플리케이션 또는 다운스트림 도구는 세션 상태에서 전체 데이터 세트를 직접 읽어 전체 테이블을 렌더링하거나 사용자를 위해 내보냅니다.
핵심 내용
- 프롬프트에서 대규모 페이로드 제외: 프롬프트 기록을 통해 대규모 데이터 세트를 주고받는 대신 세션 상태에 저장합니다.
- 대규모 도구 출력 자르기:
after_tool_callback을 사용하여 전체 결과를 세션 상태에 저장하면서 모델에 작은 샘플을 반환합니다. - 모델에 샘플 정보 제공: 모델 혼동, 추론 토큰 낭비, 및 중복된 도구 호출을 방지하기 위해 결과가 샘플링된다고 설명하는 프롬프트 규칙을 추가합니다.
다음 단계
- ADK 콜백 참조: 모델, 에이전트, 도구 수준 가로채기에 관한 자세한 내용은 공식 ADK 콜백 가이드를 참고하세요.
참여자
Nathaniel Thomas | Google Maps Platform 소프트웨어 엔지니어링 인턴