

概要
大規模なデータセットを扱う場合、未加工のデータをモデルに直接渡すと、レスポンスが遅くなったり、トークン費用が増加したり、推論エラーが発生したりするなどの問題が発生します。RMI データは数百万行に及ぶ可能性があるため、エージェントが無制限の量をクエリして、分析のためにすべて取り込むと、トークンが大量に消費され、コンテキスト ウィンドウが肥大化し、後続のすべてのターンでエージェントのパフォーマンスが低下します。
たとえば、RMI historical_travel_time テーブルに対するクエリは、数千の道路セグメント行を返すことがあります。結果セット全体を会話履歴に戻すと、後続のターンが遅くなり、コストが増加し、モデルが最終的な回答を合成する際に混乱が生じます。
プロンプトの指示だけでは、これらの問題を解決できません。信頼できる唯一の方法は、ツール呼び出しをインターセプトし、大きなデータ ペイロードをモデルのコンテキスト ウィンドウの外にルーティングすることです。
ADK ツールのコールバック
ADK は、ツール実行をインターセプトするためのコールバック フックを提供します。大きな結果セットを処理するには、after_tool_callback を使用します。
before_tool_callback(tool, args, tool_context): モデルがツールを選択した後、ツールが実行される前に実行されます。after_tool_callback(tool, args, tool_context, tool_response): ツールの完了後、結果がモデルに戻る前に実行されます。これを使用して、ツールのレスポンスを変更します。
コールバックは、セッション state にアクセスできる tool_context オブジェクトを受け取ります。これにより、大規模なデータセットをモデルのプロンプトに含めることなく、会話のターンをまたいでバックグラウンド メモリに保存できます。
# root_agent = llm_agent.Agent(
#     ...,
#     after_tool_callback=stash_and_truncate_results,
# )
実行後の切り捨てとスタッシュ
目的: 最終的な出力用に完全なデータセットを保存しながら、意思決定のためにクエリ結果の小さなサンプルをモデルに表示します。
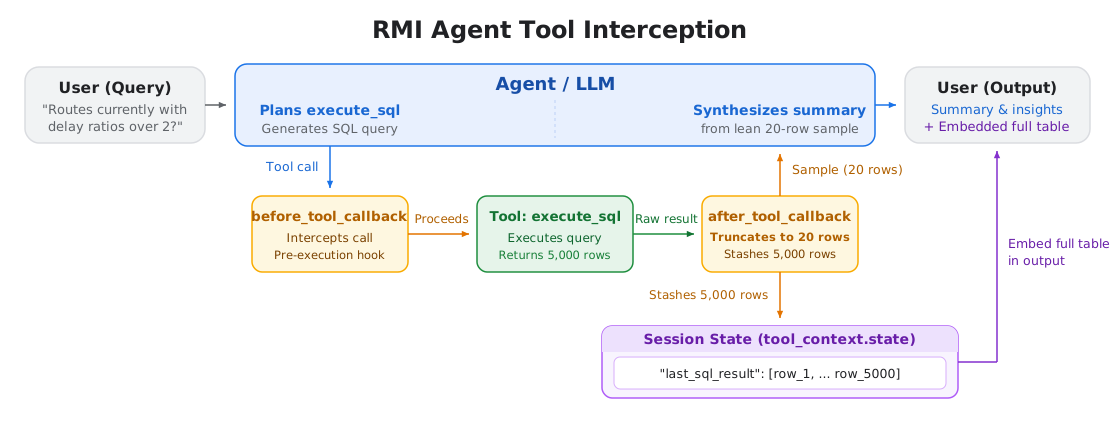
RMI エージェントの場合、after_tool_callback は execute_sql の結果をインターセプトし、行の完全なリストをセッション状態に保存して、合計行数とともに短いサンプルを返します。
def stash_and_truncate_results(tool, args, tool_context, tool_response):
  if tool.name == "execute_sql" and "rows" in tool_response:
    rows = tool_response["rows"]
    tool_context.state["last_sql_result"] = rows      # keep everything
    tool_response["total_rows_fetched"] = len(rows)
    tool_response["rows"] = rows[:SAMPLE_LIMIT]        # show a sample
    tool_response["message"] = (
        f"Showing {SAMPLE_LIMIT} of {len(rows)} rows. "
        "Full result stashed in background state."
    )
  return tool_response
サンプルを返すと、今後のすべてのターンで入力トークンが削減され、費用とレスポンス時間が短縮されます。また、大きなクエリ結果がコンテキスト ウィンドウを占有し、モデルが指示に従う能力を損なうことも防ぎます。
エージェント プロンプトで、ツールが設計上サンプルを返すことを明示的に説明してください。このコンテキストがないと、モデルは部分的なデータに混乱し、欠落したレコードを調整しようとしてコンピューティングと推論トークンを無駄にしたり、残りのデータを取得するために冗長なツール呼び出しを開始したりする可能性があります。
例: 大規模な結果セットを処理する
- ユーザーが「現在、遅延率が 2 を超えているルートはどれですか?」と質問します。
historical_travel_timeに対するエージェントのクエリは、数千行を返します。after_tool_callbackは、完全な結果をセッション状態に保存し、小さなサンプルと合計行数のみを返します。- モデルは、そのサンプルを推論して要約を作成します。
- アプリケーションまたはダウンストリーム ツールは、セッション状態からデータセット全体を直接読み取り、完全なテーブルをレンダリングするか、ユーザー向けにエクスポートします。
重要なポイント
- 大きなペイロードをプロンプトから除外する: 大きなデータセットは、プロンプト履歴を介してやり取りするのではなく、セッション状態に保存します。
- 大きなツール出力を切り捨てる:
after_tool_callbackを使用して、完全な結果をセッション状態に保存しながら、小さなサンプルをモデルに返します。 - モデルにサンプルについて通知する: 結果がサンプリングされることを説明するプロンプト ルールを追加して、モデルの混乱、推論トークンの無駄、冗長なツール呼び出しを防ぎます。
次のステップ
- ADK コールバックのリファレンス: モデル、エージェント、ツールレベルのインターセプトの詳細については、公式の ADK コールバック ガイドをご覧ください。
寄稿者
Nathaniel Thomas | Google Maps Platform、ソフトウェア エンジニアリング インターン