

खास जानकारी
बड़े डेटासेट का इस्तेमाल करते समय, मॉडल में सीधे तौर पर रॉ डेटा पास करने से समस्याएं होती हैं: इससे जवाब मिलने में ज़्यादा समय लगता है, टोकन की लागत बढ़ जाती है, और गहराई से विश्लेषण से जुड़ी गड़बड़ियां होती हैं. आरएमआई डेटा में लाखों लाइनें हो सकती हैं. इसलिए, एजेंट को बिना किसी सीमा के क्वेरी करने और विश्लेषण के लिए सभी डेटा को शामिल करने की अनुमति देने पर, टोकन का इस्तेमाल ज़्यादा होता है. साथ ही, कॉन्टेक्स्ट विंडो का साइज़ भी बढ़ जाता है. इससे, हर बार एजेंट की परफ़ॉर्मेंस खराब होती है.
उदाहरण के लिए, RMI historical_travel_time टेबल पर की गई क्वेरी से, सड़क के सेगमेंट की हज़ारों लाइनें मिल सकती हैं. पूरे नतीजे को बातचीत के इतिहास में वापस डालने से, बाद के हर टर्न में समय लगता है. साथ ही, इससे लागत बढ़ती है और मॉडल का ध्यान, आखिरी जवाब को सिंथेसाइज़ करने से हट जाता है.
सिर्फ़ प्रॉम्प्ट के निर्देशों से इन समस्याओं को हल नहीं किया जा सकता. टूल कॉल को इंटरसेप्ट करना और बड़े डेटा पेलोड को मॉडल की कॉन्टेक्स्ट विंडो से बाहर भेजना ही भरोसेमंद तरीका है.
ADK टूल कॉलबैक
ADK, टूल के एक्ज़ीक्यूशन को रोकने के लिए कॉलबैक हुक उपलब्ध कराता है. नतीजों के बड़े सेट को मैनेज करने के लिए, after_tool_callback का इस्तेमाल करें:
before_tool_callback(tool, args, tool_context): यह फ़ंक्शन तब चलता है, जब मॉडल किसी टूल को चुन लेता है. हालांकि, टूल के काम करने से पहले यह फ़ंक्शन चलता है.after_tool_callback(tool, args, tool_context, tool_response): यह टूल के पूरा होने के बाद चलता है, लेकिन नतीजे को मॉडल के पास वापस भेजने से पहले चलता है. इसका इस्तेमाल करके, टूल के जवाब में बदलाव करें.
कॉलबैक को tool_context ऑब्जेक्ट मिलता है. इससे सेशन state को ऐक्सेस किया जा सकता है.
इस सुविधा की मदद से, बड़े डेटासेट को बातचीत के सभी चरणों में बैकग्राउंड मेमोरी में सेव किया जा सकता है. इसके लिए, उन्हें मॉडल के प्रॉम्प्ट में शामिल करने की ज़रूरत नहीं होती.
# root_agent = llm_agent.Agent(
#     ...,
#     after_tool_callback=stash_and_truncate_results,
# )
एक्ज़ीक्यूशन के बाद काटना और छिपाना
मकसद: मॉडल को फ़ैसले लेने के लिए, क्वेरी के नतीजों का छोटा सैंपल दिखाएं. साथ ही, फ़ाइनल आउटपुट के लिए पूरा डेटासेट सेव करें.
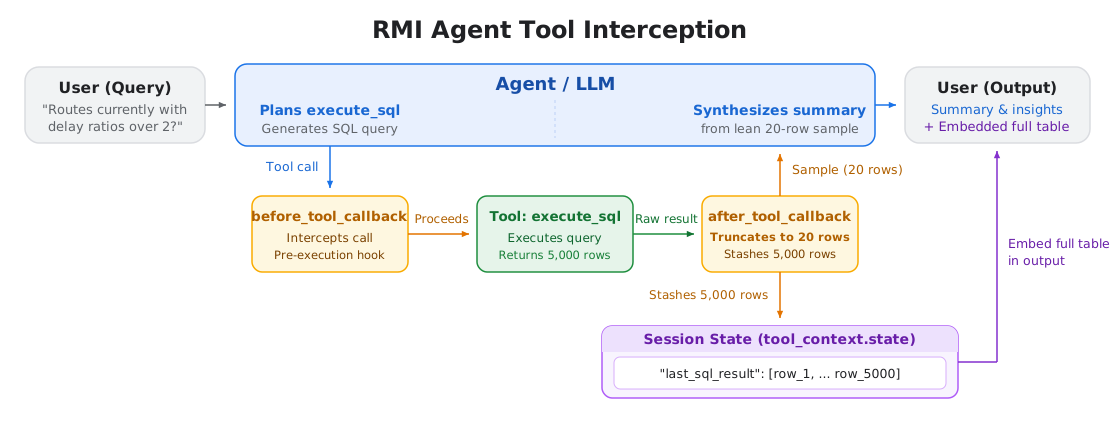
आरएमआई एजेंट के लिए, after_tool_callback इंटरसेप्ट execute_sql नतीजे देता है. साथ ही, सेशन की स्थिति में पंक्तियों की पूरी सूची सेव करता है और पंक्तियों की कुल संख्या के साथ-साथ छोटा सैंपल दिखाता है:
def stash_and_truncate_results(tool, args, tool_context, tool_response):
  if tool.name == "execute_sql" and "rows" in tool_response:
    rows = tool_response["rows"]
    tool_context.state["last_sql_result"] = rows      # keep everything
    tool_response["total_rows_fetched"] = len(rows)
    tool_response["rows"] = rows[:SAMPLE_LIMIT]        # show a sample
    tool_response["message"] = (
        f"Showing {SAMPLE_LIMIT} of {len(rows)} rows. "
        "Full result stashed in background state."
    )
  return tool_response
जवाब में सैंपल देने से, आने वाले समय में होने वाली सभी बातचीत में इनपुट टोकन की संख्या कम हो जाती है. इससे लागत और जवाब देने में लगने वाला समय कम हो जाता है. इससे क्वेरी के बड़े नतीजों को कॉन्टेक्स्ट विंडो में शामिल होने से रोका जा सकता है. साथ ही, मॉडल को निर्देशों का पालन करने से रोका जा सकता है.
पक्का करें कि आपके एजेंट प्रॉम्प्ट में यह साफ़ तौर पर बताया गया हो कि टूल, डिज़ाइन के हिसाब से सैंपल दिखाते हैं. इस कॉन्टेक्स्ट के बिना, मॉडल को अधूरे डेटा से भ्रमित किया जा सकता है. इससे, कंप्यूट और गहराई से विश्लेषण टोकन बर्बाद हो सकते हैं. ऐसा इसलिए, क्योंकि मॉडल छूटे हुए रिकॉर्ड को ठीक करने की कोशिश करता है या बाकी डेटा को फ़ेच करने के लिए, ज़रूरत से ज़्यादा टूल कॉल लॉन्च करता है.
उदाहरण: नतीजों के बड़े सेट को मैनेज करना
- उपयोगकर्ता पूछता है कि "फ़िलहाल, ऐसे कौनसे रूट हैं जिनमें देरी का अनुपात 2 से ज़्यादा है?"
- एजेंट की क्वेरी के जवाब में,
historical_travel_timeके लिए हज़ारों लाइनें मिलती हैं. after_tool_callbackपूरे नतीजे को सेशन की स्थिति में सेव करता है. साथ ही, सिर्फ़ एक छोटा सैंपल और लाइनों की कुल संख्या दिखाता है.- मॉडल, उस सैंपल के आधार पर खास जानकारी तैयार करता है.
- ऐप्लिकेशन या डाउनस्ट्रीम टूल, पूरे डेटासेट को सीधे सेशन की स्थिति से पढ़ते हैं, ताकि पूरी टेबल को रेंडर किया जा सके या उपयोगकर्ता के लिए एक्सपोर्ट किया जा सके.
ज़रूरी बातें
- बड़े पेलोड को प्रॉम्प्ट से बाहर रखें: बड़े डेटासेट को प्रॉम्प्ट के इतिहास में बार-बार भेजने के बजाय, उन्हें सेशन की स्थिति में सेव करें.
- टूल के बड़े आउटपुट को छोटा करें:
after_tool_callbackका इस्तेमाल करके, मॉडल को छोटे सैंपल दिखाएं. साथ ही, सेशन की स्थिति में पूरे नतीजे सेव करें. - मॉडल को सैंपल के बारे में बताएं: एक प्रॉम्प्ट नियम जोड़ें. इसमें बताएं कि मॉडल को भ्रमित होने से बचाने, गहराई से विश्लेषण के लिए इस्तेमाल होने वाले टोकन को बर्बाद होने से रोकने, और बार-बार टूल कॉल करने से बचने के लिए, नतीजों को सैंपल किया जाता है.
अगले चरण
- ADK कॉलबैक का रेफ़रंस: मॉडल, एजेंट, और टूल-लेवल इंटरसेप्शन के बारे में ज़्यादा जानने के लिए, ADK कॉलबैक गाइड पढ़ें.
योगदानकर्ता
नैथनियल थॉमस | सॉफ़्टवेयर इंजीनियरिंग इंटर्न, Google Maps Platform