

סקירה כללית
כשעובדים עם מערכי נתונים גדולים, העברת נתונים גולמיים ישירות דרך המודל גורמת לבעיות: היא מאטה את התגובות, מגדילה את עלויות הטוקנים ומובילה לשגיאות בהסקת מסקנות. נתוני RMI יכולים לכלול מיליוני שורות, ולכן לא כדאי לאפשר לסוכן לשלוח שאילתה על כמות בלתי מוגבלת של נתונים ולעבד את כולם לצורך ניתוח. פעולה כזו תהיה יקרה מבחינת טוקנים ותנפח את חלון ההקשר, מה שיפגע בביצועים של הסוכן בכל תור הבא.
לדוגמה, שאילתה על הטבלה historical_travel_time RMI יכולה להחזיר אלפי שורות של קטעי כביש. הכנסת כל מערך התוצאות בחזרה להיסטוריית השיחות מאטה כל תור בהמשך, מגדילה את העלות ומסיחה את דעתו של המודל מסינתוז התשובה הסופית.
הוראות בהנחיה לבד לא יכולות לפתור את הבעיות האלה. הדרך המהימנה היחידה היא ליירט קריאות לכלים ולהפנות מטען ייעודי גדול של נתונים מחוץ לחלון ההקשר של המודל.
קריאות חוזרות (callback) לכלים ב-ADK
ערכת ה-ADK מספקת ווים של קריאה חוזרת (callback) כדי ליירט את ההרצה של הכלי. כדי לטפל במערכי תוצאות גדולים, משתמשים ב-after_tool_callback:
-
before_tool_callback(tool, args, tool_context): מופעל אחרי שהמודל בוחר כלי, אבל לפני שהכלי מופעל. -
after_tool_callback(tool, args, tool_context, tool_response): מופעל אחרי שהכלי מסיים את הפעולה, אבל לפני שהתוצאה חוזרת למודל. אפשר להשתמש בו כדי לשנות את התשובה של הכלי.
ההתקשרות חזרה מקבלת אובייקט tool_context עם גישה להפעלה state.
כך תוכלו לאחסן מערכי נתונים גדולים בזיכרון הרקע לאורך תפניות בשיחה, בלי להוסיף אותם להנחיה של המודל.
# root_agent = llm_agent.Agent(
#     ...,
#     after_tool_callback=stash_and_truncate_results,
# )
חיתוך ושמירה של נתונים אחרי ההרצה
מטרה: להציג למודל מדגם קטן של תוצאות שאילתה לצורך קבלת החלטות, תוך שמירת מערך הנתונים המלא לפלט הסופי.
בסוכן RMI, after_tool_callback מיירט execute_sql תוצאות, שומר את הרשימה המלאה של השורות במצב הסשן ומחזיר דוגמה קצרה יחד עם מספר השורות הכולל:
def stash_and_truncate_results(tool, args, tool_context, tool_response):
  if tool.name == "execute_sql" and "rows" in tool_response:
    rows = tool_response["rows"]
    tool_context.state["last_sql_result"] = rows      # keep everything
    tool_response["total_rows_fetched"] = len(rows)
    tool_response["rows"] = rows[:SAMPLE_LIMIT]        # show a sample
    tool_response["message"] = (
        f"Showing {SAMPLE_LIMIT} of {len(rows)} rows. "
        "Full result stashed in background state."
    )
  return tool_response
החזרת דוגמה מקטינה את מספר טוקני הקלט בכל הפניות הבאות, וכך מקטינה את העלויות ומקצרת את זמני התגובה. בנוסף, הוא מונע מתוצאות גדולות של שאילתות להצטופף בחלון ההקשר ולפגוע ביכולת של המודל לפעול לפי ההוראות.
חשוב לוודא שההנחיה לסוכן מסבירה באופן מפורש שהכלים מחזירים דוגמה בכוונה. בלי ההקשר הזה, המודל עלול להתבלבל מנתונים חלקיים, לבזבז טוקנים של משאבי מחשוב וחשיבה רציונלית בניסיון לגשר על רשומות חסרות או להפעיל קריאות מיותרות לכלי כדי לאחזר את השאר.
דוגמה: טיפול במערך גדול של תוצאות
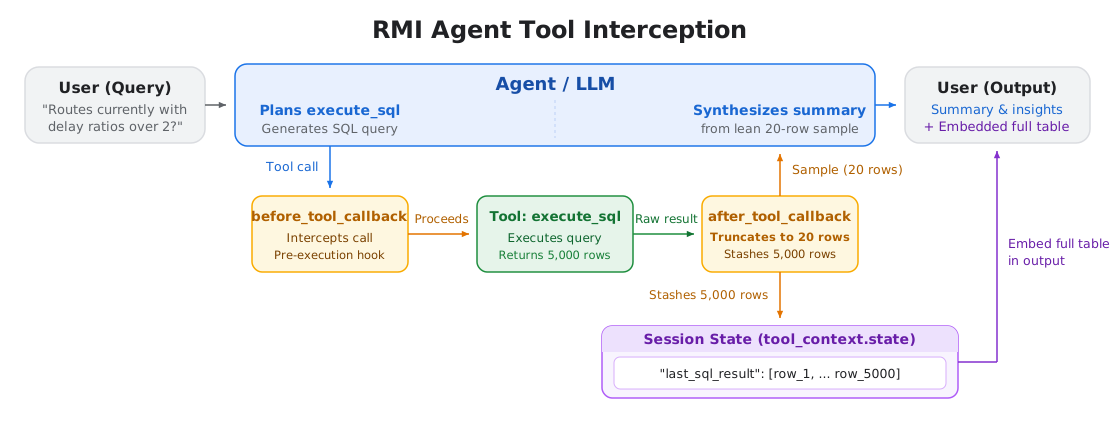
- המשתמש שואל "מהם המסלולים עם יחסי עיכוב מעל 2 כרגע?"
- השאילתה של הסוכן מול
historical_travel_timeמחזירה אלפי שורות. - הפונקציה
after_tool_callbackשומרת את התוצאה המלאה במצב הסשן ומחזירה רק דגימה קטנה בתוספת מספר השורות הכולל. - המודל מנתח את הדוגמה הזו כדי ליצור את התקציר.
- האפליקציה או כלי המשנה קוראים את מערך הנתונים המלא ישירות ממצב הסשן כדי להציג את הטבלה המלאה או לייצא אותה למשתמש.
מסקנות עיקריות
- לא להשתמש במטענים גדולים בהנחיות: כדאי לאחסן מערכי נתונים גדולים במצב הסשן במקום להעביר אותם הלוך ושוב דרך היסטוריית ההנחיות.
- חיתוך של פלט גדול של כלי: אפשר להשתמש ב-
after_tool_callbackכדי להחזיר דגימות קטנות למודל תוך שמירת התוצאות המלאות במצב הסשן. - לעדכן את המודל לגבי דוגמאות: מוסיפים כלל הנחיה שמסביר שהתוצאות נדגמות כדי למנוע בלבול של המודל, בזבוז של טוקנים של חשיבה רציונלית וקריאות מיותרות לכלים.
השלבים הבאים
- הפניה לקריאות חוזרות (callback) של ADK: אפשר לקרוא את המדריך הרשמי לקריאות חוזרות (callback) של ADK כדי לקבל פרטים על יירוט ברמת המודל, הסוכן והכלי.
תורמים
Nathaniel Thomas | Software Engineering Intern, Google Maps Platform