

Übersicht
Wenn Sie mit großen Datasets arbeiten und Rohdaten direkt an das Modell übergeben, kann das zu Problemen führen: Die Antworten werden langsamer, die Tokenkosten steigen und es können Logikfehler auftreten. RMI-Daten können Millionen von Zeilen umfassen. Wenn der Agent eine unbegrenzte Menge abfragen und alles zur Analyse aufnehmen kann, ist das teuer in Bezug auf Tokens und das Kontextfenster wird aufgebläht, was die Leistung des Agents bei jedem nachfolgenden Zug verschlechtert.
Eine Abfrage für die RMI-Tabelle historical_travel_time kann beispielsweise Tausende von Zeilen mit Straßensegmenten zurückgeben. Wenn Sie das vollständige Ergebnisset wieder in den Unterhaltungsverlauf einfügen, wird jede spätere Runde verlangsamt, die Kosten steigen und das Modell wird davon abgelenkt, die endgültige Antwort zu synthetisieren.
Diese Probleme lassen sich nicht allein durch Prompt-Anweisungen beheben. Die einzige zuverlässige Methode besteht darin, Tool-Aufrufe abzufangen und große Daten-Payloads außerhalb des Kontextfensters des Modells weiterzuleiten.
ADK-Tool-Callbacks
Das ADK bietet Callback-Hooks zum Abfangen der Tool-Ausführung. Verwenden Sie after_tool_callback, um große Ergebnismengen zu verarbeiten:
before_tool_callback(tool, args, tool_context): Wird ausgeführt, nachdem das Modell ein Tool ausgewählt hat, aber bevor das Tool ausgeführt wird.after_tool_callback(tool, args, tool_context, tool_response): Wird ausgeführt, nachdem das Tool fertig ist, aber bevor das Ergebnis an das Modell zurückgegeben wird. Damit können Sie die Antwort des Tools ändern.
Der Callback empfängt ein tool_context-Objekt mit Zugriff auf die Sitzung state.
So können Sie große Datasets über mehrere Gesprächsrunden hinweg im Hintergrundspeicher speichern, ohne sie in den Prompt des Modells aufzunehmen.
# root_agent = llm_agent.Agent(
#     ...,
#     after_tool_callback=stash_and_truncate_results,
# )
Abschneiden und Zwischenspeichern nach der Ausführung
Ziel: Dem Modell wird eine kleine Stichprobe von Suchergebnissen zur Entscheidungsfindung präsentiert, während der vollständige Datensatz für die endgültige Ausgabe gespeichert wird.
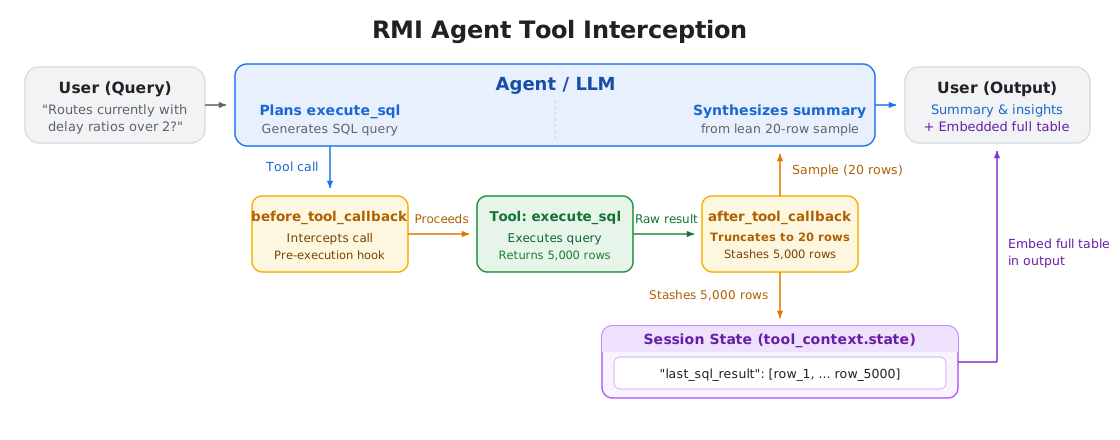
Für den RMI-Agenten fängt ein after_tool_callback die execute_sql-Ergebnisse ab, speichert die vollständige Liste der Zeilen im Sitzungsstatus und gibt ein kurzes Beispiel zusammen mit der Gesamtzahl der Zeilen zurück:
def stash_and_truncate_results(tool, args, tool_context, tool_response):
  if tool.name == "execute_sql" and "rows" in tool_response:
    rows = tool_response["rows"]
    tool_context.state["last_sql_result"] = rows      # keep everything
    tool_response["total_rows_fetched"] = len(rows)
    tool_response["rows"] = rows[:SAMPLE_LIMIT]        # show a sample
    tool_response["message"] = (
        f"Showing {SAMPLE_LIMIT} of {len(rows)} rows. "
        "Full result stashed in background state."
    )
  return tool_response
Wenn Sie ein Beispiel zurückgeben, werden die Eingabetokens in allen zukünftigen Zügen reduziert, was die Kosten und Reaktionszeiten senkt. Außerdem wird verhindert, dass große Abfrageergebnisse das Kontextfenster überlasten und die Fähigkeit des Modells beeinträchtigen, Anweisungen zu befolgen.
Achten Sie darauf, dass in Ihrem Agent-Prompt explizit erklärt wird, dass Tools standardmäßig eine Stichprobe zurückgeben. Ohne diesen Kontext kann das Modell durch unvollständige Daten verwirrt werden. Es verschwendet Rechen- und Reasoning-Tokens, um fehlende Datensätze abzugleichen, oder startet redundante Tool-Aufrufe, um die restlichen Daten abzurufen.
Beispiel: Große Ergebnismenge verarbeiten
- Der Nutzer fragt: „Welche Routen haben derzeit Verzögerungsraten über 2?“
- Die Abfrage des KI-Agents für
historical_travel_timegibt Tausende von Zeilen zurück. - Mit
after_tool_callbackwird das vollständige Ergebnis im Sitzungsstatus gespeichert und nur eine kleine Stichprobe sowie die Gesamtzahl der Zeilen zurückgegeben. - Das Modell analysiert diese Stichprobe, um die Zusammenfassung zu erstellen.
- Die Anwendung oder Downstream-Tools lesen den vollständigen Datensatz direkt aus dem Sitzungsstatus, um die vollständige Tabelle zu rendern oder für den Nutzer zu exportieren.
Wichtigste Ergebnisse
- Große Nutzlasten aus Prompts entfernen: Speichern Sie große Datasets im Sitzungsstatus, anstatt sie über den Promptverlauf hin und her zu übertragen.
- Lange Tool-Ausgaben kürzen: Verwenden Sie
after_tool_callback, um kleine Stichproben an das Modell zurückzugeben und gleichzeitig die vollständigen Ergebnisse im Sitzungsstatus zu speichern. - Modell über Stichproben informieren: Fügen Sie eine Prompt-Regel hinzu, in der erklärt wird, dass Ergebnisse als Stichproben erhoben werden, um Verwirrung des Modells, verschwendete Reasoning-Tokens und redundante Tool-Aufrufe zu vermeiden.
Nächste Schritte
- ADK-Callback-Referenz: In der offiziellen ADK-Callback-Anleitung finden Sie Details zum Abfangen auf Modell-, Agent- und Tool-Ebene.
Beitragende
Nathaniel Thomas | Software Engineering Intern, Google Maps Platform