

نظرة عامة
عند التعامل مع مجموعات بيانات كبيرة، يؤدي تمرير البيانات الأولية مباشرةً من خلال النموذج إلى حدوث مشاكل، مثل بطء الاستجابة وزيادة تكاليف الرموز المميّزة وحدوث أخطاء في الاستدلال. يمكن أن تمتد بيانات RMI إلى ملايين الصفوف، لذا فإنّ السماح للوكيل بالاستعلام عن كمية غير محدودة واستيعابها بالكامل للتحليل أمر مكلف من حيث الرموز المميّزة ويؤدي إلى تضخيم نافذة السياق، ما يقلل من أداء الوكيل في كل دور لاحق.
على سبيل المثال، يمكن أن يعرض طلب البحث في جدول RMI historical_travel_time
آلاف الصفوف الخاصة بأجزاء الطرق. فإعادة مجموعة النتائج الكاملة إلى سجلّ المحادثة يؤدي إلى إبطاء كل دور لاحق، وزيادة التكلفة، وتشتيت انتباه النموذج عن إنشاء الإجابة النهائية.
لا يمكن حلّ هذه المشاكل من خلال تعليمات الطلبات فقط. الطريقة الوحيدة الموثوقة هي اعتراض طلبات الأدوات وتوجيه حمولات البيانات الكبيرة خارج نافذة سياق النموذج.
عمليات إعادة استدعاء أدوات ADK
توفّر حزمة ADK عمليات ردّ اتصال لاعتراض تنفيذ الأدوات. لمعالجة مجموعات النتائج الكبيرة، استخدِم after_tool_callback:
-
before_tool_callback(tool, args, tool_context): يتم تشغيلها بعد أن يختار النموذج أداة، ولكن قبل تنفيذ الأداة. -
after_tool_callback(tool, args, tool_context, tool_response): يتم تشغيلها بعد انتهاء الأداة، ولكن قبل إرسال النتيجة إلى النموذج. يمكنك استخدامها لتعديل ردّ الأداة.
تتلقّى دالة الاستدعاء عنصر tool_context مع إمكانية الوصول إلى الجلسة state.
يتيح لك ذلك تخزين مجموعات بيانات كبيرة في الذاكرة في الخلفية على مدار المحادثة
بدون إدخالها في طلب النموذج.
# root_agent = llm_agent.Agent(
#     ...,
#     after_tool_callback=stash_and_truncate_results,
# )
الاقتطاع والتخزين المؤقت بعد التنفيذ
الهدف: عرض عيّنة صغيرة من نتائج طلب البحث للنموذج من أجل اتّخاذ القرار، مع حفظ مجموعة البيانات الكاملة للنتائج النهائية.
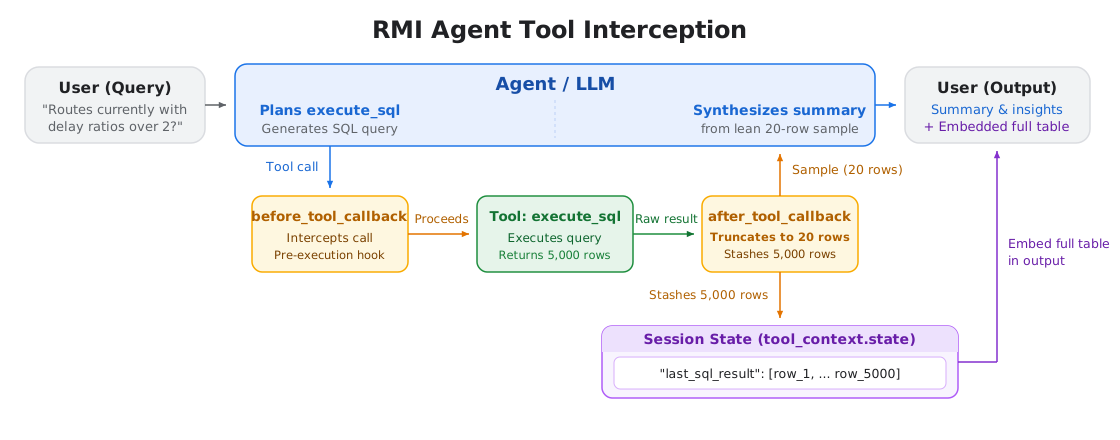
بالنسبة إلى وكيل RMI، يعترض after_tool_callback نتائج execute_sql،
ويحفظ القائمة الكاملة للصفوف في حالة الجلسة، ويعرض عيّنة قصيرة مع
إجمالي عدد الصفوف:
def stash_and_truncate_results(tool, args, tool_context, tool_response):
  if tool.name == "execute_sql" and "rows" in tool_response:
    rows = tool_response["rows"]
    tool_context.state["last_sql_result"] = rows      # keep everything
    tool_response["total_rows_fetched"] = len(rows)
    tool_response["rows"] = rows[:SAMPLE_LIMIT]        # show a sample
    tool_response["message"] = (
        f"Showing {SAMPLE_LIMIT} of {len(rows)} rows. "
        "Full result stashed in background state."
    )
  return tool_response
يؤدي تقديم نموذج إلى تقليل الرموز المميّزة للإدخال في جميع الجولات المستقبلية، ما يقلل من التكاليف وأوقات الاستجابة. ويمنع أيضًا نتائج طلبات البحث الكبيرة من ملء قدرة الاستيعاب والتأثير سلبًا في قدرة النموذج على اتّباع التعليمات.
تأكَّد من أنّ طلب الوكيل يوضّح صراحةً أنّ الأدوات تعرض عيّنة من البيانات حسب التصميم. بدون هذا السياق، قد يواجه النموذج صعوبة في فهم البيانات الجزئية، ما يؤدي إلى إهدار الرموز المميّزة المخصّصة للمعالجة والاستدلال في محاولة للتوفيق بين السجلات المفقودة أو إطلاق طلبات متكررة للأدوات من أجل جلب بقية البيانات.
مثال: معالجة مجموعة نتائج كبيرة
- يسأل المستخدم: "ما هي المسارات التي تتجاوز فيها نِسب التأخير 2 في الوقت الحالي؟"
- يؤدي طلب الوكيل من "
historical_travel_time" إلى عرض آلاف الصفوف. - يحفظ
after_tool_callbackالنتيجة الكاملة في حالة الجلسة ويعرض عينة صغيرة فقط بالإضافة إلى إجمالي عدد الصفوف. - يحلّل النموذج هذه العيّنة لإنشاء الملخّص.
- يقرأ التطبيق أو الأدوات اللاحقة مجموعة البيانات الكاملة مباشرةً من حالة الجلسة لعرض الجدول الكامل أو تصديره للمستخدم.
الخلاصات الرئيسية
- تجنُّب تضمين حمولات كبيرة في الطلبات: يمكنك تخزين مجموعات البيانات الكبيرة في حالة الجلسة بدلاً من تمريرها ذهابًا وإيابًا من خلال سجلّ الطلبات.
- اقتطاع مخرجات الأدوات الكبيرة: استخدِم
after_tool_callbackلعرض عيّنات صغيرة للنموذج مع حفظ النتائج الكاملة في حالة الجلسة. - إعلام النموذج بالعيّنات: أضِف قاعدة في الطلب توضّح أنّ النتائج مستندة إلى عيّنات لتجنُّب حدوث التباس في النموذج، وإهدار الرموز المميّزة للاستدلال، واستدعاءات الأدوات المكرّرة.
الخطوات التالية
- مرجع عمليات الاستدعاء في ADK: يمكنك الاطّلاع على دليل عمليات الاستدعاء في ADK الرسمي للحصول على تفاصيل حول الاعتراض على مستوى النموذج والوكيل والأداة.
المساهمون
ناثانيال توماس | متدرّب في هندسة البرمجيات، "منصة خرائط Google"