

Objetivo
O tutorial Validação de endereços em grande volume mostrou diferentes cenários em que esse recurso pode ser usado. Neste tutorial, vamos apresentar diferentes padrões de design no Google Cloud Platform para executar a validação de endereços em alto volume.
Vamos começar com uma visão geral sobre como executar a High Volume Address Validation no Google Cloud Platform com o Cloud Run, o Compute Engine ou o Google Kubernetes Engine para execuções únicas. Depois, vamos ver como esse recurso pode ser incluído em um pipeline de dados.
Ao final deste artigo, você vai entender as diferentes opções para executar a Address Validation em alto volume no seu ambiente do Google Cloud.
Arquitetura de referência no Google Cloud Platform
Nesta seção, vamos analisar os diferentes padrões de design para a High Volume Address Validation usando o Google Cloud Platform. Ao executar no Google Cloud Platform, é possível fazer a integração com seus processos e pipelines de dados atuais.
Executar a High Volume Address Validation uma vez no Google Cloud Platform
Veja abaixo uma arquitetura de referência de como criar uma integração no Google Cloud Platform que é mais adequada para operações únicas ou testes.

Nesse caso, recomendamos fazer upload do arquivo CSV para um bucket do Cloud Storage. O script da High Volume Address Validation pode ser executado em um ambiente do Cloud Run. No entanto, é possível executá-lo em qualquer outro ambiente de execução, como o Compute Engine ou o Google Kubernetes Engine. O CSV de saída também pode ser enviado para o bucket do Cloud Storage.
Execução como um pipeline de dados do Google Cloud Platform
O padrão de implantação mostrado na seção anterior é ótimo para testar rapidamente a High Volume Address Validation para uso único. No entanto, se você precisar usá-lo regularmente como parte de um pipeline de dados, poderá aproveitar melhor os recursos nativos do Google Cloud Platform para torná-lo mais robusto. Algumas das mudanças que você pode fazer incluem:
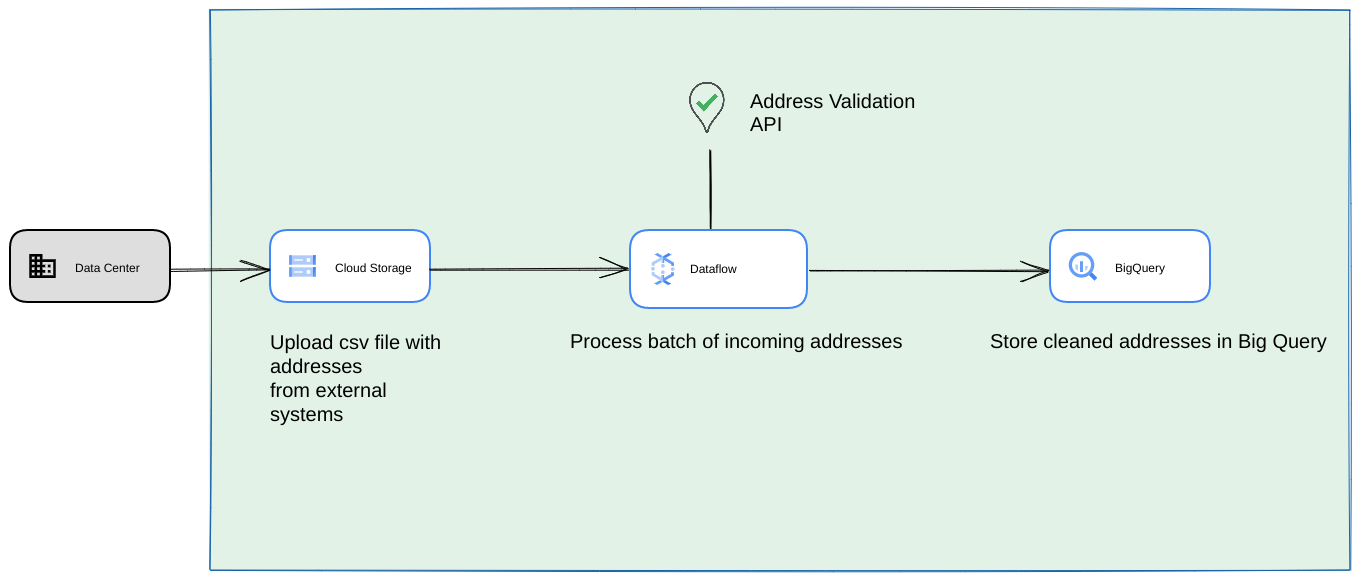
- Nesse caso, é possível despejar arquivos CSV em buckets do Cloud Storage.
- Um job do Dataflow pode coletar os endereços a serem processados e armazená-los em cache no BigQuery.
- A biblioteca do Dataflow para Python pode ser estendida para incluir a lógica da High Volume Address Validation e validar os endereços do job do Dataflow.
Executar o script de um pipeline de dados como um processo recorrente de longa duração
Outra abordagem comum é validar um lote de endereços como parte de um pipeline de dados de streaming como um processo recorrente. Você também pode ter os endereços em um repositório de dados do BigQuery. Nesta abordagem, vamos ver como criar um pipeline de dados recorrente (que precisa ser acionado diariamente/semanalmente/mensalmente)

- Faça upload do arquivo CSV inicial em um bucket do Cloud Storage.
- Use o Memorystore como um repositório de dados permanente para manter o estado intermediário do processo de longa duração.
- Armazene em cache os endereços finais em um repositório de dados do BigQuery.
- Configure o Cloud Scheduler para executar o script periodicamente.
Essa arquitetura tem as seguintes vantagens:
- Com o Cloud Scheduler, a validação de endereço pode ser feita periodicamente. É recomendável revalidar os endereços mensalmente ou validar os novos endereços mensalmente/trimestralmente. Essa arquitetura ajuda a resolver esse caso de uso.
Se os dados do cliente estiverem no BigQuery, os endereços validados ou as flags de validação poderão ser armazenados em cache diretamente lá. Observação: o que pode ser armazenado em cache e como isso é feito está descrito em detalhes no artigo sobre a High Volume Address Validation.
O uso do Memorystore oferece maior resiliência e capacidade de processar mais endereços. Essa etapa adiciona um estado a todo o pipeline de processamento, o que é necessário para lidar com conjuntos de dados de endereços muito grandes. Outras tecnologias de banco de dados, como o Cloud SQL [https://cloud.google.com/sql] ou qualquer outro tipo de banco de dados oferecido pelo Google Cloud Platform, também podem ser usadas aqui. No entanto, acreditamos que o Memorystore equilibra perfeitamente as necessidades de escalonamento e simplicidade, por isso deve ser a primeira escolha.
Conclusão
Ao aplicar os padrões descritos aqui, você pode usar a API Address Validation para diferentes casos de uso no Google Cloud Platform.
Escrevemos uma biblioteca Python de código aberto para ajudar você a começar a usar os casos de uso descritos acima. Ela pode ser invocada em uma linha de comando no seu computador, no Google Cloud Platform ou em outros provedores de nuvem.
Saiba como usar a biblioteca neste artigo.
Próximas etapas
Baixe o artigo Melhore a finalização da compra, o envio e as operações com endereços confiáveis e assista ao webinar Melhorando a finalização da compra, o envio e as operações com a Address Validation .
Sugestões de leitura:
- Documentação da API Address Validation
- Geocodificação e Address Validation
- Confira a demonstração da Address Validation.
Colaboradores
O Google mantém este artigo. Os colaboradores a seguir escreveram o conteúdo original.
Autores principais:
Henrik Valve | Engenheiro de soluções
Thomas Anglaret | Engenheiro de soluções
Sarthak Ganguly | Engenheiro de soluções