

目標
High Volume Address Validation のチュートリアルでは、High Volume Address Validation を使用できるさまざまなシナリオについて説明しました。このチュートリアルでは、Google Cloud Platform 内で High Volume Address Validation を実行するためのさまざまな設計パターンを紹介します。
まず、Google Cloud Platform で Cloud Run、Compute Engine、または Google Kubernetes Engine を使用して、1 回限りの実行で High Volume Address Validation を実行する方法の概要を説明します。次に、この機能をデータ パイプラインの一部として組み込む方法について説明します。
この記事を読み終える頃には、Google Cloud 環境で Address Validation を大量に実行するためのさまざまなオプションについて、理解が深まっているはずです。
Google Cloud Platform 上のリファレンス アーキテクチャ
このセクションでは、Google Cloud Platform を使用した大量の Address Validation のさまざまな設計パターンについて詳しく説明します。Google Cloud Platform で実行することで、既存のプロセスやデータ パイプラインと統合できます。
Google Cloud Platform で High Volume Address Validation を 1 回実行する
以下に、Google Cloud Platform で統合を構築する方法のリファレンス アーキテクチャを示します。これは、1 回限りのオペレーションやテストに適しています。

この場合は、CSV ファイルを Cloud Storage バケットにアップロードすることをおすすめします。その後、Cloud Run 環境から High Volume Address Validation スクリプトを実行できます。ただし、Compute Engine や Google Kubernetes Engine などの他のランタイム環境で実行することもできます。出力 CSV を Cloud Storage バケットにアップロードすることもできます。
Google Cloud Platform データ パイプラインとして実行する
前のセクションで示したデプロイ パターンは、High Volume Address Validation を 1 回だけ使用して、すばやくテストするのに適しています。ただし、データ パイプラインの一部として定期的に使用する必要がある場合は、Google Cloud Platform のネイティブ機能を活用して、より堅牢にすることができます。変更できる設定には、次のようなものがあります。

- この場合、CSV ファイルを Cloud Storage バケットにダンプできます。
- Dataflow ジョブは、処理対象のアドレスを取得して BigQuery にキャッシュできます。
- Dataflow Python ライブラリを拡張して、Dataflow ジョブからアドレスを検証する High Volume Address Validation のロジックを組み込むことができます。
データ パイプラインからスクリプトを長時間実行される繰り返しプロセスとして実行する
もう 1 つの一般的なアプローチは、定期的なプロセスとして、ストリーミング データ パイプラインの一部として住所のバッチを検証することです。BigQuery データストアにアドレスが保存されている場合もあります。このアプローチでは、繰り返し実行されるデータ パイプライン(毎日、毎週、毎月トリガーする必要がある)を構築する方法について説明します。
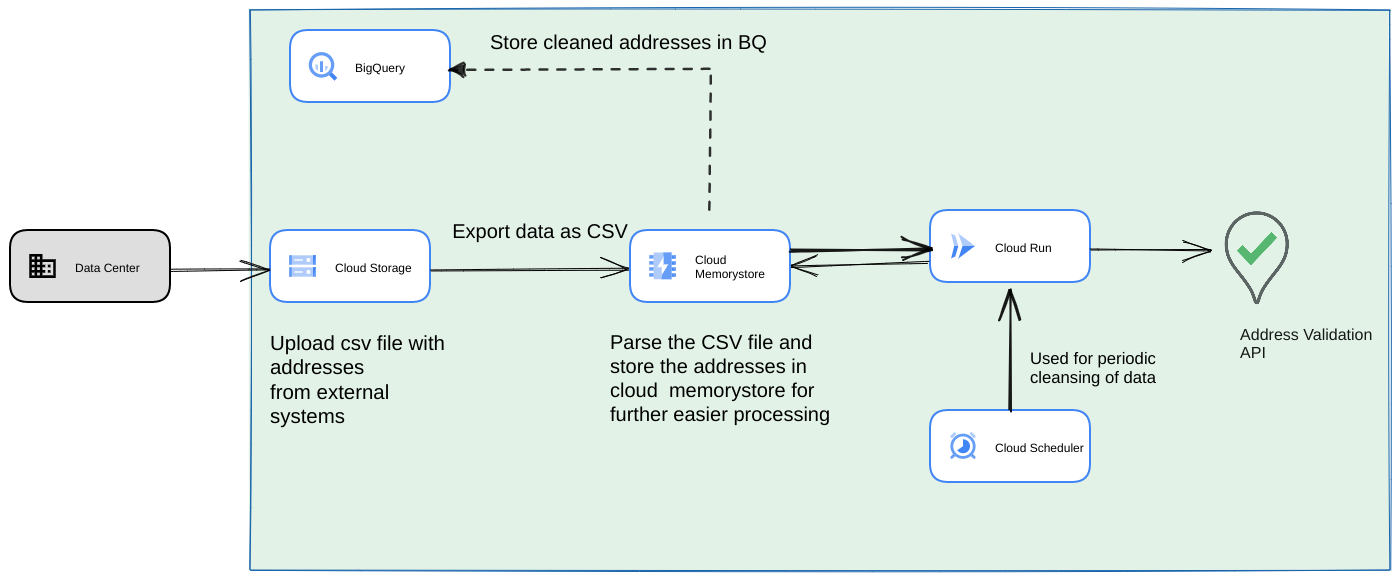
- 最初の CSV ファイルを Cloud Storage バケットにアップロードします。
- Memorystore を永続データストアとして使用して、長時間実行プロセスの中間状態を維持します。
- 最終的な住所を BigQuery データストアにキャッシュします。
- スクリプトを定期的に実行するように Cloud Scheduler を設定します。
このアーキテクチャには、次のメリットがあります。
- Cloud Scheduler を使用すると、Address Validation を定期的に行うことができます。アドレスを毎月再検証したり、新しいアドレスを毎月または四半期ごとに検証したりすることをおすすめします。このアーキテクチャは、このユースケースの解決に役立ちます。
顧客データが BigQuery にある場合は、検証済みの住所または検証フラグをそこに直接キャッシュできます。注: キャッシュに保存できる内容とその方法については、High Volume Address Validation の記事で詳しく説明されています。
Memorystore を使用すると、復元力が高まり、より多くのアドレスを処理できるようになります。このステップでは、非常に大規模な住所データセットの処理に必要なステートフル性を処理パイプライン全体に追加します。Cloud SQL [https://cloud.google.com/sql] などの他のデータベース テクノロジーや、Google Cloud Platform が提供するその他のデータベースの種類も、ここで使用できます。しかし、Memorystore はスケーリングとシンプルさのニーズを完璧にバランスさせているため、最初の選択肢となるべきだと考えています。
まとめ
ここで説明するパターンを適用することで、Google Cloud Platform でさまざまなユースケースに Address Validation API を使用できます。
Google は、上記のユースケースをすぐに開始できるように、オープンソースの Python ライブラリを作成しました。パソコンのコマンドラインから呼び出すことも、Google Cloud Platform や他のクラウド プロバイダから呼び出すこともできます。
ライブラリの使用方法について詳しくは、こちらの記事をご覧ください。
次のステップ
信頼性の高い住所で購入手続き、配送、オペレーションを改善する ホワイトペーパーをダウンロードし、Address Validation で購入手続き、配送、オペレーションを改善する ウェブセミナーをご覧ください。
おすすめの関連情報:
寄稿者
この記事は Google が管理しています。このドキュメントは、以下のコントリビューターによって作成されました。
主な著者:
Henrik Valve | ソリューション エンジニア
Thomas Anglaret | ソリューション エンジニア
Sarthak Ganguly | ソリューション エンジニア