
در این سند، با نحوه استفاده از دادههای نمونه شناسه جا از بینشهای تحلیلی جاها بااستفاده از توابع شمارش جا درکنار جستجوهای هدفمند جزئیات جا برای ایجاد اطمینان در نتایج خود آشنا خواهید شد.
برای پیادهسازی مرجع دقیق این الگو، این دفتر یادداشت توضیحی را ببینید:
 اجرا کردن در Google Colab
 مشاهده منبع در GitHub
الگوی معماری
این الگوی معماری به شما یک گردش کار تکرارپذیر میدهد تا فاصله بین تحلیل آماری سطح بالا و درستیسنجی واقعیت عینی را پر کنید. با ترکیب کردن مقیاس BigQuery با دقت Places API، میتوانید یافتههای تحلیلی خود را با اطمینان اعتبارسنجی کنید. این بهویژه برای انتخاب سایت، تحلیل رقبا، و پژوهش بازار که اعتماد به دادهها در آنها بسیار مهم است مفید است.
هسته این الگو شامل چهار مرحله کلیدی است:
- انجام تجزیهوتحلیل در مقیاس بزرگ: از تابع شمارش جا از بینشهای تحلیلی جاها در BigQuery برای تجزیهوتحلیل دادههای جا در یک منطقه جغرافیایی بزرگ، مانند کل شهر یا منطقه، استفاده کنید.
- جداسازی و استخراج نمونهها: نواحی موردنظر (مثلاً «نقاط داغ» با تراکم بالا) را از نتایج انبوهشی شناسایی کنید و
sample_place_idsارائهشده توسط تابع را استخراج کنید. - بازیابی جزئیات واقعیت عینی: از شناسههای جا استخراجشده برای برقراری تماسهای هدفمند با میانای برنامهسازی کاربردی جزئیات جا استفاده کنید تا جزئیات غنی و واقعی هر جا را واکشی کنید.
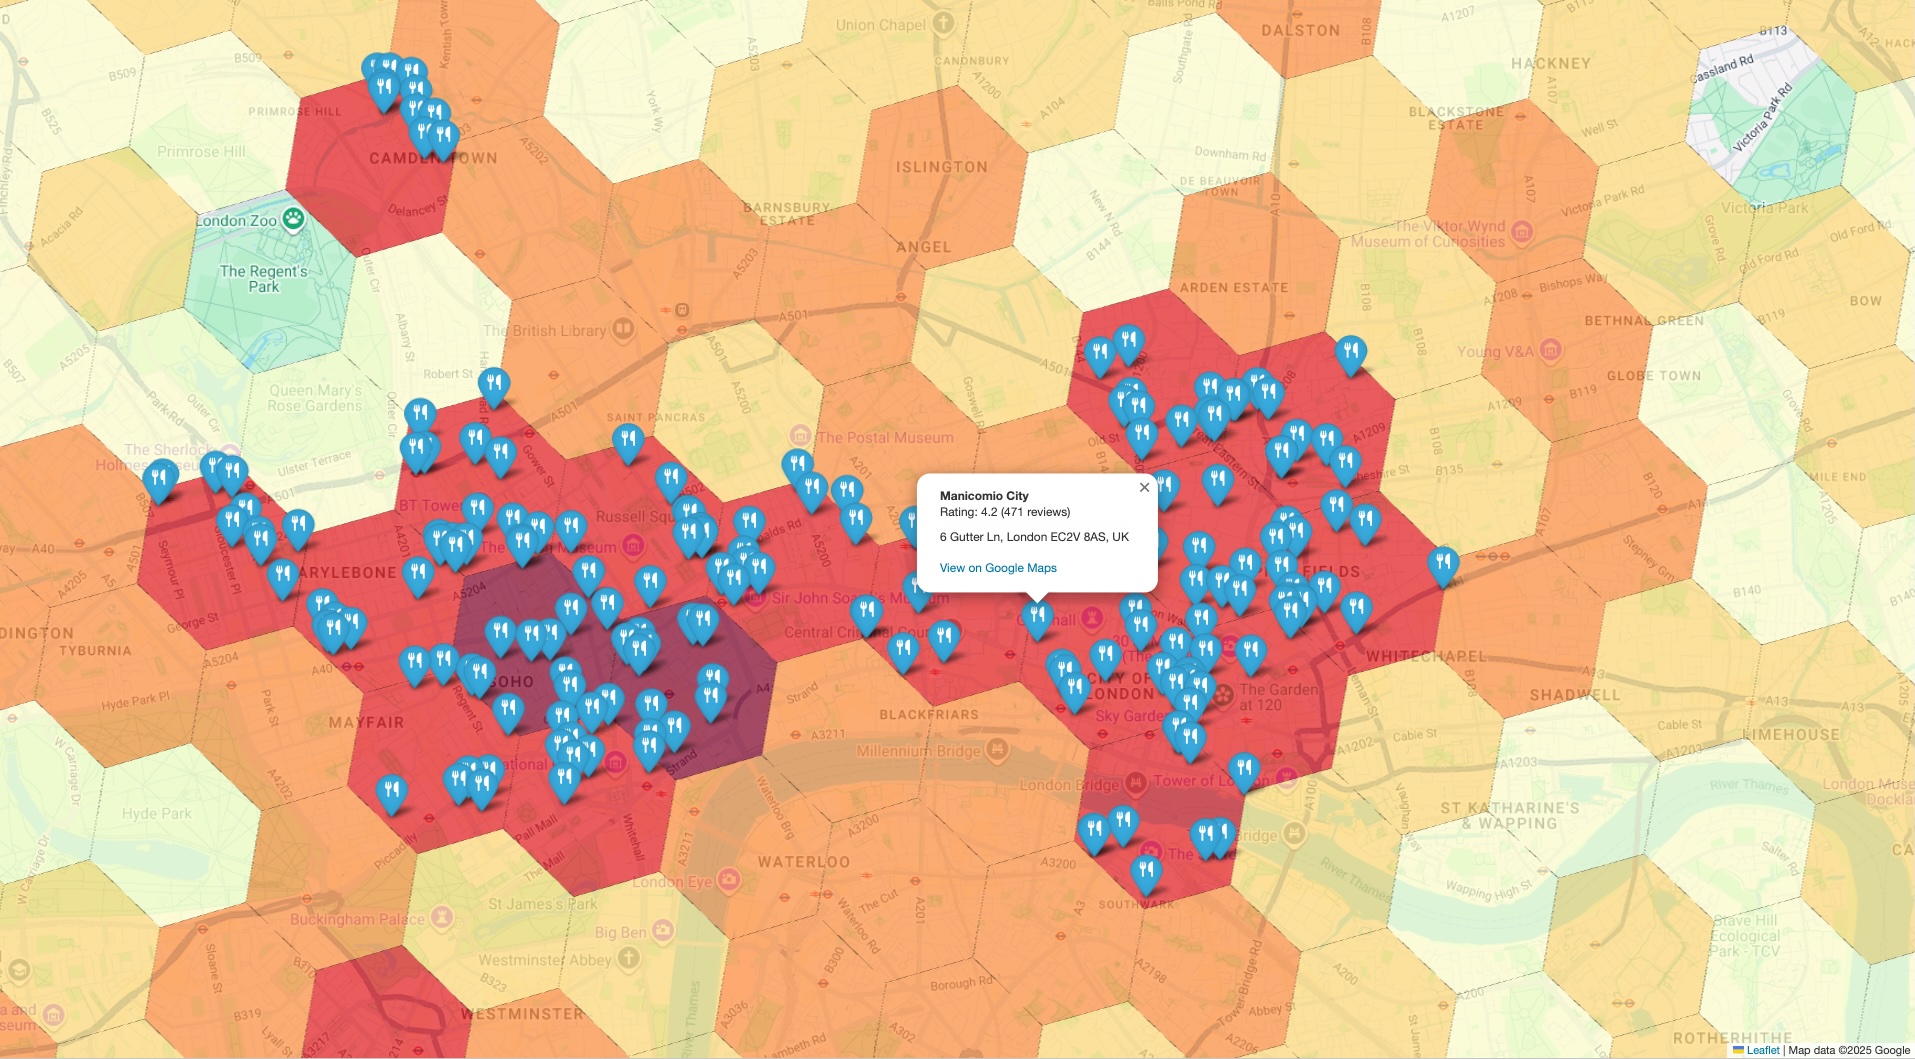
- ایجاد کردن تجسم ترکیبی: دادههای تفصیلی مکان را روی نقشه آماری سطح بالای اولیه لایهبندی کنید تا بهصورت دیداری تأیید کنید که تعداد انبوهه واقعیت را در محل منعکس میکند.
گردش کار راهحل
این گردش کار به شما امکان میدهد فاصله بین روندهای سطح کلان و حقایق سطح خرد را پر کنید. با یک نمای آماری گسترده شروع میکنید و بهطور راهبردی به جزئیات میپردازید تا دادهها را با مثالهای واقعی و خاص تأیید کنید.
تجزیهوتحلیل تراکم مکان در مقیاس با «بینشهای تحلیلی جاها»
اولین قدم شما این است که چشمانداز را در سطح بالایی درک کنید. بهجای واکشی هزاران نقطه موردعلاقه (POI) تکی، میتوانید یک پُرسمان تکی را برای دریافت خلاصه آماری اجرا کنید.
تابع PLACES_COUNT_PER_H3
«بینشهای تحلیلی جاها»
برای این کار ایدهآل است. این ابزار تعداد نقاط جالب را در یک سیستم شبکه ششضلعی (H3) جمعآوری میکند و به شما امکان میدهد تا بهسرعت مناطق با تراکم بالا یا پایین را براساس معیارهای خاص خود (مثلاً رستورانهای فعال با رتبهبندی بالا) شناسایی کنید.
یک پُرسمان نمونه در زیر آمده است. توجه داشته باشید که باید منطقه جغرافیایی جستجویتان را ارائه دهید. از مجموعهداده باز، مثل مجموعهداده عمومی BigQuery مربوط به Overture Maps Data، میتوان برای بازیابی دادههای مرز جغرافیایی استفاده کرد.
برای مرزهای مجموعهداده باز که مکرراً استفاده میشوند، توصیه میکنیم آنها را در جدولی در پروژه خودتان محقق کنید. این کار هزینههای BigQuery را بهطور قابلتوجهی کاهش میدهد و عملکرد پُرسمان را بهبود میبخشد.
-- This query counts all highly-rated, operational restaurants
-- across a large geography, grouping them into H3 cells.
SELECT *
FROM
  `places_insights___gb.PLACES_COUNT_PER_H3`(
    JSON_OBJECT(
      'geography', your_defined_geography,
      'h3_resolution', 8,
      'types', ['restaurant'],
      'business_status', ['OPERATIONAL'],
      'min_rating', 3.5
    )
  );
فیلتر کردن و اعتبارسنجی براساس شناسه نمانام
اگر میخواهید تعداد و شناسه مکانهای نمونه را برای نمانامهای خاصی اعتبارسنجی کنید،
فهرستی از شناسههای نمانام را بااستفاده از فیلتر brand_ids ارائه دهید.
برای دریافت شناسه نمانام برای نمانام هدف، جدول brands را در BigQuery پُرسمان کنید:
SELECT id, name
FROM `YOUR_PROJECT.places_insights___us.brands`
WHERE LOWER(name) LIKE "%starbucks%";
پساز بازیابی شناسه نمانام هدف (برای مثال، "1413758728321880760"
برای Starbucks)، آن را در آرایه فیلتر brand_ids ارسال کنید:
SELECT *
FROM
  `places_insights___us.PLACES_COUNT_PER_H3`(
    JSON_OBJECT(
      'geography', your_defined_geography,
      'h3_resolution', 8,
      'brand_ids', ["1413758728321880760"]
    )
  );
درطول مرحله ۳، درستیسنجی واقعیت عینی، بهجای تأیید اینکه مکان با دستههای عمومی مطابقت دارد، میتوانید نام نمایشی برگرداندهشده توسط Place Details API را بااستفاده از تطابق عبارت باقاعده بهصورت برنامهنویسیشده با نام نمانام موردانتظارتان مقایسه کنید. برای مثال، میتوانید فیلد
response.display_name.text را مقایسه کنید.
خروجی این پُرسمان جدولی از سلولهای H3 و تعداد مکانهای درون هرکدام را به شما میدهد که پایه و اساس نقشه حرارتی تراکم را تشکیل میدهد.
جداسازی نقاط پربازدید و استخراج شناسه مکانهای نمونه
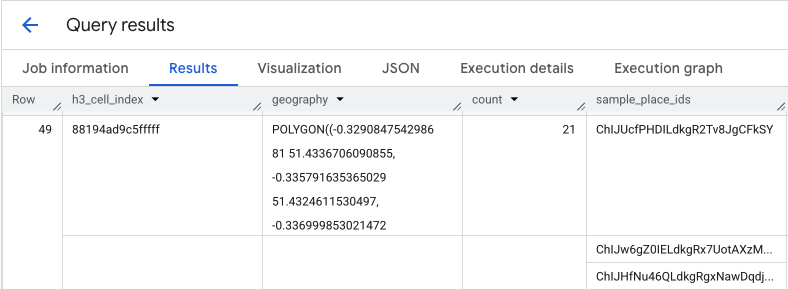
نتیجه تابع PLACES_COUNT_PER_H3 همچنین آرایهای از
sample_place_ids را برمیگرداند، حداکثر ۲۵۰ شناسه مکان برای هر عنصر پاسخ. این شناسهها
پیوند بین آمار انبوهشی و مکانهای مجزایی است که
در آن مشارکت دارند.
سیستم شما میتواند ابتدا مرتبطترین سلولها را از پُرسمان اولیه شناسایی کند.
برای مثال، میتوانید ۲۰ سلول برتر با بیشترین تعداد را انتخاب کنید. سپس،
از این نقاط مهم، sample_place_ids را در یک فهرست واحد ادغام میکنید.
این فهرست نمونهای گلچینشده از جالبترین نقاط موردعلاقه از مرتبطترین مناطق را نشان میدهد و شما را برای درستیسنجی هدفمند آماده میکند.
اگر نتایج BigQuery خود را در Python بااستفاده از pandas DataFrame پردازش میکنید، منطق استخراج این شناسهها ساده است:
# Assume 'results_df' is a pandas DataFrame from your BigQuery query.

# 1. Identify the 20 busiest H3 cells by sorting and taking the top results.
top_hotspots_df = results_df.sort_values(by='count', ascending=False).head(20)

# 2. Extract and flatten the lists of sample_place_ids from these hotspots.
# The .explode() function creates a new row for each ID in the lists.
all_sample_ids = top_hotspots_df['sample_place_ids'].explode()

# 3. Create a final list of unique Place IDs to verify.
place_ids_to_verify = all_sample_ids.unique().tolist()

print(f"Consolidated {len(place_ids_to_verify)} unique Place IDs for spot-checking.")
اگر از زبانهای برنامهنویسی دیگر استفاده میکنید، میتوانید منطق مشابهی را اعمال کنید.
بازیابی جزئیات واقعیت عینی با Places API
با فهرست یکپارچه «شناسههای مکان»، اکنون از تجزیهوتحلیل در مقیاس بزرگ به بازیابی دادههای خاص منتقل میشوید. از این شناسهها برای جستجوی میانای برنامهسازی کاربردی «جزئیات مکان» برای اطلاعات دقیق درباره هر مکان نمونه استفاده خواهید کرد.
این مرحله اعتبارسنجی بسیار مهم است. درحالیکه «بینشهای تحلیلی جاها» به شما میگوید چند رستوران در یک منطقه وجود دارد، Places API به شما میگوید آنها کدام رستورانها هستند و نام، نشانی دقیق، طول/عرض جغرافیایی، ردهبندی کاربر، و حتی پیوند مستقیم به مکان آنها در Google Maps را ارائه میدهد. این کار دادههای نمونه شما را غنی میکند و شناسههای انتزاعی را به مکانهای واقعی و قابلتأیید تبدیل میکند.
برای مشاهده فهرست کامل دادههای دردسترس از Place Details API و هزینه مربوط به بازیابی، اسناد API را مرور کنید.
درخواست به Places API برای شناسه خاص بااستفاده از کتابخانه مشتری Python بهاینصورت خواهد بود. برای جزئیات بیشتر، به نمونههای کتابخانه مشتری Places API (جدید) مراجعه کنید.
# A request to fetch details for a single Place ID.
request = {"name": f"places/{place_id}"}

# Define the fields you want returned in the response as a comma-separated string.
fields_to_request = "formattedAddress,location,displayName,googleMapsUri"

# The response contains ground truth data.
response = places_client.get_place(
    request=request,
    metadata=[("x-goog-fieldmask", fields_to_request)]
)
توجه داشته باشید که فیلدهای این درخواست دادهها را از دو شناسه محصول صورتحساب متفاوت استخراج میکنند.
formattedAddressوlocationبخشی از واحد نگهداری موجودی ضروریات جزئیات جا هستند.displayNameوgoogleMapsUriبخشی از Place Details Pro SKU هستند.
وقتی یک درخواست «جزئیات جا» شامل فیلدهایی از چند SKU باشد، کل درخواست با نرخ SKU بالاترین سطح صورتحساب میشود. بنابراین، این فراخوانی خاص بهعنوان درخواست Place Details Pro صورتحساب میشود.
برای کنترل هزینههایتان، همیشه از FieldMask استفاده کنید تا فقط فیلدهایی را درخواست کنید که برنامهتان نیاز دارد.
ایجاد تجسم ترکیبی برای اعتبارسنجی
مرحله آخر این است که هر دو مجموعه داده را در یک نمای واحد کنار هم قرار دهید. این روش فوری و شهودی برای بررسی نقطهای تحلیل اولیه شما ارائه میدهد. تجسم شما باید دو لایه داشته باشد:
- لایه پایه: نقشه رنگی یا نقشه حرارتی تولیدشده از نتایج اولیه
PLACES_COUNT_PER_H3که تراکم کلی مکانها را در سراسر جغرافیای شما نشان میدهد. - لایه بالایی: مجموعهای از نشانگرهای مجزا برای هر نقطه موردعلاقه نمونه، که بااستفاده از مختصات دقیق بازیابیشده از Places API در مرحله قبلی ترسیم شده است.
منطق ساخت این نمای ترکیبی در این مثال شبهکد بیان شده است:
# Assume 'h3_density_data' is your aggregated data from Step 1.
# Assume 'detailed_places_data' is your list of place objects from Step 3.

# Create the base choropleth map from the H3 density data.
# The 'count' column determines the color of each hexagon.
combined_map = create_choropleth_map(
    data=h3_density_data,
    color_by_column='count'
)

# Iterate through the detailed place data to add individual markers.
for place in detailed_places_data:
    # Construct the popup information with key details and a link.
    popup_html = f"""
    <b>{place.name}</b><br>
    Address: {place.address}<br>
    <a href="{place.google_maps_uri}" target="_blank">View on Maps</a>
    """

    # Add a marker for the current place to the base map.
    combined_map.add_marker(
        location=[place.latitude, place.longitude],
        popup=popup_html,
        tooltip=place.name
    )

# Display the final map with both layers.
display(combined_map)
با همپوشانی نشانگرهای خاص واقعیت عینی روی نقشه تراکم سطح بالا، میتوانید فوراً تأیید کنید که مناطقی که بهعنوان کانون شناسایی شدهاند، درواقع، دارای تراکم بالایی از مکانهایی هستند که درحال تجزیهوتحلیل آنها هستید. این تأیید بصری اعتماد قابلتوجهی به نتیجهگیریهای مبتنی بر داده شما ایجاد میکند.
نتیجهگیری
این الگوی معماری روشی قدرتمند و کارآمد برای اعتبارسنجی اطلاعات آماری جغرافیایی در مقیاس بزرگ ارائه میدهد. با بهرهگیری از «بینشهای تحلیلی جاها» برای تحلیل گسترده و مقیاسپذیر و Place Details API برای درستیسنجی هدفمند و واقعیت عینی، یک حلقه بازخورد قدرتمند ایجاد میکنید. این امر تضمین میکند که تصمیمات راهبردی شما، چه در انتخاب مکان خردهفروشی و چه در برنامهریزی لجستیک، براساس دادههایی باشد که نهتنها ازنظر آماری معنادار هستند، بلکه دقت آنها نیز قابلتأیید است.
مراحل بعدی
- توابع شمارش مکان دیگر را کاوش کنید تا ببینید چگونه میتوانند به سؤالات تحلیلی مختلف پاسخ دهند.
- اسناد Places API را مرور کنید تا فیلدهای دیگری را که میتوانید برای غنیتر کردن تحلیل خود درخواست کنید، کشف کنید.
همیاران
هنریک والو | مهندس DevX