

このドキュメントでは、Places Insights のサンプル プレイス ID データと Place Count Functions を使用し、Place Details のルックアップを組み合わせて、信頼性の高い結果を得る方法について説明します。
このパターンの詳細なリファレンス実装については、次の説明用ノートブックをご覧ください。
 Google Colab で実行
 GitHub 上のソースを見る
アーキテクチャ パターン
このアーキテクチャ パターンは、高レベルの統計分析とグラウンド トゥルース検証のギャップを埋める、繰り返し可能なワークフローを提供します。BigQuery のスケールと Places API の精度を組み合わせることで、分析結果を確実に検証できます。これは、データへの信頼が最も重要となるサイトの選択、競合他社の分析、市場調査に特に役立ちます。
このパターンの中心となるのは、次の 4 つの主要なステップです。
- 大規模な分析を実行する: BigQuery の Places Insights の場所カウント関数を使用して、都市全体や地域全体など、広範囲の地理にわたる場所データを分析します。
- サンプルを分離して抽出する: 集計結果から関心のある領域(高密度の「ホットスポット」など)を特定し、関数によって提供される
sample_place_idsを抽出します。 - グラウンド トゥルースの詳細を取得する: 抽出したプレイス ID を使用して、Place Details API を呼び出し、各場所の豊富な実際の詳細情報を取得します。
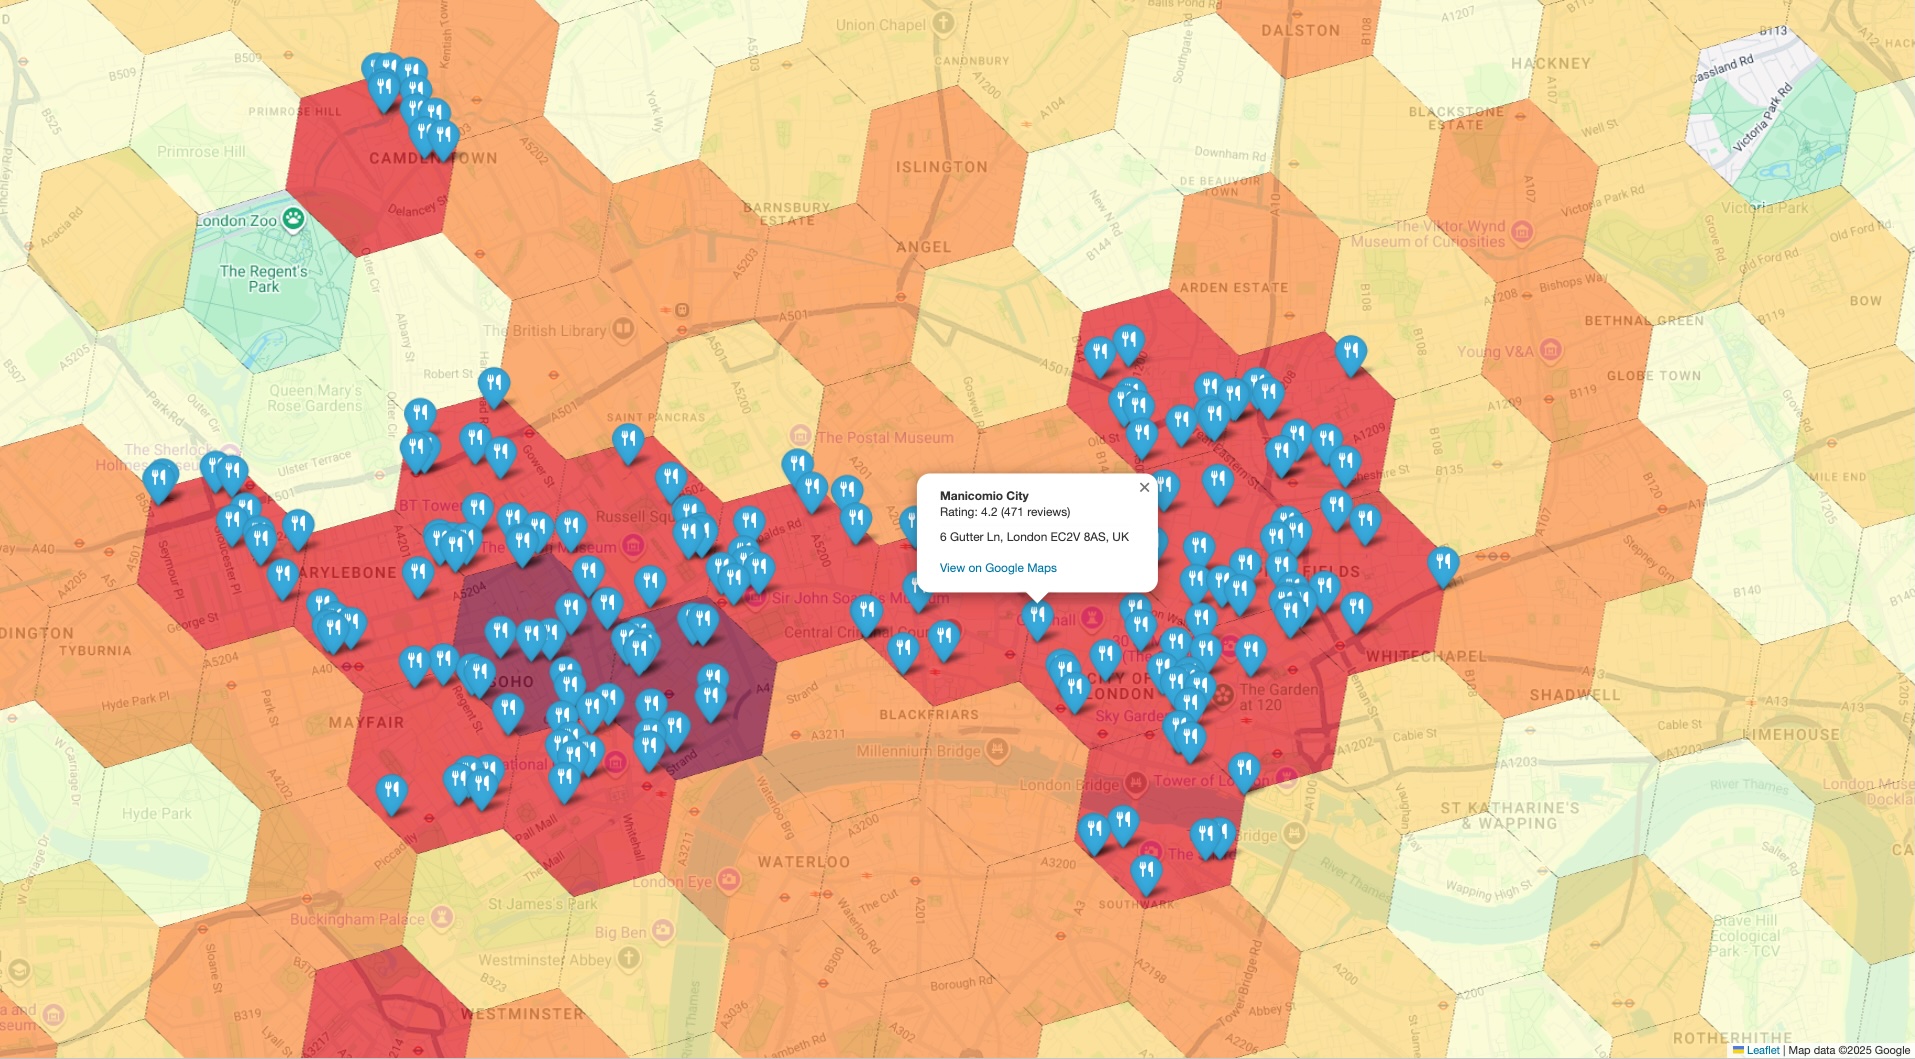
- 統合された可視化を作成する: 詳細な場所データを初期の高レベルの統計地図の上に重ねて、集計された数が現地の現実を反映していることを視覚的に検証します。
ソリューションのワークフロー
このワークフローを使用すると、マクロレベルの傾向とミクロレベルの事実のギャップを埋めることができます。まず、広範な統計ビューから始めて、戦略的にドリルダウンして、具体的な実際の例でデータを確認します。
Places Insights を使用して場所の密度を大規模に分析する
まず、全体像を大まかに把握します。数千の個別のスポット(POI)を取得する代わりに、1 つのクエリを実行して統計サマリーを取得できます。
これには、Places Insights の PLACES_COUNT_PER_H3 関数が最適です。POI の数を六角形グリッド システム(H3)に集約し、特定の条件(営業中の高評価のレストランなど)に基づいて、密度の高いエリアや低いエリアをすばやく特定できます。
クエリの例を次に示します。検索エリアの地域を指定する必要があります。Overture Maps Data の BigQuery 一般公開データセットなどのオープン データセットを使用して、地理的境界データを取得できます。
頻繁に使用されるオープン データセットの境界については、独自のプロジェクトのテーブルにマテリアライズすることをおすすめします。これにより、BigQuery の費用が大幅に削減され、クエリのパフォーマンスが向上します。
-- This query counts all highly-rated, operational restaurants
-- across a large geography, grouping them into H3 cells.
SELECT *
FROM
  `places_insights___gb.PLACES_COUNT_PER_H3`(
    JSON_OBJECT(
      'geography', your_defined_geography,
      'h3_resolution', 8,
      'types', ['restaurant'],
      'business_status', ['OPERATIONAL'],
      'min_rating', 3.5
    )
  );
ブランド ID によるフィルタリングと検証
特定のブランドのカウントとサンプル プレイス ID を検証する場合は、brand_ids フィルタを使用してブランド ID のリストを指定します。
ターゲット ブランドのブランド ID を取得するには、BigQuery で brands テーブルに対してクエリを実行します。
SELECT id, name
FROM `YOUR_PROJECT.places_insights___us.brands`
WHERE LOWER(name) LIKE "%starbucks%";
ターゲット ブランド ID(Starbucks の場合は "1413758728321880760" など)を取得したら、brand_ids フィルタ配列内に渡します。
SELECT *
FROM
  `places_insights___us.PLACES_COUNT_PER_H3`(
    JSON_OBJECT(
      'geography', your_defined_geography,
      'h3_resolution', 8,
      'brand_ids', ["1413758728321880760"]
    )
  );
ステップ 3 のグラウンド トゥルース検証では、場所が一般的なカテゴリに一致することを確認する代わりに、正規表現の一致を使用して、Place Details API から返された表示名と想定されるブランド名をプログラムで比較できます。たとえば、response.display_name.text フィールドを比較できます。
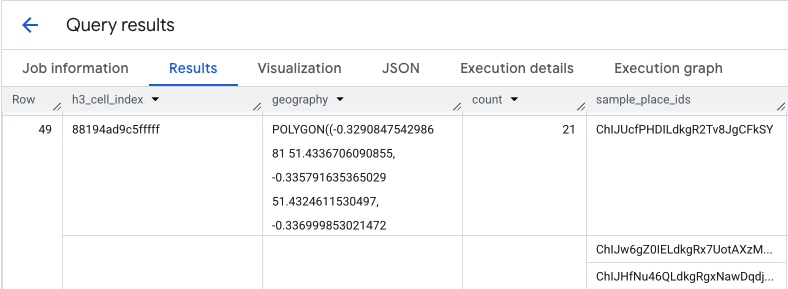
このクエリの出力は、H3 セルと各セル内の場所の数を示すテーブルであり、密度ヒートマップの基礎となります。
ホットスポットを分離してサンプルのプレイス ID を抽出する
PLACES_COUNT_PER_H3 関数の結果は、sample_place_ids の配列も返します。レスポンスの要素ごとに最大 250 個のプレイス ID が返されます。これらの ID は、集計された統計情報から、その統計情報に貢献している個々の場所へのリンクです。
システムは、最初のクエリから最も関連性の高いセルを特定できます。たとえば、カウントが最も多い上位 20 個のセルを選択します。次に、これらのホットスポットから sample_place_ids を 1 つのリストに統合します。このリストは、最も関連性の高いエリアから最も興味深い POI を厳選したサンプルであり、ターゲットを絞った検証に備えることができます。
pandas DataFrame を使用して Python で BigQuery の結果を処理する場合、これらの ID を抽出するロジックは簡単です。
# Assume 'results_df' is a pandas DataFrame from your BigQuery query.

# 1. Identify the 20 busiest H3 cells by sorting and taking the top results.
top_hotspots_df = results_df.sort_values(by='count', ascending=False).head(20)

# 2. Extract and flatten the lists of sample_place_ids from these hotspots.
# The .explode() function creates a new row for each ID in the lists.
all_sample_ids = top_hotspots_df['sample_place_ids'].explode()

# 3. Create a final list of unique Place IDs to verify.
place_ids_to_verify = all_sample_ids.unique().tolist()

print(f"Consolidated {len(place_ids_to_verify)} unique Place IDs for spot-checking.")
他のプログラミング言語を使用する場合も、同様のロジックを適用できます。
Places API を使用してグラウンド トゥルースの詳細を取得する
プレイス ID の統合リストが作成されたら、大規模な分析から特定のデータの取得に移行します。これらの ID を使用して Place Details API にクエリを実行し、各サンプル拠点の詳細情報を取得します。
これは重要な検証ステップです。Places Insights では、あるエリアに何軒のレストランがあるかがわかりますが、Places API では、どのレストランがあるかがわかります。レストランの名前、正確な住所、緯度 / 経度、ユーザーの評価、Google マップ上の場所への直接リンクも提供されます。これにより、サンプルデータが拡充され、抽象的な ID が具体的で検証可能な場所に変換されます。
Place Details API から取得できるデータの完全なリストと、取得に関連する費用については、API ドキュメントをご覧ください。
Python クライアント ライブラリを使用して特定の ID を Places API にリクエストする場合は、次のようになります。詳しくは、Places API(新版)クライアント ライブラリの例をご覧ください。
# A request to fetch details for a single Place ID.
request = {"name": f"places/{place_id}"}

# Define the fields you want returned in the response as a comma-separated string.
fields_to_request = "formattedAddress,location,displayName,googleMapsUri"

# The response contains ground truth data.
response = places_client.get_place(
    request=request,
    metadata=[("x-goog-fieldmask", fields_to_request)]
)
このリクエストのフィールドは、2 つの異なる課金 SKU からデータを取得します。
formattedAddressとlocationは、Place Details Essentials SKU の一部です。displayNameとgoogleMapsUriは、Place Details Pro SKU の一部です。
1 つの Place Details リクエストに複数の SKU のフィールドが含まれている場合、リクエスト全体が最上位の SKU のレートで課金されます。したがって、この特定の呼び出しは Place Details Pro リクエストとして課金されます。
費用を管理するには、常に FieldMask を使用して、アプリケーションに必要なフィールドのみをリクエストします。
検証用の結合された可視化を作成する
最後のステップは、両方のデータセットを 1 つのビューにまとめることです。これにより、初期分析をスポットチェックする、迅速かつ直感的な方法が提供されます。ビジュアリゼーションには次の 2 つのレイヤが必要です。
- ベースレイヤ: 最初の
PLACES_COUNT_PER_H3の結果から生成されたコロプレスまたはヒートマップ。地域全体の場所の密度を示します。 - 最上位レイヤ: 各サンプル POI の個別のマーカーのセット。前のステップで Places API から取得した正確な座標を使用してプロットされます。
この結合ビューを構築するロジックは、次の疑似コードの例で表されています。
# Assume 'h3_density_data' is your aggregated data from Step 1.
# Assume 'detailed_places_data' is your list of place objects from Step 3.

# Create the base choropleth map from the H3 density data.
# The 'count' column determines the color of each hexagon.
combined_map = create_choropleth_map(
    data=h3_density_data,
    color_by_column='count'
)

# Iterate through the detailed place data to add individual markers.
for place in detailed_places_data:
    # Construct the popup information with key details and a link.
    popup_html = f"""
    <b>{place.name}</b><br>
    Address: {place.address}<br>
    <a href="{place.google_maps_uri}" target="_blank">View on Maps</a>
    """

    # Add a marker for the current place to the base map.
    combined_map.add_marker(
        location=[place.latitude, place.longitude],
        popup=popup_html,
        tooltip=place.name
    )

# Display the final map with both layers.
display(combined_map)
高レベルの密度マップに特定のグラウンド トゥルース マーカーを重ねることで、ホットスポットとして特定されたエリアに、分析対象の場所が実際に集中していることをすぐに確認できます。この視覚的な確認により、データドリブンな結論に対する信頼性が大幅に向上します。
まとめ
このアーキテクチャ パターンは、大規模な地理空間分析情報を検証するための堅牢で効率的な方法を提供します。Places Insights を使用して広範でスケーラブルな分析を行い、Place Details API を使用してターゲットを絞ったグラウンド トゥルース検証を行うことで、強力なフィードバック ループを構築できます。これにより、小売店の立地選定や物流計画など、戦略的な意思決定が、統計的に有意なだけでなく、検証可能な正確なデータに基づいて行われるようになります。
次のステップ
- 他の場所カウント関数を試して、さまざまな分析上の質問にどのように回答できるかを確認します。
- Places API のドキュメントを確認して、分析をさらに充実させるためにリクエストできる他のフィールドを見つけてください。
寄稿者
Henrik Valve | DevX エンジニア