
Depois de coletar seus dados, faça uma análise de dados detalhada (EDA, na sigla em inglês) para encontrar e resolver problemas de qualidade de dados. Essa é uma etapa fundamental no processo de Modelagem de Marketing Mix (MMM), porque permite avaliar os dados para confirmar se eles representam com precisão os esforços de marketing, as respostas dos clientes e outras métricas relevantes. Ao corrigir os problemas detectados pelo processo de EDA, é possível melhorar a confiabilidade da saída do modelo.
Processo básico da EDA:
- Faça uma análise para identificar dados ausentes ou incompletos.
- Corrija valores ausentes nos arquivos de entrada.
- Avalie a precisão dos dados.
- Corrija anomalias, outliers ou imprecisões nos dados.
- Verifique a correlação entre as variáveis de KPI, mídia e controle.
Pacote EDA do Meridian
O pacote EDA do Meridian ajuda nesse processo gerando um relatório HTML de análise de dados exploratória (EDA) que pode ser exportado para o Google Drive. Esse relatório fornece visualizações e verificações de dados para ajudar a identificar problemas comuns. Cada verificação ou visualização inclui uma informação que descreve o problema de dados e os itens úteis correspondentes.
As descobertas são categorizadas em um de três níveis de gravidade:
- ERROR: identifica problemas de dados extremamente graves que provavelmente vão impedir a convergência do modelo. Limites padrão estritos são usados para o status
ERROR, garantindo que apenas os erros mais graves, geralmente de entrada de dados, sejam sinalizados. A amostragem a posteriori fica bloqueada até que você resolva esses problemas. - ATTENTION: identifica possíveis problemas importantes nos dados. Embora esses problemas não impeçam a convergência do modelo, eles indicam fortemente áreas que você precisa investigar e corrigir. Como alguns casos de uso ainda podem justificar a execução do modelo, o Meridian permite que a amostragem a posteriori continue. No entanto, aplique seu contexto comercial para determinar se é adequado continuar com os dados atuais.
- INFO: indica que nenhum status
ERRORouATTENTIONfoi acionado ou destaca verificações que não têm limites definidos. Embora seja razoável esperar que um modelo útil se ajuste a essas condições, ainda é recomendável revisar as métricas e visualizações de nívelINFOpara identificar anomalias ou inconsistências nos dados.
A saída HTML da EDA organiza os problemas de dados em cinco categorias:
- Gastos e unidade de mídia: analisa a parcela de gastos no nível do canal e faz uma verificação cruzada dos gastos em relação às unidades de mídia.
- Variáveis explicativas ou de resposta individuais: investiga a variabilidade de variáveis individuais, sinalizando problemas como desvio padrão zero (falta de variação) ou outliers extremos.
- Dimensionamento pela população de variáveis explicativas: avalia a relação entre a população e as variáveis explicativas.
- Relação entre as variáveis: analisa as correlações entre as variáveis, bem como as relações entre as variáveis explicativas e os principais efeitos de tempo ou geográficos.
- Especificações de distribuição a priori: avalia as especificações de distribuição a priori, principalmente a probabilidade a priori de um valor de referência negativo.
Configuração e geração de relatórios
Siga as etapas abaixo para gerar o relatório HTML da EDA ou executar as verificações de dados individuais descritas neste documento.
Primeiro, instancie o modelo
Meridiane o objetoMeridianEDA. Execute o seguinte código de configuração uma vez:from meridian.model import model from meridian.model.eda import meridian_eda mmm = model.Meridian(...) mmm_eda = meridian_eda.MeridianEDA(mmm)Observação: os snippets de código subsequentes nesta página omitem essa configuração e mostram apenas as chamadas de método específicas usando o objeto
mmm_eda.Quando a configuração for concluída, execute o código a seguir para gerar e salvar o relatório HTML completo da EDA:
import IPython

mmm_eda.generate_and_save_report(
    filename=your_filename, filepath=your_filepath
)
IPython.display.HTML(filename=f'{your_filepath}{your_filename}')
Categoria 1: gastos e unidade de mídia
Essa categoria analisa a parcela de gastos no nível do canal e faz uma verificação cruzada dos gastos em relação às unidades de mídia.
Parcela de gastos
Exemplo de resultado:
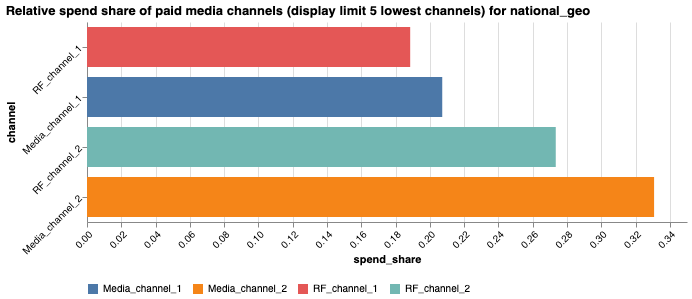
O gráfico de barras no relatório HTML mostra a porcentagem do gasto nacional (agregado em todas as regiões para modelos geográficos) de cada canal de mídia e RF para os 5 canais com menor gasto.
Analise a participação de gastos totais de cada canal. É difícil fazer estimativas quando o canal gasta pouco. Considere combinar esses canais com outros.
Você também pode representar a parcela de gastos para regiões geográficas específicas e para um determinado número de canais com a menor parcela de gastos:
mmm_eda.plot_relative_spend_share_barchart(
    geos=<list_of_geos>, n_channels=<your_integer_choice>
)
Proporção de dados para parâmetros
Depois de analisar o detalhamento da parcela de gastos, avalie a proporção de pontos de dados para parâmetros do modelo. Essa proporção serve como uma diretriz aproximada da quantidade de dados necessária para estimar os parâmetros do modelo de maneira confiável. A maneira mais precisa de avaliar essa proporção é executar o modelo e avaliar a amplitude dos intervalos de confiança.
A proporção é definida como n_data_points / n_parameters, em que:
n_data_points=n_geos*n_timesn_parameters=n_geos- 1 +n_knots+n_controls+n_treatments
Os componentes desse cálculo incluem:
n_geos: o número de regiões geográficas no conjunto de dados. Subtraímos um para a região de base.n_times: o número de períodos.n_knots: o número de nós especificados usando o argumentoknotsemModelSpec.n_controls: o número de variáveis de controle.n_treatments: o número total de variáveis de tratamento, incluindo mídia paga, mídia orgânica, RF paga, ORF e tratamentos não relacionados à mídia.
Esse cálculo exclui parâmetros geográficos separados para n_treatments e n_controls. No modelo hierárquico do Meridian, os efeitos no nível geográfico não são independentes. O compartilhamento de informações entre regiões reduz significativamente a quantidade efetiva de parâmetros. A quantidade no nível nacional serve como uma referência prática, com uma certa tolerância. Para comparação com uma visão estrita que não pressupõe nenhum agrupamento, consulte a seção Quantidade de dados necessários.
Uma proporção muito pequena pode indicar dados insuficientes para a estimativa, o que leva a uma variância alta e estimativas não confiáveis. Se isso acontecer, considere remover ou combinar canais ou reduzir o número de nós usando o argumento knots em ModelSpec. Ao decidir quais canais modificar, use os insights da subseção Parcela de gastos para identificar aqueles com os menores valores.
Para mais informações sobre requisitos de dados e nuances da modelagem hierárquica geográfica, consulte Quantidade de dados necessários.
Gastos, unidade de mídia e custo por unidade de mídia
Para canais de mídia e RF, são realizadas verificações cruzadas no gasto, nas unidades de mídia e no custo por unidade de mídia. As unidades de mídia analisadas aqui são brutas (sem dimensionamento). Para canais de RF, as unidades de mídia são impressões de RF, calculadas como alcance bruto (não dimensionado) multiplicado pela frequência.
Essas verificações cruzadas identificam inconsistências entre os dados de gastos e de unidade de mídia, como nenhum gasto com unidades de mídia positivas ou gasto positivo sem unidades de mídia. Se forem encontradas inconsistências, um status ATTENTION será sinalizado.
Analise a entrada de dados desses canais de mídia paga sinalizados e os gastos deles.
Essa verificação também sinaliza um status ATTENTION se houver outliers no custo por unidade de mídia (calculado como o gasto dividido pelas unidades de mídia). O pacote EDA do Meridian define um outlier usando a regra prática do intervalo interquartil (IQR, na sigla em inglês): valores menores que Q1 - 1,5 * IQR ou maiores que Q3 + 1,5 * IQR. A tabela HTML mostra os valores absolutos do custo por unidade de mídia dos cinco outliers mais extremos, classificados em ordem decrescente. Verifique esses canais para identificar possíveis erros de entrada de dados.
Execute o código a seguir para extrair o custo por unidade de mídia calculado de todos os canais de mídia e RF em cada período (e para cada região nos modelos geográficos):
# For geo models
[geo_cpm] = mmm_eda.geo_cost_per_media_unit_check_outcome.get_geo_artifacts()
geo_cpm.cost_per_media_unit_da

# For national models
[national_cpm] = (
    mmm_eda.national_cost_per_media_unit_check_outcome
    .get_national_artifacts()
)
national_cpm.cost_per_media_unit_da
O relatório HTML também inclui dois gráficos de série temporal para canais sinalizados com um status ATTENTION (por inconsistências ou outliers). O primeiro gráfico sobrepõe as séries temporais de gastos e de unidades de mídia no nível do canal. O segundo gráfico mostra a série temporal no nível do canal do custo por unidade de mídia. Cada gráfico de série temporal é para um canal.
Esses gráficos de série temporal em HTML são baseados em quantidades nacionais. Para conjuntos de dados geográficos, o custo e as unidades de mídia de cada canal são agregados ao nível nacional antes de calcular a proporção de custo por unidade de mídia. Se nenhum status de ATTENTION for sinalizado, esses gráficos não vão aparecer no relatório HTML da EDA.
Exemplo de resultado:

É possível representar a série temporal de gastos, unidades de mídia e custo por unidade de mídia para canais e regiões geográficas específicos e se concentrar em um subconjunto dos dados:
mmm_eda.plot_cost_per_media_unit_time_series(
    geos=<list_of_geos>, channels=<list_of_channels>
)
Observação: se os dados de gastos do usuário não tiverem dimensões de tempo ou geográficas, eles serão alocados automaticamente nessas dimensões de acordo com as unidades de mídia. Isso resulta em um custo constante por unidade de mídia, e não haveria inconsistências entre os gastos e as unidades de mídia. Como consequência, essas verificações de dados específicas sempre serão aprovadas.
Categoria 2: variáveis explicativas ou de resposta individuais
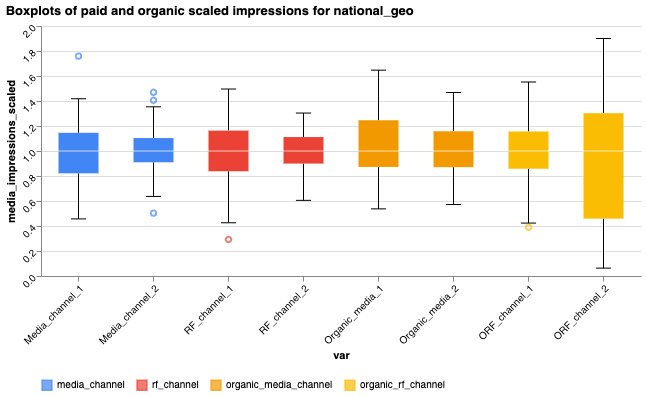
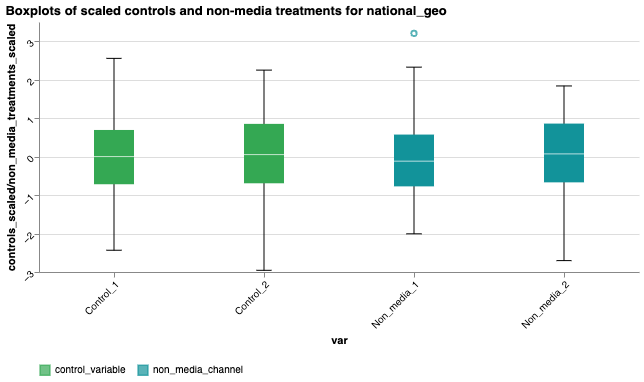
Ilustramos a variação de cada variável com gráficos de caixa.
Os gráficos agrupam as variáveis da seguinte maneira:
- Impressões pagas e orgânicas ajustadas: mostradas juntas em um gráfico, já que passam pelas mesmas transformações detalhadas na documentação de dados de entrada. Isso inclui impressões de RF dimensionadas para canais de RF e ORF, em que as impressões de RF dimensionadas são calculadas como o alcance dimensionado multiplicado pela frequência.
- Controles e tratamentos dimensionados não relacionados à mídia: mostrados juntos em um gráfico diferente, já que essas variáveis são transformadas de maneira semelhante.
- KPI dimensionado: mostrado em um gráfico de caixa próprio.
Para conjuntos de dados geográficos, o pacote EDA do Meridian primeiro agrega as variáveis brutas (não dimensionadas) ao nível nacional, depois transforma as variáveis de acordo com a documentação de dados de entrada e, por fim, cria os gráficos de caixa.
Analise a variabilidade das variáveis explicativas e de resposta mostradas nos gráficos de caixa. Variáveis explicativas com variabilidade muito baixa são difíceis de estimar e podem prejudicar a convergência do modelo. Considere mesclar ou substituir essas variáveis, descartar as que são muito pequenas ou usar uma distribuição a priori personalizada se tiver informações relevantes. Se houver outliers, verifique a entrada de dados para garantir que eles são verdadeiros e não errôneos.
Exemplo de resultado:

É possível criar gráficos de caixa para regiões geográficas específicas:
# For paid and organic scaled impressions
mmm_eda.plot_treatments_without_non_media_boxplot(geos=<list_of_geos>)

# For controls and non-media treatments
mmm_eda.plot_controls_and_non_media_boxplot(geos=<list_of_geos>)

# For KPI
mmm_eda.plot_kpi_boxplot(geos=<list_of_geos>)
Falta crítica de variação
O desvio padrão do KPI transformado é calculado em todas as regiões e períodos para um modelo geográfico ou em todos os períodos para um modelo nacional. Um ERROR é acionado quando o KPI transformado é quase totalmente constante, indicado por um desvio padrão menor que 1 e -4. Isso significa que não há indicador na variável de resposta. Verifique se há erros de entrada de dados ou reconsidere a viabilidade da modelagem estatística com esse conjunto de dados.
Para as variáveis explicativas, o Meridian primeiro calcula o desvio padrão de controles e variáveis de tratamento dimensionados (incluindo o alcance dimensionado para canais de RF e ORF) ao longo da dimensão de tempo e da dimensão geográfica (se aplicável) separadamente.
- Variação geográfica: o desvio padrão das variáveis dimensionadas ao longo da dimensão geográfica é avaliado apenas para conjuntos de dados geográficos, porque um modelo nacional tem apenas uma região. Um status
ERRORocorre quando você defineknots = n_timese uma variável não muda entre as regiões (por exemplo, uma variável nacional em um conjunto de dados no nível geográfico). Quandoknots = n_times, cada período tem o próprio parâmetro de nó. Como uma variável nacional muda apenas com o tempo, não por região, ela é perfeitamente colinear com o tempo e redundante em um modelo de nó completo. Para resolver essa redundância, você pode: (1) manter a variável nacional e definirknots < n_timesou (2) descartar as variáveis que não mudam entre as regiões. A escolha depende das suas metas de interpretação específicas. - Variação ao longo do tempo: para um modelo geográfico, um status
ERRORocorre quando uma variável não muda com o tempo, já que se torna perfeitamente colinear com o efeito principal geográfico $\tau_g$. Como essa variável redundante leva a uma convergência ruim do modelo, é recomendável descartar qualquer variável que não mude com o tempo. Para um modelo nacional, uma variável que não muda com o tempo atua como um termo constante que não fornece indicadores e prejudica a convergência do modelo. Um statusERRORvai ocorrer, e você deve remover essa variável constante do modelo.
Outliers e possível esparsidade de dados
O pacote EDA do Meridian também verifica outliers em cada tratamento, variável de controle e KPI dimensionados. Essa verificação ocorre no nível geográfico para conjuntos de dados geográficos usando a regra prática padrão de intervalo interquartil.
Se houver outliers, essa verificação vai sinalizar um status ATTENTION e mostrar os cinco outliers mais extremos (com base no valor absoluto) no relatório HTML da EDA.
Verifique a entrada de dados para garantir que esses valores sejam verdadeiros e não errôneos.
Independente da sinalização dos outliers, essa verificação também avalia a possível esparsidade de dados calculando o desvio padrão de cada variável com e sem esses outliers. Se o desvio padrão cair para zero depois da remoção dos outliers, ou seja, se a variável mostrar variação por causa dos outliers, essa verificação vai sinalizar um status ATTENTION adicional.
- Quando as variáveis de tratamento ou controle mostram um desvio padrão zero após a remoção de outliers, há um indício de esparsidade de dados. Embora isso possa ser intencional (por exemplo, esparsidade de dados devido a períodos de "retirada de anúncios"), pode afetar a convergência e a identificabilidade do modelo. Se não for intencional, agregue essas variáveis para melhorar a estabilidade do modelo.
- Quando o KPI tem um desvio padrão de zero em determinadas regiões geográficas após a remoção de outliers, há um sinal fraco ou inexistente na variável de resposta para esses locais. Revise os dados de entrada ou considere agrupar essas regiões.
É possível extrair os desvios padrão de cada variável (calculados para regiões específicas em modelos geográficos) e mapeá-los em um dicionário para facilitar o acesso usando o seguinte código:
# For geo models
geo_std = mmm_eda.geo_stdev_check_outcome.analysis_artifacts
geo_std_dict = {a.variable: a.std_ds for a in geo_std}

# For national models
national_std = mmm_eda.national_stdev_check_outcome.analysis_artifacts
national_std_dict = {a.variable: a.std_ds for a in national_std}
Categoria 3: dimensionamento pela população de variáveis explicativas
Essa categoria se aplica apenas a conjuntos de dados geográficos. Para conjuntos de dados nacionais, a única região (nacional) é tratada como tendo uma população nominal de 1,0, e os valores de população não afetam o modelo porque o dimensionamento interno (dimensionamento ou padronização da mediana) do Meridian cancela o efeito da população nacional.
Correlação entre população e variáveis brutas de mídia paga ou orgânica
Essa verificação avalia a correlação de Spearman entre a população geográfica e as variáveis de mídia paga ou orgânica brutas. Essas variáveis incluem unidades de mídia, alcance (para canais de RF), unidades de mídia orgânica e alcance orgânico brutos (para canais de ORF). Avaliamos a correlação de Spearman para analisar a relação loglinear entre a população e essas variáveis.
Valores positivos de correlação de Spearman são esperados para essas variáveis. Se você observar uma correlação baixa ou negativa, verifique a entrada de dados. O pacote EDA do Meridian rotula essas verificações apenas como INFO, sem acionar os status ERROR ou ATTENTION, mas é altamente recomendável revisar os valores.
Exemplo de resultado:

É possível extrair os valores de correlação de cada uma dessas variáveis usando o seguinte código:
[pop_corr_raw] = (
    mmm_eda.eda_engine.check_population_corr_raw_media()
    .get_overall_artifacts()
)
pop_corr_raw.correlation_ds
Correlação entre população e tratamentos e controles dimensionados
Os tratamentos e controles dimensionados aqui se referem às quantidades transformadas de acordo com a documentação de dados de entrada. Os controles e tratamentos não relacionados à mídia também dependem dos argumentos non_media_population_scaling_id e control_population_scaling_id em ModelSpec, respectivamente. Analise a correlação de Spearman entre a população e as unidades de tratamento ou variáveis de controle dimensionadas.
- Controles e canais não relacionados a mídia: por padrão, o Meridian não dimensiona essas variáveis pela população. Uma alta correlação indica que você provavelmente deve aplicar o dimensionamento da população usando os argumentos
control_population_scaling_idounon_media_population_scaling_idemModelSpec. Para mais informações, consulte Variáveis de controle de dimensionamento pela população. - Canais de mídia paga e orgânica: por padrão, o Meridian dimensiona automaticamente esses canais pela população. Uma alta correlação aqui sugere que a variável já pode ter sido ajustada pela população antes de ser transmitida ao Meridian. Verifique o pipeline de entrada de dados.
Assim como a verificação anterior, esta é sinalizada apenas como INFO, mas você precisa revisar os valores.
Exemplo de resultado:

É possível recuperar os valores de correlação usando o seguinte código:
[pop_corr_scaled] = (
    mmm_eda.eda_engine.check_population_corr_scaled_treatment_control()
    .get_overall_artifacts()
)
pop_corr_scaled.correlation_ds
Categoria 4: relação entre as variáveis
Essa categoria analisa as correlações entre variáveis, bem como as relações entre variáveis explicativas e efeitos principais de tempo ou geográficos.
Mapa de calor de correlação
Uma alta correlação entre variáveis pode causar problemas de convergência e identificabilidade do modelo. Nesse caso, combine as variáveis afetadas.
Exemplo de resultado:
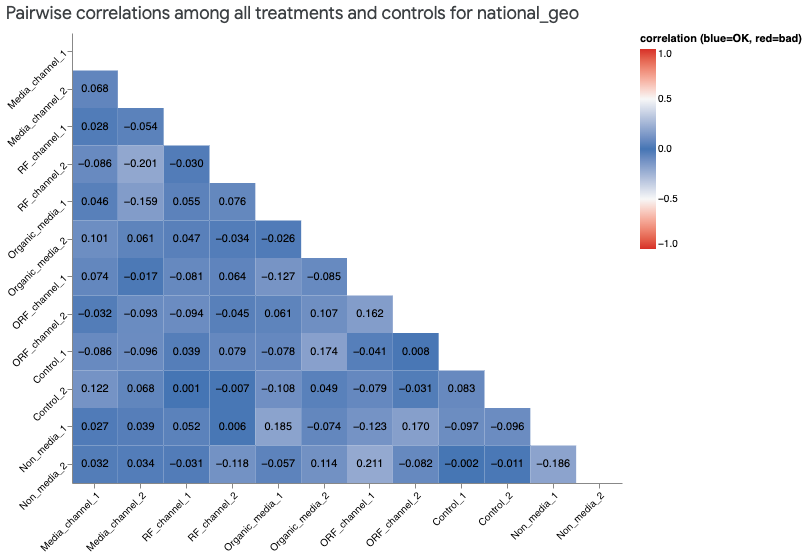
O mapa de calor ilustra a correlação de Pearson entre tratamentos e variáveis de controle dimensionados. Os tratamentos dimensionados incluem impressões de RF dimensionadas para canais de RF e ORF. Aqui, os tratamentos e controles dimensionados se referem às quantidades transformadas de acordo com a documentação de dados de entrada. O mapa de calor HTML mostra correlações com base em variáveis dimensionadas nacionais. Para conjuntos de dados geográficos, as variáveis brutas (não dimensionadas) são agregadas nacionalmente, transformadas e, em seguida, a correlação entre pares é calculada.
Use o código a seguir para criar o mapa de calor de correlação de qualquer região específica:
mmm_eda.plot_pairwise_correlation(geos=<list_of_geos>)
Multicolinearidade usando a verificação do fator de inflação de variância (VIF)
Para avaliar melhor a multicolinearidade, o fator de inflação de variância (VIF, na sigla em inglês) é calculado para todas as unidades de tratamento e variáveis de controle dimensionadas. O VIF estima o quanto a variância de uma variável de tratamento ou controle é aumentada devido à colinearidade com outros tratamentos ou controles. Um VIF de 1 indica que não há colinearidade, enquanto valores mais altos indicam multicolinearidade crescente. A correlação perfeita de pares é uma causa comum de multicolinearidade. A alta multicolinearidade aumenta os intervalos de confiança dos coeficientes, tornando a inferência a posteriori menos confiável.
Dependendo do tipo de modelo, a verificação do VIF avalia os dados e aciona os seguintes status:
Status do modelo geográfico
ERROR: para modelos geográficos, o VIF é calculado em todas as regiões e períodos. Especificamente, os valores de cada variável em todas as regiões geográficas e períodos são transformados em uma única matriz, e o VIF é calculado para cada uma dessas matrizes achatadas. Um statusERRORserá acionado se qualquer variável puder ser expressa quase perfeitamente como uma combinação linear de outras, demonstrado por um VIF que excede o limite geral padrão de 1.000. Para resolver isso, descarte as variáveis que são combinações lineares de outras ou considere combiná-las.É possível recuperar os VIFs gerais do modelo geográfico (calculados em todas as regiões e períodos) usando o seguinte código:
[overall_vif] = mmm_eda.eda_engine.check_geo_vif().get_overall_artifacts()
overall_vif.vif_da
Status do modelo nacional
ERROR: para modelos nacionais, o VIF é calculado em todos os períodos, já que há apenas uma região. Um statusERRORserá acionado se o VIF de uma variável exceder o limite nacional padrão de 1.000. Para resolver isso, descarte as variáveis que são combinações lineares de outras ou considere combiná-las.É possível recuperar os VIFs calculados para o modelo nacional usando o seguinte código:
[national_vif] = mmm_eda.eda_engine.check_national_vif().get_national_artifacts()
national_vif.vif_da
Status do modelo geográfico
ATTENTION: para modelos geográficos, o VIF também é calculado em todos os períodos para cada região específica. Um statusATTENTIONserá gerado se as variáveis excederem o limite geográfico padrão de 1.000 em regiões individuais. Para resolver isso, verifique os dados ou combine essas variáveis, principalmente se elas mostrarem um VIF alto em várias regiões geográficas.É possível recuperar os VIFs do modelo geográfico para regiões individuais usando o seguinte código:
[geo_vif] = mmm_eda.eda_engine.check_geo_vif().get_geo_artifacts()
geo_vif.vif_da
É possível ajustar esses limites extremos, se necessário. Para mais detalhes sobre como definir esses limites, consulte Limite de VIF personalizado.
Quando um desses status ERROR ou ATTENTION é acionado, a guia do relatório HTML tabula as cinco principais variáveis com o maior VIF e lista as outras variáveis com que elas têm alta correlação.
Colinearidade com o efeito principal geográfico $\tau_g$
Essa verificação faz uma regressão de cada variável em relação à região geográfica como uma variável categórica. Nesse caso, um R ao quadrado alto indica baixa variação temporal de uma variável. Isso pode levar a um modelo fracamente identificável e não convergente devido aos principais efeitos geográficos.
Considere descartar a variável com R ao quadrado muito alto. O relatório HTML tabula as cinco principais variáveis com os maiores valores de R ao quadrado.
Essa verificação é de nível INFO sem limites para sinalizar ERROR ou ATTENTION, mas recomendamos que você analise a tabela.
Colinearidade com o efeito principal de tempo $\mu_t$
Essa verificação faz uma regressão de cada variável em relação ao tempo como uma variável categórica. Um R ao quadrado alto indica baixa variação geográfica de uma variável. Isso pode levar a um modelo fracamente identificável e não convergente, caso um grande número de nós seja usado.
Considere descartar a variável com R ao quadrado muito alto ou reduzir o argumento knots em ModelSpec. O relatório HTML tabula as cinco principais variáveis com os maiores valores de R ao quadrado. Essa verificação está no nível INFO (sem limites para sinalizar ERROR ou ATTENTION), mas recomendamos que você analise a tabela.
É possível extrair os valores de R ao quadrado calculados para todas as variáveis (em relação a região geográfica e tempo) usando o seguinte código:
[mmm_geo_time_collinearity] = (
    mmm_eda.eda_engine.check_variable_geo_time_collinearity()
    .get_overall_artifacts()
)
mmm_geo_time_collinearity.rsquared_ds
Categoria 5: especificações de distribuições a priori
Essa categoria avalia especificações de distribuição a priori, principalmente a probabilidade a priori de um valor de referência negativo. Um valor de referência negativo é equivalente aos efeitos do tratamento receberem muito crédito. Analise a probabilidade a priori de um valor de referência negativo junto com o gráfico de barras da média a priori de contribuição no nível do canal. Se a probabilidade a priori de referência negativa for alta, considere distribuições a priori de tratamento personalizadas. Especificamente, um tipo de distribuição a priori personalizada contribution pode ser adequado.
Exemplo de resultado:

O gráfico mostra apenas os 15 principais canais. Você pode extrair a probabilidade a priori de uma variável de valor de referência negativo e a média a priori de contribuição no nível do canal usando o seguinte código:
[prior_check] = mmm_eda.eda_engine.check_prior_probability().get_overall_artifacts()

# This returns the prior probability of negative baseline
prior_check.prior_negative_baseline_prob

# This returns the channel-level prior mean of contribution
prior_check.mean_prior_contribution_da
Outras verificações, visualizações e personalizações
Além do relatório HTML, você pode analisar outros diagnósticos de dados e configurações personalizadas para adaptar o processo de EDA.
Série temporal de KPIs com nós
É possível visualizar a série temporal de KPI nacional sobreposta aos nós especificados em ModelSpec:
mmm_eda.plot_national_kpi_with_knots_time_series()
Exemplo de resultado:

Os nós mostrados dependem da configuração do argumento knots em ModelSpec:
- Configuração padrão: o Meridian usa nós completos para conjuntos de dados geográficos, enquanto um único nó é o padrão para modelos nacionais (o gráfico será omitido se houver apenas um nó).
- Algoritmo AKS: se
enable_aks = True, essa função vai gerar um gráfico com os nós selecionados pelo método Seleção automática de nós (AKS, na sigla em inglês). - Especificação manual: mostra os locais de nós definidos manualmente.
Esse gráfico de série temporal de KPI com nós é uma visualização útil para ajudar a avaliar o posicionamento dos nós e determinar se é necessário adicionar ou remover manualmente algum deles. Para mais orientações, consulte Definir nós.
Verificação de correlação aos pares
O pacote EDA do Meridian calcula a correlação de Pearson entre todas as unidades de tratamento e variáveis de controle dimensionadas.
Status do modelo geográfico
ERROR: para modelos geográficos, a correlação aos pares é calculada primeiro em todas as regiões e períodos. Especificamente, os valores de cada variável em todas as regiões e períodos são transformados em uma única matriz, e a correlação aos pares é calculada entre essas matrizes achatadas. Um statusERRORserá acionado se um par de variáveis tiver uma correlação quase perfeita em todas as regiões e períodos (o valor absoluto da correlação entre pares excede o limite padrão de 0,999). Para resolver isso, remova uma das variáveis redundantes dos dados de entrada.É possível recuperar a correlação geral aos pares do modelo geográfico (calculada em todas as regiões e períodos) usando o seguinte código:
[overall_corr] = mmm_eda.eda_engine.check_geo_pairwise_corr().get_overall_artifacts()
overall_corr.corr_matrix
Status do modelo nacional
ERROR: para modelos nacionais, a correlação aos pares é calculada em todos os períodos, já que há apenas uma região geográfica. Um statusERRORserá acionado se o valor absoluto da correlação entre um par de variáveis exceder o limite padrão de 0,999. Para resolver isso, remova uma das variáveis redundantes dos dados de entrada.Você pode recuperar a correlação aos pares calculada para o modelo nacional usando o seguinte código:
[national_corr] = mmm_eda.eda_engine.check_national_pairwise_corr().get_national_artifacts()
national_corr.corr_matrix
Status do modelo geográfico
ATTENTION: para modelos geográficos, a correlação aos pares também é calculada em todos os períodos para cada região específica. Um statusATTENTIONserá gerado se um par de variáveis apresentar correlação quase perfeita em regiões geográficas individuais, excedendo o limite padrão de 0,999. Para resolver isso, verifique os dados ou combine essas variáveis se elas também mostrarem alta correlação aos pares em várias regiões geográficas.É possível recuperar as correlações do modelo geográfico para regiões individuais usando o seguinte código:
[geo_corr] = mmm_eda.eda_engine.check_geo_pairwise_corr().get_geo_artifacts()
geo_corr.corr_matrix
É possível ajustar esses limites extremos, se necessário. Para mais detalhes sobre como definir esses limites, consulte Limite de correlação aos pares personalizada.
Personalizações configuráveis pelo usuário
O pacote de EDA do Meridian oferece várias opções de configuração para adaptar o processo de EDA ao seu conjunto de dados e necessidades de modelagem específicos.
Método de agregação personalizada de região para nível nacional
Para realizar a EDA nacional em um conjunto de dados geográficos, o pacote de EDA do Meridian agrega internamente os dados geográficos brutos (sem dimensionamento) ao nível nacional antes de aplicar transformações. Isso garante a equivalência ao caso em que os usuários precisam primeiro agregar manualmente o próprio conjunto de dados geográficos ao nível nacional e, em seguida, transmitir esses dados nacionais ao Meridian e aplicar a EDA.
Por padrão, todas as unidades de mídia, unidades de mídia orgânica, alcance e KPI brutos são somados em todas as regiões geográficas. Para agregar a frequência, o pacote EDA do Meridian calcula as impressões brutas de RF (alcance multiplicado pela frequência) de cada região geográfica, soma as impressões de RF e o alcance em todas as regiões e divide o total de impressões de RF nacionais pelo alcance nacional total. Cálculos semelhantes se aplicam ao agregar a frequência orgânica.
Embora a agregação de soma padrão seja adequada para a maioria das variáveis, é possível definir um método de agregação personalizado para variáveis de controle ou tratamentos específicos não relacionados à mídia. Isso é especialmente útil para variáveis binárias ou que representam taxas ou porcentagens.
Por exemplo, se você quiser calcular a média de uma variável de controle chamada rating em todas as regiões geográficas:
from meridian.model import model
from meridian.model.eda import eda_spec
import numpy as np

mmm_agg_config = eda_spec.AggregationConfig(
    control_variables={'rating': np.mean}
)
mmm_eda_spec = eda_spec.EDASpec(aggregation_config=mmm_agg_config)
mmm = model.Meridian(..., eda_spec=mmm_eda_spec)
Limite de VIF personalizado
O pacote EDA do Meridian aciona um status ERROR ou ATTENTION para problemas de dados extremos, como multicolinearidade quase perfeita. Para evitar instabilidade numérica e manter a flexibilidade, o pacote usa um limite padrão de VIF extremo de 1.000 em vez de infinito. Você pode calibrar esses limites com base no contexto e critérios da sua empresa:
geo_threshold: para conjuntos de dados geográficos. Se o VIF de uma variável em uma região geográfica específica exceder esse valor, um statusATTENTIONserá acionado. A amostragem a posteriori ainda poderá ser feita.overall_threshold: para conjuntos de dados geográficos. Se o VIF de uma variável (calculado em todas as regiões geográficas e períodos) exceder esse valor, um statusERRORserá acionado. A amostragem a posteriori será bloqueada.national_threshold: para conjuntos de dados nacionais. Se o VIF de uma variável exceder esse valor, um statusERRORserá acionado. A amostragem a posteriori será bloqueada.
Por exemplo, para reduzir o overall_threshold de multicolinearidade de 1.000 para 50:
from meridian.model import model
from meridian.model.eda import eda_spec

mmm_custom_vif = eda_spec.VIFSpec(overall_threshold=50)
mmm_eda_spec = eda_spec.EDASpec(vif_spec=mmm_custom_vif)
mmm = model.Meridian(..., eda_spec=mmm_eda_spec)
Limite personalizado de correlação aos pares
Um status ERROR ou ATTENTION também é acionado para correlação extrema aos pares. O limite padrão de correlação extrema é definido como 0,999. Você pode calibrar esses limites com base no seu conjunto de dados e critérios específicos:
geo_threshold: para conjuntos de dados geográficos. Se o valor absoluto da correlação entre duas variáveis em uma região geográfica específica exceder esse valor, um statusATTENTIONserá acionado. A amostragem a posteriori ainda poderá ser feita.overall_threshold: para conjuntos de dados geográficos. Se o valor absoluto da correlação (calculada em todas as regiões geográficas e períodos) exceder esse valor, um statusERRORserá acionado. A amostragem a posteriori será bloqueada.national_threshold: para conjuntos de dados nacionais. Se o valor absoluto da correlação exceder esse valor, um status deERRORserá acionado. A amostragem a posteriori será bloqueada.
Por exemplo, para reduzir o overall_threshold de uma correlação aos pares de um modelo geográfico de 0,999 para 0,95:
from meridian.model import model
from meridian.model.eda import eda_spec

mmm_custom_corr = eda_spec.PairwiseCorrSpec(overall_threshold=0.95)
mmm_eda_spec = eda_spec.EDASpec(pairwise_corr_spec=mmm_custom_corr)
mmm = model.Meridian(..., eda_spec=mmm_eda_spec)
Outras personalizações
O pacote de EDA do Meridian aceita outros limites personalizáveis no EDASpec.
Esses padrões servem como restrições internas para o que o pacote considera
variáveis constantes. É raro precisar ajustar esses padrões, mas eles estão disponíveis
para casos extremos específicos que você tenha.
Personalizar o
KpiInvariabilitySpec: conforme descrito em Falta crítica de variação, o pacote de EDA do Meridian aciona umERRORe bloqueia a amostragem posterior quando o KPI transformado tem um desvio padrão geral menor que o limite padrão de 1e-4. Use oKpiInvariabilitySpecpara ajustar ostd_thresholdque determina quando um KPI de baixa variabilidade aciona esseERROR.Por exemplo, para reduzir esse
std_thresholdnoKpiInvariabilitySpecpara 1e-5:from meridian.model import model from meridian.model.eda import eda_spec custom_kpi_spec = eda_spec.KpiInvariabilitySpec(std_threshold=1e-5) mmm_eda_spec = eda_spec.EDASpec(kpi_invariability_spec=custom_kpi_spec) mmm = model.Meridian(..., eda_spec=mmm_eda_spec)Personalizar o
StandardDeviationSpec: conforme detalhado em Outliers e possível esparsidade de dados, variáveis com um desvio padrão extremamente baixo (calculado após a remoção de outliers) indicam possível esparsidade de dados ou falta de sinal. Use oStandardDeviationSpecpara ajustar os limites que determinam quando essas variáveis de baixa variabilidade acionam um alertaATTENTION.Por exemplo, para reduzir o limite de desvio padrão para 1e-5 em um modelo geográfico, ajuste o
geo_std_threshold:from meridian.model import model from meridian.model.eda import eda_spec custom_std_spec = eda_spec.StandardDeviationSpec(geo_std_threshold=1e-5) mmm_eda_spec = eda_spec.EDASpec(std_spec=custom_std_spec) mmm = model.Meridian(..., eda_spec=mmm_eda_spec)Para um modelo nacional, ajuste o
national_std_threshold.Filtrar variáveis constantes dos cálculos de VIF: variáveis quase constantes podem causar erros computacionais durante os cálculos do fator de inflação de variância (VIF, na sigla em inglês). Por padrão, qualquer variável com um desvio padrão menor que 1e-4 é excluída dos cálculos de VIF. É possível ajustar esse limite usando o parâmetro
std_thresholdnoVIFSpec. Por exemplo, para aumentar esse limite para 1e-3:from meridian.model import model from meridian.model.eda import eda_spec custom_vif_std = eda_spec.VIFSpec(std_threshold=1e-3) mmm_eda_spec = eda_spec.EDASpec(vif_spec=custom_vif_std) mmm = model.Meridian(..., eda_spec=mmm_eda_spec)