
收集数据后,请执行探索性数据分析 (EDA),以查找并解决任何数据质量问题。这是营销组合建模分析 (MMM) 流程中的一个关键步骤,因为它让您可以评估数据,确认数据能否准确反映营销活动、客户响应和其他相关指标。通过修正 EDA 流程中发现的问题,您可以提高模型输出的可靠性。
执行 EDA 的基本流程如下:
- 运行数据审核,以确定是否存在任何数据缺失或不完整的情况。
- 修复原始输入文件中的缺失值。
- 评估数据的准确性。
- 修正数据中的任何异常值、离群点或不准确之处。
- 检查 KPI、媒体和控制变量之间的相关性。
Meridian 的 EDA 软件包
Meridian 的 EDA 软件包可生成探索性数据分析 (EDA) HTML 报告,供您导出到 Google 云端硬盘,这有助于您完成上述流程。此 HTML 报告提供可视化图表和数据检查,可帮助您识别常见的潜在数据问题。每项检查或可视化图表都包含一段陈述,用于说明数据问题并提供相应的可执行操作建议。
发现结果会被归类为以下三个严重程度级别之一:
- ERROR:用于识别极其严重的数据问题,这些问题极有可能会导致模型无法收敛。针对
ERROR状态,系统采用了严格的默认阈值,以确保仅标记出最极端的错误(通常是数据输入错误)。在您解决这些问题之前,后验抽样将被禁止。 - ATTENTION:用于识别潜在的重大数据问题。虽然这些问题未必会直接阻碍模型收敛,但它们强烈预示着某些方面需要您调查并且可能需要修正。由于某些使用场景可能仍需要运行模型,因此 Meridian 允许继续进行后验抽样。不过,您应根据自己的业务背景来确定是否适合继续使用当前数据。
- INFO:表示未触发任何
ERROR或ATTENTION状态,或者用于突出显示未定义阈值的检查。虽然在这些条件下,您有理由预期能够拟合出有用的模型,但仍建议您查看INFO级指标和可视化图表,这有助于识别任何潜在的数据异常或不一致之处。
EDA HTML 输出将数据问题分为五类:
- 支出和媒体单位:分析渠道级支出份额,并根据媒体单位数交叉检查支出。
- 单个解释性变量或响应变量:调查单个变量的可变性,标记标准差为零(缺乏变异性)或存在极端离群值等问题。
- 按人口比例缩放解释性变量:评估人口与解释性变量之间的关系。
- 变量之间的关系:探索变量之间的相关性,以及解释性变量与时间和地理位置主效应之间的关系。
- 先验设定:评估先验设定,特别是负基准的先验概率。
设置和报告生成
按照以下步骤操作,可生成 EDA HTML 报告或运行本文档中描述的各项数据检查。
首先,实例化
Meridian模型和MeridianEDA对象。运行一次以下设置代码:from meridian.model import model from meridian.model.eda import meridian_eda mmm = model.Meridian(...) mmm_eda = meridian_eda.MeridianEDA(mmm)注意:此页面上的后续代码段省略了此设置,仅显示使用
mmm_eda对象进行的特定方法调用。设置完成后,运行以下代码以生成并保存完整的 EDA HTML 报告:
import IPython

mmm_eda.generate_and_save_report(
    filename=your_filename, filepath=your_filepath
)
IPython.display.HTML(filename=f'{your_filepath}{your_filename}')
类别 1:支出和媒体单位
此类别分析渠道级支出份额,并根据媒体单位数交叉检查支出。
支出份额
输出示例:
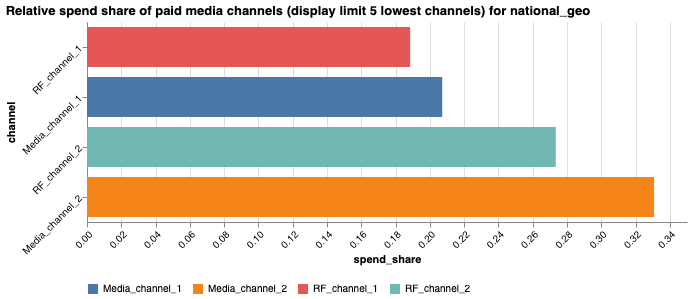
HTML 报告中的条形图显示了在支出最低的 5 个渠道中,每个媒体渠道和 RF 渠道的国家级支出百分比(对于地理位置级模型,该数值是在地理位置间汇总得到的)。
您可以查看每个渠道在总支出中所占的份额。支出份额非常小的渠道可能难以准确估计,建议将这类渠道与其他渠道合并。
您还可以针对特定地理位置以及支出份额最低的一定数量的渠道,绘制支出份额图表:
mmm_eda.plot_relative_spend_share_barchart(
    geos=<list_of_geos>, n_channels=<your_integer_choice>
)
数据与形参的比率
在查看支出份额细分数据后,请评估数据点与模型形参的比率。此比率可作为一项粗略参考,帮助您判断需要多少数据量才能可靠地估算出模型参数。评估此比率最准确的方法是运行模型并衡量可信区间的宽度。
该比率的定义为:n_data_points / n_parameters,其中:
n_data_points=n_geos*n_timesn_parameters=n_geos- 1 +n_knots+n_controls+n_treatments
上述计算公式包含以下各项:
n_geos:数据集内的地理位置数量。需减去 1 个基准地理位置。n_times:时间段的数量。n_knots:在ModelSpec中使用knots实参指定的结数量。n_controls:控制变量的数量。n_treatments:处理变量的总数,包括付费媒体、自然媒体、付费 RF、ORF 和非媒体处理变量。
该计算公式未包含 n_treatments 和 n_controls 的单独地理位置级形参。在 Meridian 的层次化模型中,地理位置级效应并非孤立存在;地理位置之间的信息共享可以显著减少有效形参数量。因此,采用国家级计数作为宽松基准是实际应用时一种行之有效的做法。如需与假设不进行汇总的严格视角进行比较,请参阅所需数据量部分。
如果该比率非常小,则可能表示数据不足,无法进行估计,这会导致方差较高,估计值不可靠。如果出现这种情况,请考虑舍弃或合并渠道,或者在 ModelSpec 中使用 knots 实参来减少结数量。在决定要修改哪些渠道时,请根据支出份额小节中的数据分析,找出支出最少的渠道。
如需详细了解数据要求和地理位置层次化建模的细微差别,请参阅所需的数据量。
支出、媒体单位数和每媒体单位费用
对于媒体渠道和 RF 渠道,系统会对支出、媒体单位数和每媒体单位费用进行交叉检查。此处分析的媒体单位数是原始(未按比例缩放)媒体单位数。对于 RF 渠道,媒体单位数是指 RF 展示次数,计算方法为:原始(未按比例缩放)覆盖人数乘以展示频次。
这些交叉检查可发现支出与媒体单位数据之间的不一致,例如支出为零但媒体单位数为正数,或者支出为正数但媒体单位数为零。如果发现不一致的情况,系统会标记 ATTENTION 状态。请检查这些被标记的付费媒体渠道及其支出的数据输入。
如果每媒体单位费用(计算方式为:支出除以媒体单位数)存在离群值,这项检查也会标记 ATTENTION 状态。Meridian 的 EDA 软件包使用四分位距 (IQR) 经验法则来定义离群值:小于 Q1 - 1.5 * IQR 或大于 Q3 + 1.5 * IQR 的值。HTML 表格会列出前五个最极端离群值的每媒体单位费用的绝对值,并按降序排列。请检查这些渠道,看看是否存在潜在的数据输入错误。
您可以运行以下代码,检索计算出的所有媒体渠道和 RF 渠道在每个时间段(以及地理位置模型中每个地理位置)的每媒体单位费用:
# For geo models
[geo_cpm] = mmm_eda.geo_cost_per_media_unit_check_outcome.get_geo_artifacts()
geo_cpm.cost_per_media_unit_da

# For national models
[national_cpm] = (
    mmm_eda.national_cost_per_media_unit_check_outcome
    .get_national_artifacts()
)
national_cpm.cost_per_media_unit_da
HTML 报告还包含两个时序图,针对被标记为 ATTENTION 状态(存在不一致或离群值)的渠道。第一个图将渠道级支出时间序列与媒体单位时间序列叠加显示。第二个图显示了每媒体单位费用的渠道级时间序列。每个时序图对应一个渠道。
这些 HTML 时序图是根据国家级数据绘制的。对于地理位置级数据集,每个渠道的费用和媒体单位数会汇总到国家级,然后再计算每媒体单位费用比率。如果未标记 ATTENTION 状态,EDA HTML 报告中将不会显示这些图。
输出示例:
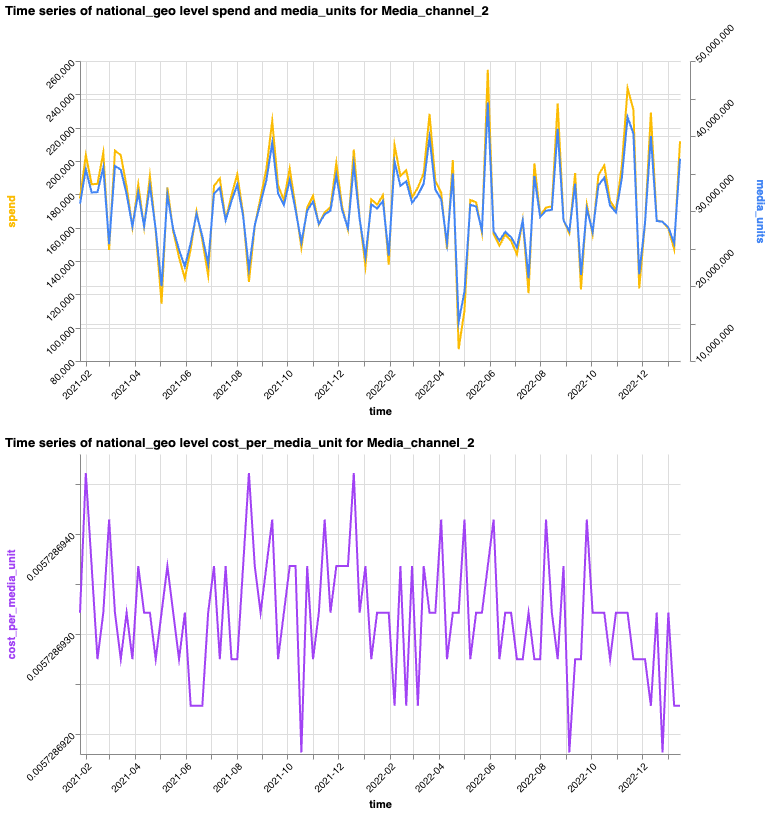
您可以针对特定渠道和地理位置,绘制支出、媒体单位数和每媒体单位费用的时序图,以便专注于分析部分数据:
mmm_eda.plot_cost_per_media_unit_time_series(
    geos=<list_of_geos>, channels=<list_of_channels>
)
注意:如果用户的支出数据缺少时间或地理位置维度,系统会自动根据媒体单位按比例分配这些维度。这样一来,每媒体单位费用将保持不变,支出和媒体单位数之间不会出现不一致的情况。因此,这些特定的数据检查将始终能够顺利通过。
类别 2:单个解释性变量或响应变量
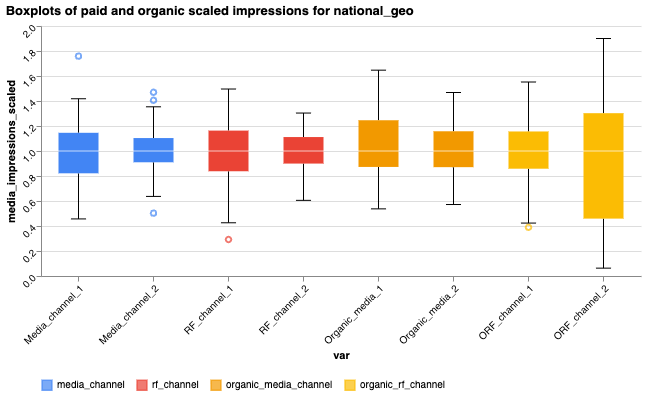
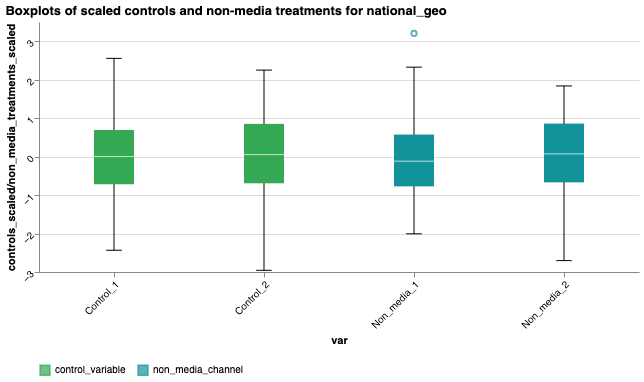
我们使用箱线图来说明每个变量的变异性。
图表按如下方式对变量进行分组:
- 按比例缩放的付费展示次数和自然展示次数:它们会一起显示在同一个图表中,因为它们都会经历输入数据文档中详述的相同转换流程。这包括 RF 和 ORF 渠道按比例缩放的 RF 展示次数,其中按比例缩放的 RF 展示次数的计算方式为:按比例缩放的覆盖面乘以频次。
- 按比例缩放的控制变量和非媒体处理变量:这些变量的转换方式类似,因此会一起显示在单独的图表中。
- 按比例缩放的 KPI:显示在独立的箱线图中。
对于地理位置级数据集,Meridian 的 EDA 软件包会先将原始(未按比例缩放)变量汇总到国家级,然后根据输入数据文档对变量进行转换,最后绘制出箱线图。
请查看箱线图中显示的解释性变量和响应变量的可变性。可变性非常低的解释性变量可能难以估计,还可能会阻碍模型收敛。您可以考虑合并或替换这些变量、舍弃可忽略不计的微小变量,在掌握相关信息的情况下,还可以使用自定义先验。如果存在离群值,请验证您的数据输入,确保这些值是真实值,而不是错误值。
输出示例:
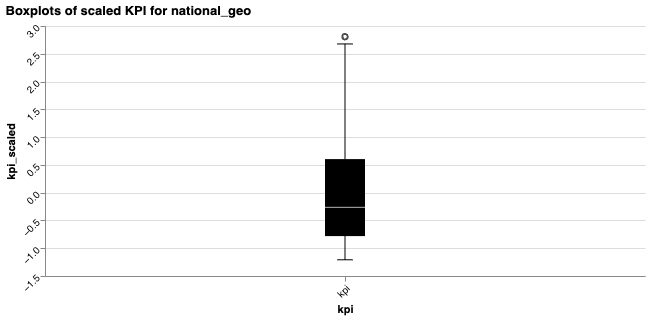
您可以绘制特定地理位置的箱线图:
# For paid and organic scaled impressions
mmm_eda.plot_treatments_without_non_media_boxplot(geos=<list_of_geos>)

# For controls and non-media treatments
mmm_eda.plot_controls_and_non_media_boxplot(geos=<list_of_geos>)

# For KPI
mmm_eda.plot_kpi_boxplot(geos=<list_of_geos>)
严重缺乏变异性
对于地理位置模型,系统会计算转换后的 KPI 在所有地理位置和时间段的标准差;对于国家级模型,则会计算在所有时间段的标准差。当转换后的 KPI 几乎完全恒定时(标准差小于 1e-4),系统会触发 ERROR。这意味着响应变量中没有信号。您应检查是否存在数据输入错误,或重新考虑使用此数据集进行统计建模的可行性。
对于解释性变量,Meridian 首先分别沿时间维度和地理位置维度(如果适用)计算按比例缩放的控制变量与按比例缩放的处理变量(包括 RF 和 ORF 渠道按比例缩放的覆盖面)的标准差。
- 在地理位置维度上的变异性:仅针对地理位置级数据集评估按比例缩放的变量在地理位置维度上的标准差,因为国家级模型只有一个地理位置。当您设置了
knots = n_times并且变量在地理位置间不存在差异时(例如,地理位置级数据集中的国家级变量),就会触发ERROR状态。当knots = n_times时,每个时间段都有自己的结形参。由于国家级变量只因时间而异,在地理位置间没有差异,因此它与时间完全共线,在全结模型中是多余的。如需解决这种冗余问题,您可以执行以下操作之一:(1) 保留国家级变量并设置knots < n_times;(2) 舍弃在不同地理位置间没有差异的变量。具体选择取决于您的特定解释目标。 - 在时间维度上的变异性:对于地理位置模型,当某个变量不随时间变化时,就会触发
ERROR状态,因为该变量会与地理位置主效应 $ au_g$ 完全共线。由于此冗余变量会导致模型收敛性较差,您应舍弃任何不随时间变化的变量。对于国家级模型,不随时间变化的变量相当于一个常量项,它无法提供任何信号,且会损害模型的收敛性。系统会显示ERROR状态,您应从模型中舍弃此常量变量。
离群值和潜在的数据稀疏性
Meridian 的 EDA 软件包还会使用标准四分位距 (IQR) 经验法则,检查每个按比例缩放的处理变量、按比例缩放的控制变量和按比例缩放的 KPI 中是否存在离群值(对于地理位置级数据集,此检查在地理位置级进行)。
如果存在离群值,此检查会标记 ATTENTION 状态,并在 EDA HTML 报告中显示前 5 个最极端的离群值(根据绝对值)。您应验证数据输入,以确保这些值是真实值,而不是错误值。
除了标记出离群值之外,此检查还会通过计算每个变量在包含和不包含这些离群值时的标准差来评估潜在的数据稀疏性。如果移除离群值后标准差降为零,即变量仅因离群值而显示出变异性,此检查会标记额外的 ATTENTION 状态。
- 如果处理变量或控制变量在移除离群值后标准差为零,则可能表明存在数据稀疏性问题。虽然这可能是故意为之(例如,由于“降低投放力度”期导致的数据稀疏性),但它可能会影响模型的收敛性和可识别性。请确认这是否是设计使然。如果不是,请考虑汇总这些变量,以提高模型稳定性。
- 如果 KPI 在移除离群值后在某些地理位置的标准差为零,则表明这些位置的响应变量中的信号较弱或不存在。请检查输入数据,或考虑将这些地理位置进行合并。
您可以使用以下代码,检索每个变量的标准差(在地理位置模型中针对特定地理位置计算),并将其映射到字典中以便于访问:
# For geo models
geo_std = mmm_eda.geo_stdev_check_outcome.analysis_artifacts
geo_std_dict = {a.variable: a.std_ds for a in geo_std}

# For national models
national_std = mmm_eda.national_stdev_check_outcome.analysis_artifacts
national_std_dict = {a.variable: a.std_ds for a in national_std}
类别 3:按人口比例缩放解释性变量
此类别仅适用于地理位置级数据集。对于国家级数据集,单个(国家级)地理位置被视为具有 1.0 的名义人口,且人口值不会影响模型,因为 Meridian 的内部缩放(中位数缩放或标准化)会抵消国家级人口效应。
人口与原始付费媒体变量或自然媒体变量之间的相关性
此检查会评估地理位置人口与原始付费媒体变量或原始自然媒体变量之间的 Spearman 相关性。这些变量包括原始媒体单位数、原始覆盖面(对于 RF 渠道)、原始自然媒体单位数和原始自然覆盖面(对于 ORF 渠道)。我们在此评估 Spearman 相关性,是为了评估人口与这些变量之间的对数线性关系。
这些变量的 Spearman 相关系数应为正值。如果您发现相关性较低或呈负相关,请检查您的数据输入。Meridian 的 EDA 软件包只会将这些检查标记为 INFO,而不会触发 ERROR 或 ATTENTION 状态,但仍强烈建议您查看这些值。
输出示例:
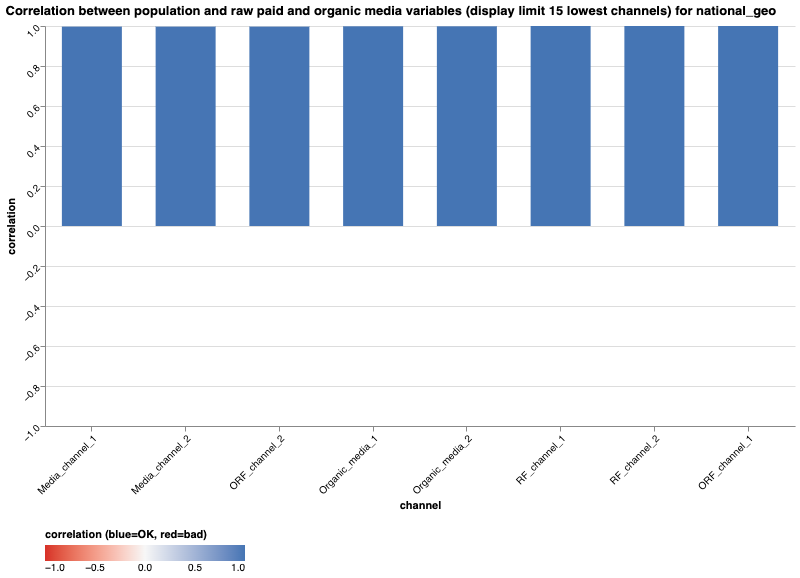
您可以使用以下代码,检索上述每个变量的相关系数值:
[pop_corr_raw] = (
    mmm_eda.eda_engine.check_population_corr_raw_media()
    .get_overall_artifacts()
)
pop_corr_raw.correlation_ds
人口与按比例缩放的处理变量和控制变量之间的相关性
这里按比例缩放的处理变量和控制变量是指根据输入数据文档转换后的量。对于非媒体处理变量和控制变量,它们还分别取决于 ModelSpec 中的 non_media_population_scaling_id 和 control_population_scaling_id 实参。请查看人口与按比例缩放的处理单位数或按比例缩放的控制变量之间的 Spearman 相关性。
- 控制变量和非媒体渠道:默认情况下,Meridian 不会按人口比例缩放这些变量。如果相关性较高,则表明您可能需要使用
ModelSpec中的control_population_scaling_id或non_media_population_scaling_id实参来按人口比例进行缩放。如需了解详情,请参阅按人口比例缩放控制变量。 - 付费媒体渠道和自然媒体渠道:默认情况下,Meridian 会自动按人口比例对这些渠道进行缩放。如果此处的相关性较高,则表明该变量在传递到 Meridian 之前可能已经按人口比例进行了缩放。请验证数据输入流水线。
与之前的检查一样,此检查也仅会被标记为 INFO,但您应查看这些值。
输出示例:
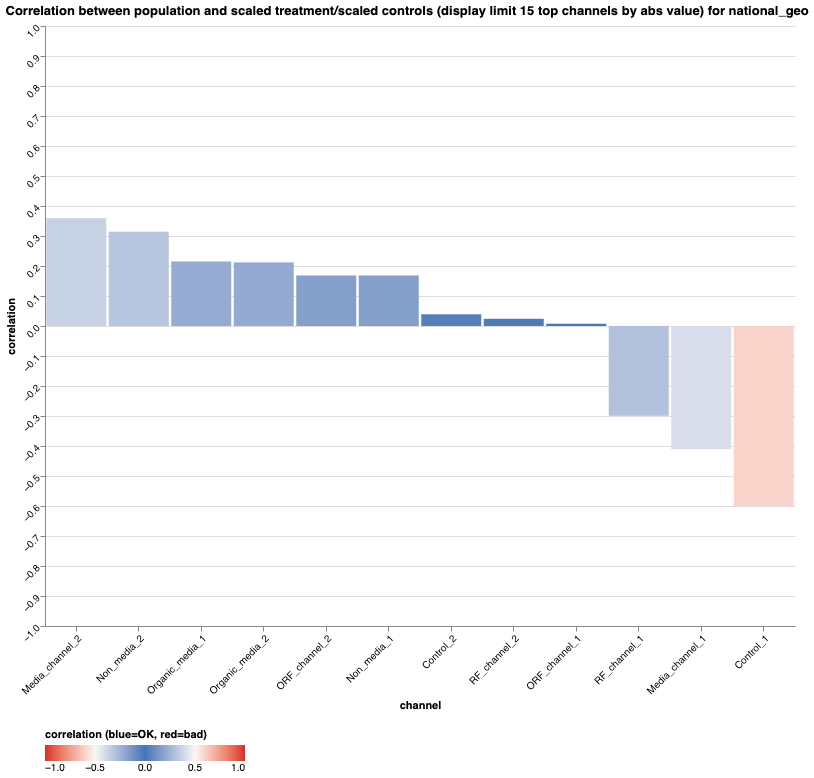
您可以使用以下代码,检索相关系数值:
[pop_corr_scaled] = (
    mmm_eda.eda_engine.check_population_corr_scaled_treatment_control()
    .get_overall_artifacts()
)
pop_corr_scaled.correlation_ds
类别 4:变量之间的关系
这个类别旨在探索变量之间的相关性,以及解释性变量与时间和地理位置主效应之间的关系。
相关性热图
如果变量之间的成对相关性较高,可能会导致模型可识别性和收敛性问题。如果您发现相关性较高,请考虑合并受影响的变量。
输出示例:
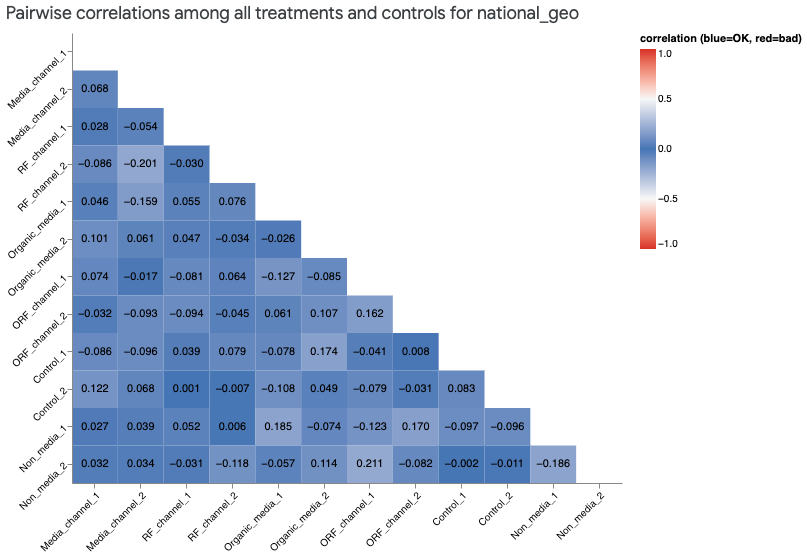
该热图显示了按比例缩放的处理变量与按比例缩放的控制变量之间的皮尔逊相关性。按比例缩放的处理变量包括 RF 和 ORF 渠道按比例缩放的 RF 展示次数。这里按比例缩放的处理变量和控制变量是指根据输入数据文档转换后的量。HTML 热图会根据按比例缩放的国家级变量显示相关性。对于地理位置级数据集,原始(未按比例缩放)变量会汇总到国家级,然后进行转换,最后计算它们的成对相关系数。
您可以使用以下代码,绘制任何特定地理位置的相关性热图:
mmm_eda.plot_pairwise_correlation(geos=<list_of_geos>)
使用方差膨胀因子 (VIF) 检查多重共线性
为了进一步评估多重共线性,系统会针对所有按比例缩放的处理单位数和按比例缩放的控制变量计算方差膨胀因子 (VIF)。VIF 用于估计处理变量或控制变量的方差因与其他处理变量或控制变量共线性而膨胀的程度。VIF 为 1 表示不存在共线性,值越高则表示多重共线性程度越高。完全成对相关是导致多重共线性的常见原因。高度多重共线性会扩大系数的可信区间,从而降低后验推理的可靠性。
根据模型类型,VIF 检查会评估数据并触发以下状态:
地理位置模型
ERROR状态:对于地理位置模型,VIF 是针对所有地理位置和时间段计算的。具体来说,系统会将每个变量在所有地理位置和时间段的值展平为一个数组,然后针对这些展平后的数组分别计算 VIF。如果有任何变量可以几乎完美地表示为其他变量的线性组合(VIF 超过默认的总体阈值 1,000),系统会触发ERROR状态。为了解决此问题,请舍弃属于其他变量线性组合的变量,或考虑合并这些变量。您可以使用以下代码,检索地理位置模型的总体 VIF(针对所有地理位置和时间段计算得出):
[overall_vif] = mmm_eda.eda_engine.check_geo_vif().get_overall_artifacts()
overall_vif.vif_da
国家级模型
ERROR状态:对于国家级模型,由于只有一个地理位置,因此系统会针对所有时间段计算 VIF。如果变量的 VIF 超过默认的国家级阈值 1,000,则会触发ERROR状态。为了解决此问题,请舍弃属于其他变量线性组合的变量,或考虑合并这些变量。您可以使用以下代码,检索计算出的国家级模型 VIF:
[national_vif] = mmm_eda.eda_engine.check_national_vif().get_national_artifacts()
national_vif.vif_da
地理位置模型
ATTENTION状态:对于地理位置模型,系统还会计算每个特定地理位置在所有时间段的 VIF。如果变量在各个地理位置内的 VIF 超过默认的地理位置阈值 1,000,则会触发ATTENTION状态。为解决此问题,请检查数据或合并这些变量,尤其是在它们在多个地理位置都显示高 VIF 的情况下。您可以使用以下代码,检索地理位置模型在各个地理位置的 VIF:
[geo_vif] = mmm_eda.eda_engine.check_geo_vif().get_geo_artifacts()
geo_vif.vif_da
如有必要,您可以调整这些极端阈值。如需详细了解如何设置这些阈值,请参阅自定义 VIF 阈值。
当触发上述任一 ERROR 或 ATTENTION 状态时,HTML 报告会以表格形式列出 VIF 最大的前五个变量,并列出与其高度相关的其他变量。
与地理位置主效应 $\tau_g$ 的共线性
此项检查会将每个变量对地理位置(作为分类变量)进行回归分析。在这种情况下,R 平方值较高表明变量随时间的变化较小。这可能会导致模型因地理位置主效应而难以识别且无法收敛。可以考虑舍弃 R 平方值非常高的变量。HTML 报告会以表格形式列出 R 平方值最大的前五个变量。此检查属于 INFO 级别,没有用于标记 ERROR 或 ATTENTION 的阈值,但我们建议您查看该表。
与时间主效应 $\mu_t$ 的共线性
此项检查会将每个变量对时间(作为分类变量)进行回归分析。R 平方值较高表明变量随地理位置的变化较小。如果使用了大量结,这可能会导致模型可识别性较弱且无法收敛。可以考虑舍弃 R 平方值非常高的变量,或减小 ModelSpec 中的 knots 实参。HTML 报告会以表格形式列出 R 平方值最大的前五个变量。此检查属于 INFO 级别(没有用于标记 ERROR 或 ATTENTION 的阈值),但我们建议您查看该表。
您可以使用以下代码,检索计算出的所有变量(对地理位置和时间)的 R 平方值:
[mmm_geo_time_collinearity] = (
    mmm_eda.eda_engine.check_variable_geo_time_collinearity()
    .get_overall_artifacts()
)
mmm_geo_time_collinearity.rsquared_ds
类别 5:先验设定
此类别旨在评估先验设定,特别是负基准的先验概率。负基准相当于处理效应获得过多功劳。请结合渠道级贡献率先验平均值条形图,查看负基准的先验概率。如果负基准的先验概率较高,请考虑自定义处理变量先验。具体而言,自定义 contribution 先验类型可能比较合适。
输出示例:
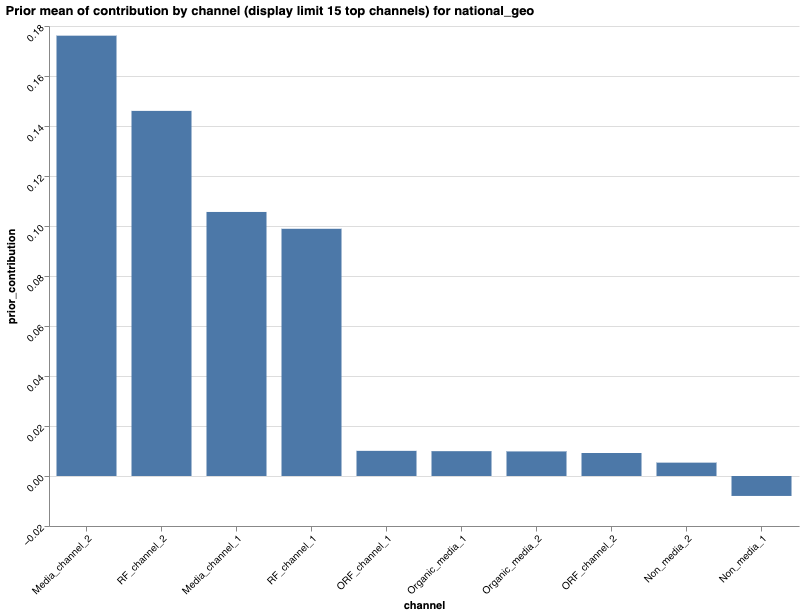
该图表仅显示了前 15 个渠道。您可以使用以下代码,获取负基准的先验概率和渠道级贡献率先验平均值:
[prior_check] = mmm_eda.eda_engine.check_prior_probability().get_overall_artifacts()

# This returns the prior probability of negative baseline
prior_check.prior_negative_baseline_prob

# This returns the channel-level prior mean of contribution
prior_check.mean_prior_contribution_da
其他检查、可视化图表和自定义设置
除了 HTML 报告之外,您还可以探索其他数据诊断和自定义配置,以定制 EDA 流程。
包含结的 KPI 时序图
您可以将国家级 KPI 时间序列与 ModelSpec 中指定的结叠加起来进行直观呈现:
mmm_eda.plot_national_kpi_with_knots_time_series()
输出示例:
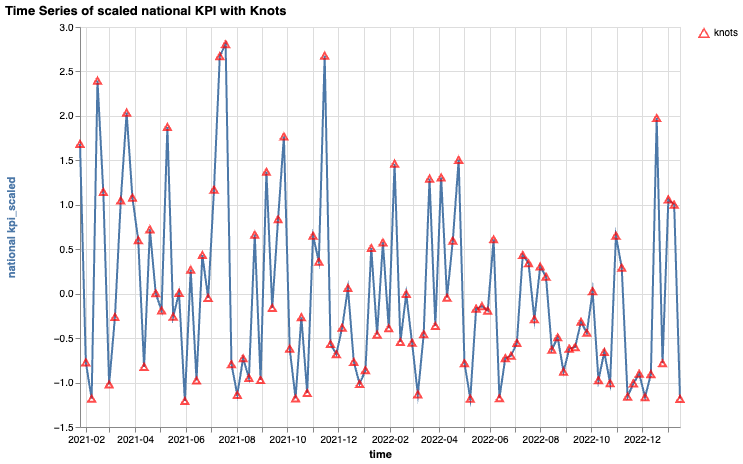
显示的结取决于 ModelSpec 中 knots 实参的配置:
- 默认设置:对于地理位置级数据集,Meridian 默认使用全结;而对于国家级模型,默认使用单结(如果只有单结,则省略图表)。
- AKS 算法:如果
enable_aks = True,此函数会绘制自动结选择 (AKS) 方法选择的结。 - 手动指定:绘制您手动定义的结位置。
这个包含结的 KPI 时序图是一种实用的可视化图表,可帮助您评估结的位置,并确定是否需要手动添加或删除任何结。如需更多指导,请参阅设置结。
成对相关性检查
Meridian 的 EDA 软件包会计算所有按比例缩放的处理单位数与按比例缩放的控制变量之间的皮尔逊成对相关系数。
地理位置模型
ERROR状态:对于地理位置模型,系统会先针对所有地理位置和时间段计算成对相关系数。具体而言,系统会将每个变量在所有地理位置和时间段的值展平为一个数组,然后计算这些展平数组之间的成对相关系数。如果有一对变量在所有地理位置和时间段都具有近乎完美的相关性(其成对相关系数的绝对值超过默认阈值 0.999),则会触发ERROR状态。如需解决此问题,请从输入数据中移除其中一个冗余变量。您可以使用以下代码,检索地理位置模型的总体成对相关系数(针对所有地理位置和时间段计算得出):
[overall_corr] = mmm_eda.eda_engine.check_geo_pairwise_corr().get_overall_artifacts()
overall_corr.corr_matrix
国家级模型
ERROR状态:对于国家级模型,由于只有一个地理位置,因此系统会针对所有时间段计算成对相关系数。如果一对变量的成对相关系数绝对值超过默认阈值 0.999,则会触发ERROR状态。如需解决此问题,请从输入数据中移除其中一个冗余变量。您可以使用以下代码,检索计算出的国家级模型成对相关系数:
[national_corr] = mmm_eda.eda_engine.check_national_pairwise_corr().get_national_artifacts()
national_corr.corr_matrix
地理位置模型
ATTENTION状态:对于地理位置模型,系统还会计算每个特定地理位置在所有时间段的成对相关系数。如果一对变量在各个地理位置内表现出近乎完美的相关性,超过 0.999 的默认阈值,则会触发ATTENTION状态。为解决此问题,请检查数据,或者考虑合并这些变量(如果它们在多个地理位置也都表现出较高的成对相关性)。您可以使用以下代码,检索地理位置模型在各个地理位置的成对相关系数:
[geo_corr] = mmm_eda.eda_engine.check_geo_pairwise_corr().get_geo_artifacts()
geo_corr.corr_matrix
如有必要,您可以调整这些极端阈值。如需详细了解如何设置这些阈值,请参阅自定义成对相关系数阈值。
用户可配置的自定义设置
Meridian 的 EDA 软件包提供了多种配置选项,可根据您的特定数据集和建模需求定制 EDA 过程。
从地理位置级到国家级的自定义汇总方法
如需对地理位置级数据集执行国家级 EDA,Meridian 的 EDA 软件包会在应用转换之前,先在内部将原始(未按比例缩放)地理位置级数据汇总到国家级。这样可以确保分析结果与以下操作的效果完全一致:用户先手动将地理位置级数据集汇总到国家级,再将汇总后的数据导入 Meridian 并进行 EDA。
默认情况下,所有原始媒体单位数、原始自然媒体单位数、原始覆盖面以及原始 KPI 都会在各个地理位置之间进行求和汇总。为了汇总频次,Meridian 的 EDA 软件包会先计算每个地理位置的原始 RF 展示次数(即覆盖面乘以频次),接着对所有地理位置的 RF 展示次数和覆盖面求和,最后用全国总 RF 展示次数除以全国总覆盖面。汇总自然频次时,也会进行类似的计算。
虽然默认的求和汇总方法适用于大多数变量,但您可以为特定的控制变量或非媒体处理变量定义自定义汇总方法。这对于二元变量或表示比率/百分比的变量尤其有用。
例如,如果您想计算名为 rating 的控制变量在所有地理位置的平均值,可以使用以下代码:
from meridian.model import model
from meridian.model.eda import eda_spec
import numpy as np

mmm_agg_config = eda_spec.AggregationConfig(
    control_variables={'rating': np.mean}
)
mmm_eda_spec = eda_spec.EDASpec(aggregation_config=mmm_agg_config)
mmm = model.Meridian(..., eda_spec=mmm_eda_spec)
自定义 VIF 阈值
Meridian 的 EDA 软件包会针对极端数据问题(例如,近乎完美的多重共线性)触发 ERROR 或 ATTENTION 状态。为了防止出现数值不稳定问题,同时保持灵活性,该软件包会使用默认的极端 VIF 阈值 1,000,而不是无穷大。您可以根据业务背景及合理判断来校准这些阈值:
geo_threshold:适用于地理位置级数据集。如果某个变量在特定地理位置的 VIF 超过此值,则会触发ATTENTION状态。后验抽样仍可继续进行。overall_threshold:适用于地理位置级数据集。如果某个变量的 VIF(针对所有地理位置和时间段计算得出)超过此值,则会触发ERROR状态。后验抽样将被阻断。national_threshold:适用于国家级数据集。如果变量的 VIF 超过此值,则会触发ERROR状态。后验抽样将被阻断。
例如,若要将多重共线性的 overall_threshold 从 1,000 降低到 50,请使用以下代码:
from meridian.model import model
from meridian.model.eda import eda_spec

mmm_custom_vif = eda_spec.VIFSpec(overall_threshold=50)
mmm_eda_spec = eda_spec.EDASpec(vif_spec=mmm_custom_vif)
mmm = model.Meridian(..., eda_spec=mmm_eda_spec)
自定义成对相关系数阈值
如果出现极端的成对相关系数,系统也会触发 ERROR 或 ATTENTION 状态。默认的极端相关系数阈值设为 0.999。您可以根据具体的数据集及合理判断来校准这些阈值:
geo_threshold:适用于地理位置级数据集。如果两个变量在特定地理位置的成对相关系数的绝对值超过此值,则会触发ATTENTION状态。后验抽样仍可继续进行。overall_threshold:适用于地理位置级数据集。如果成对相关系数(针对所有地理位置和时间段计算得出)的绝对值超过此值,则会触发ERROR状态。后验抽样将被阻断。national_threshold:适用于国家级数据集。如果成对相关系数的绝对值超过此值,则会触发ERROR状态。后验抽样将被阻断。
例如,如需将地理位置模型成对相关系数的 overall_threshold 从 0.999 降低到 0.95,请使用以下代码:
from meridian.model import model
from meridian.model.eda import eda_spec

mmm_custom_corr = eda_spec.PairwiseCorrSpec(overall_threshold=0.95)
mmm_eda_spec = eda_spec.EDASpec(pairwise_corr_spec=mmm_custom_corr)
mmm = model.Meridian(..., eda_spec=mmm_eda_spec)
其他自定义设置
Meridian EDA 软件包允许在 EDASpec 中设置其他可自定义的阈值。这些默认值起到了内部护栏的作用,可帮助软件包识别哪些属于常量变量。您极少需要调整这些默认值,但如果遇到特定的极端情况,也可酌情修改。
自定义
KpiInvariabilitySpec:正如严重缺乏变异性中所述,当转换后的 KPI 总体标准差低于默认的 1e-4 阈值时,Meridian 的 EDA 软件包会触发ERROR并阻止后验抽样。您可以使用KpiInvariabilitySpec调整std_threshold,从而设定用于让低变异性 KPI 触发此ERROR的阈值。例如,如需将
KpiInvariabilitySpec中的此std_threshold降低到 1e-5,请使用以下代码:from meridian.model import model from meridian.model.eda import eda_spec custom_kpi_spec = eda_spec.KpiInvariabilitySpec(std_threshold=1e-5) mmm_eda_spec = eda_spec.EDASpec(kpi_invariability_spec=custom_kpi_spec) mmm = model.Meridian(..., eda_spec=mmm_eda_spec)自定义
StandardDeviationSpec:正如离群点和潜在的数据稀疏性中所述,如果在移除离群点后计算出的变量标准差极低,则表明可能存在数据稀疏或信号缺乏的问题。您可以使用StandardDeviationSpec调整阈值,从而设定让这些低变异性变量在何时触发ATTENTION提醒。例如,如需将地理位置模型的标准差阈值降低到 1e-5,请调整
geo_std_threshold:from meridian.model import model from meridian.model.eda import eda_spec custom_std_spec = eda_spec.StandardDeviationSpec(geo_std_threshold=1e-5) mmm_eda_spec = eda_spec.EDASpec(std_spec=custom_std_spec) mmm = model.Meridian(..., eda_spec=mmm_eda_spec)对于国家级模型,请改为调整
national_std_threshold。从 VIF 计算中滤除常量变量:近乎恒定的变量可能会在方差膨胀因子 (VIF) 计算期间导致计算错误。默认情况下,任何标准差小于 1e-4 的变量都会从 VIF 计算中排除。您可以使用
VIFSpec中的std_threshold参数调整此限制。例如,如需将此阈值提高到 1e-3,请使用以下代码:from meridian.model import model from meridian.model.eda import eda_spec custom_vif_std = eda_spec.VIFSpec(std_threshold=1e-3) mmm_eda_spec = eda_spec.EDASpec(vif_spec=custom_vif_std) mmm = model.Meridian(..., eda_spec=mmm_eda_spec)