
Después de recopilar los datos, realiza un análisis de datos exploratorio (EDA) para encontrar y abordar cualquier problema de calidad de los datos. Este es un paso fundamental en el proceso Marketing Mix Modeling (MMM), ya que te permite evaluar los datos para confirmar que representan con precisión las iniciativas de marketing, las respuestas de los clientes y otras métricas pertinentes. Si corriges los problemas detectados a través del proceso de EDA, puedes mejorar la confiabilidad del resultado del modelo.
El proceso básico para realizar un EDA es el siguiente:
- Ejecuta una revisión de datos para identificar si hay datos faltantes o incompletos.
- Agrega los valores que falten en tus archivos de entrada sin procesar.
- Evalúa la precisión de los datos.
- Corrige las anomalías, los valores atípicos o las imprecisiones en los datos.
- Verifica la correlación entre las variables de control, medios y KPI.
Paquete de EDA de Meridian
El paquete de EDA de Meridian ayuda en este proceso generando un informe HTML de análisis exploratorio de datos (EDA) que puedes exportar a tu unidad de Google Drive. Este informe HTML proporciona visualizaciones y verificaciones de datos para ayudarte a identificar posibles problemas comunes con los datos. Cada verificación o visualización incluye una declaración que describe el problema de datos y los elementos de acción correspondientes.
Los hallazgos se categorizan en uno de los siguientes tres niveles de gravedad:
- ERROR: Identifica problemas de datos extremadamente graves que es muy probable que impidan la convergencia del modelo. Se usan umbrales predeterminados estrictos para el estado
ERROR, de modo que solo se marquen los errores más extremos, que suelen ser errores de datos de entrada. El muestreo de distribuciones a posteriori se bloqueará hasta que resuelvas estos problemas. - ATTENTION: Identifica posibles problemas importantes con los datos. Si bien estos problemas no impiden estrictamente la convergencia del modelo, indican con claridad las áreas que debes investigar y, posiblemente, corregir. Dado que ciertos casos de uso aún pueden justificar la ejecución del modelo, Meridian permite que continúe el muestreo de distribuciones a posteriori. Sin embargo, debes aplicar tu contexto empresarial para determinar si es adecuado continuar con tus datos actuales.
- INFO: Indica que no se activaron estados
ERRORniATTENTION, o bien destaca las verificaciones que no tienen umbrales definidos. Si bien es razonable esperar que se pueda ajustar un modelo útil en estas condiciones, debes revisar las métricas y visualizaciones a nivel deINFOpara identificar cualquier anomalía o incoherencia subyacente en los datos.
El resultado en HTML del EDA organiza los problemas de datos en cinco categorías:
- Inversión y unidad de medios: Analiza la participación de la inversión a nivel del canal y realiza una verificación cruzada de la inversión en relación con las unidades de medios.
- Variables de respuesta o explicativas individuales: Investiga la variabilidad de las variables individuales y marca problemas como la desviación estándar cero (falta de variación) o valores atípicos extremos.
- Ajuste de la población de las variables explicativas: Evalúa la relación entre la población y las variables explicativas.
- Relación entre las variables: Explora las correlaciones entre las variables, así como las relaciones entre las variables explicativas y los principales efectos geográficos o temporales.
- Especificaciones de la probabilidad a priori: Evalúa las especificaciones de la probabilidad a priori, en especial la probabilidad a priori de un valor de referencia negativo.
Configuración y generación de informes
Sigue estos pasos para generar el informe HTML de EDA o ejecutar las verificaciones de datos individuales que se describen en este documento.
Primero, crea una instancia del modelo
Meridiany del objetoMeridianEDA. Ejecuta el siguiente código de configuración una vez:from meridian.model import model from meridian.model.eda import meridian_eda mmm = model.Meridian(...) mmm_eda = meridian_eda.MeridianEDA(mmm)Nota: Los fragmentos de código posteriores de esta página omiten esta configuración y solo muestran las llamadas de métodos específicos con el objeto
mmm_eda.Una vez que se complete la configuración, ejecuta el siguiente código para generar y guardar el informe HTML completo del EDA:
import IPython

mmm_eda.generate_and_save_report(
    filename=your_filename, filepath=your_filepath
)
IPython.display.HTML(filename=f'{your_filepath}{your_filename}')
Categoría 1: Inversión y unidad de medios
En esta categoría, se analiza el porcentaje de inversión a nivel del canal y se realiza una verificación cruzada de la inversión en relación con las unidades de medios.
Porcentaje de inversión
Resultado de ejemplo:
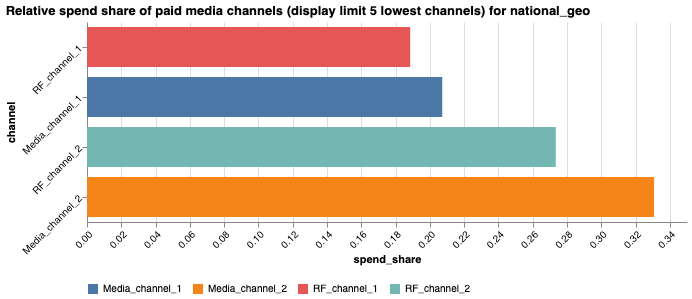
El gráfico de barras del informe HTML muestra el porcentaje de la inversión a nivel nacional (agregada en todas las ubicaciones geográficas para los modelos a nivel geográfico) de cada canal de medios y de frecuencia y alcance para los 5 canales con menor inversión.
Revisa el porcentaje de la inversión total de cada canal. Es posible que sea difícil estimar los canales con un porcentaje de inversión muy bajo, por lo que te recomendamos que los combines con otros canales.
También puedes generar un gráfico del porcentaje de inversión para ubicaciones geográficas específicas y para una cantidad determinada de canales con el menor porcentaje de inversión:
mmm_eda.plot_relative_spend_share_barchart(
    geos=<list_of_geos>, n_channels=<your_integer_choice>
)
Proporción entre datos y parámetros
Después de revisar el desglose del porcentaje de inversión, evalúa la proporción de datos en relación con los parámetros del modelo. Esta proporción sirve como guía aproximada de la cantidad de datos necesarios para estimar de manera confiable los parámetros del modelo. La forma más precisa de evaluar esta proporción es ejecutar el modelo y analizar la amplitud de los intervalos creíbles.
La proporción se define como n_data_points/n_parameters, donde se especifica lo siguiente:
n_data_points=n_geos*n_timesn_parameters=n_geos- 1 +n_knots+n_controls+n_treatments
Los componentes de este cálculo incluyen los siguientes:
n_geos: Es la cantidad de ubicaciones geográficas en el conjunto de datos. Restamos una para la ubicación geográfica de referencia.n_times: Es la cantidad de períodos.n_knots: Es la cantidad de nudos especificados con el argumentoknotsenModelSpec.n_controls: Es la cantidad de variables de control.n_treatments: Es la cantidad total de variables de tratamiento, incluidos los medios pagados y orgánicos, los medios de alcance y frecuencia (pagados y orgánicos), y las variables de tratamiento que no son de medios.
Este cálculo excluye los parámetros separados a nivel geográfico para n_treatments y n_controls. En el modelo jerárquico de Meridian, los efectos a nivel geográfico no son independientes, sino que el intercambio de información entre las distintas ubicaciones geográficas reduce significativamente el recuento de parámetros efectivos. El recuento a nivel nacional sirve como valor de referencia práctico y preciso. Para ver una comparación con una vista estricta que no supone ninguna agrupación, consulta la sección Cantidad de datos necesarios.
Una proporción muy pequeña puede indicar que no hay suficientes datos para la estimación, lo que genera una varianza alta y estimaciones poco confiables. Si esto ocurre, considera descartar o combinar canales, o bien reducir la cantidad de nudos con el argumento knots en ModelSpec. Al decidir qué canales modificar, usa la información obtenida en la subsección Porcentaje de inversión para identificar aquellos con la inversión más baja.
Para obtener más información sobre los requisitos de datos y los matices del modelado jerárquico geográfico, consulta Cantidad de datos necesarios.
Inversión, unidad de medios y costo por unidad de medios
En el caso de los canales de medios y de alcance y frecuencia, se realizan verificaciones cruzadas de la inversión, las unidades de medios y el costo por unidad de medios. Las unidades de medios analizadas aquí son unidades de medios sin procesar (sin ajustar). En el caso de los canales de alcance y frecuencia, las unidades de medios son las impresiones de alcance y frecuencia, que se calculan como el alcance sin procesar (sin ajustar) multiplicado por la frecuencia.
Estas verificaciones cruzadas identifican las incoherencias entre los datos de la inversión y las unidades de medios, como una inversión nula con unidades de medios positivas o una inversión positiva con unidades de medios nulas. Si se encuentran incoherencias, se marca un estado ATTENTION.
Revisa los datos de entrada para estos canales de medios pagados marcados y su inversión.
Esta verificación también marca un estado ATTENTION si hay valores atípicos en el costo por unidad de medios (calculado como la inversión dividida por las unidades de medios). El paquete de EDA de Meridian define un valor atípico con la regla empírica del rango intercuartílico (IQR): valores menores que Q1 - 1.5 * IQR o mayores que Q3 + 1.5 * IQR. La tabla HTML muestra los valores absolutos del costo por unidad de medios para los cinco valores atípicos más extremos, ordenados de forma descendente. Verifica si hay errores en los datos de entrada en estos canales.
Puedes ejecutar el siguiente código para recuperar el costo por unidad de medios calculado de todos los canales de medios y de alcance y frecuencia en cada período (y para cada ubicación geográfica en los modelos geográficos):
# For geo models
[geo_cpm] = mmm_eda.geo_cost_per_media_unit_check_outcome.get_geo_artifacts()
geo_cpm.cost_per_media_unit_da

# For national models
[national_cpm] = (
    mmm_eda.national_cost_per_media_unit_check_outcome
    .get_national_artifacts()
)
national_cpm.cost_per_media_unit_da
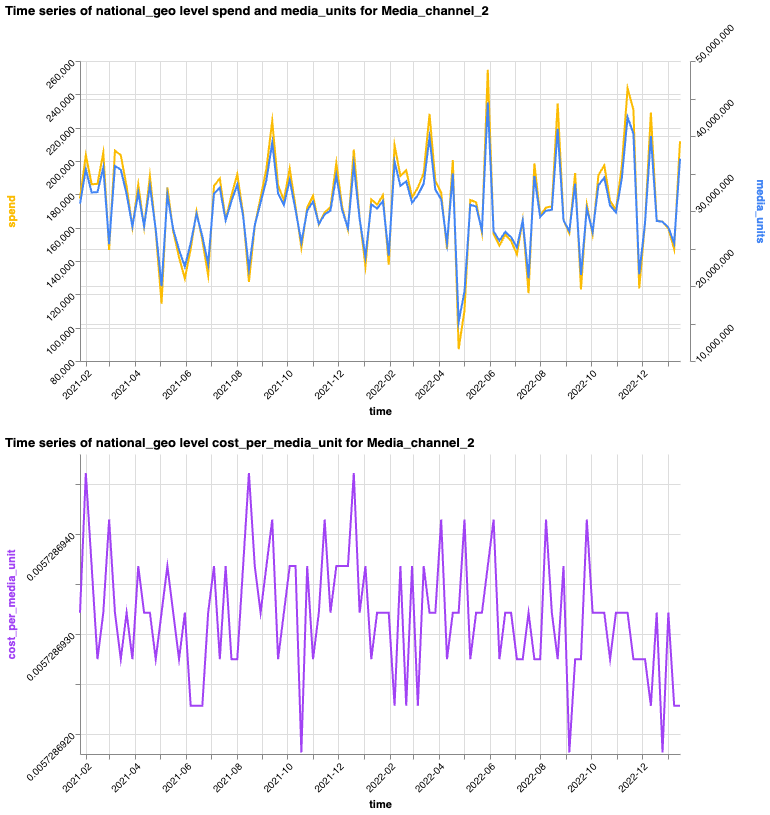
El informe en HTML también incluye dos gráficos de series temporales para los canales marcados con el estado ATTENTION (ya sea por incoherencias o valores atípicos). El primer gráfico superpone la serie temporal de la inversión a nivel del canal con la serie temporal de las unidades de medios. El segundo gráfico muestra la serie temporal a nivel del canal del costo por unidad de medios. Cada gráfico de serie temporal corresponde a un canal.
Estos gráficos de series temporales en HTML se basan en cantidades a nivel nacional. En el caso de los conjuntos de datos a nivel geográfico, el costo y las unidades de medios de cada canal se agregan a nivel nacional antes de calcular la proporción del costo por unidad de medios. Si no se marcan estados ATTENTION, estos gráficos no aparecerán en el informe HTML del EDA.
Resultado de ejemplo:
Puedes generar un gráfico de la serie temporal de la inversión, las unidades de medios y el costo por unidad de medios para canales y ubicaciones geográficas específicos y, así, enfocarte en un subconjunto de tus datos:
mmm_eda.plot_cost_per_media_unit_time_series(
    geos=<list_of_geos>, channels=<list_of_channels>
)
Nota: Si los datos de inversión del usuario no incluyen dimensiones de tiempo o geográficas, se asignan automáticamente a esas dimensiones de forma proporcional a las unidades de medios. Esto genera un costo constante por unidad de medios, y no se producirían inconsistencias entre la inversión y las unidades de medios. Por lo tanto, estas verificaciones de datos específicas siempre se aprobarán.
Categoría 2: Variables explicativas o de respuesta individuales
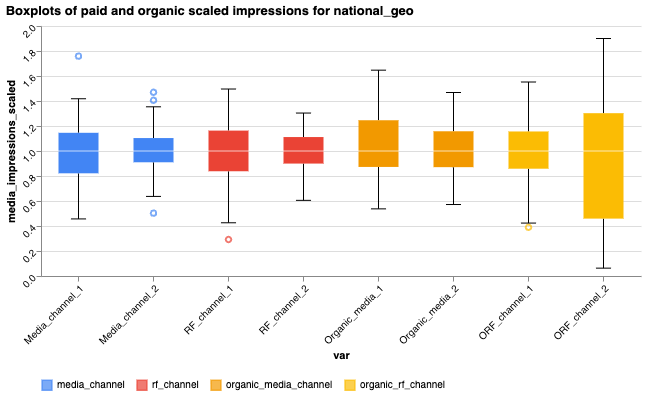
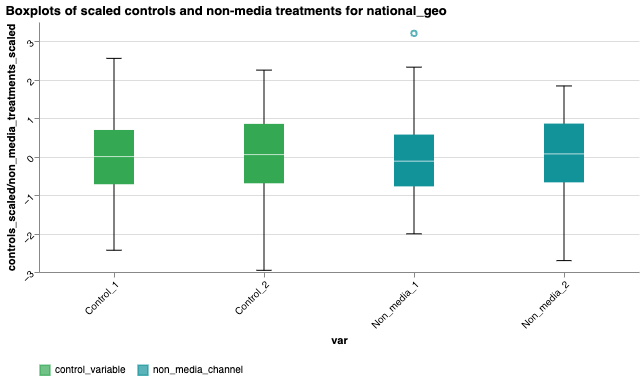
Ilustramos la variación de cada variable con diagramas de caja.
Los gráficos agrupan las variables de la siguiente manera:
- Impresiones pagadas y orgánicas ajustadas: Se muestran juntas en un gráfico, ya que se someten a las mismas transformaciones que se detallan en la documentación de datos de entrada. Estas incluyen las impresiones de alcance y frecuencia ajustadas para los canales de alcance y frecuencia tanto pagados como orgánicos, en los que las impresiones de alcance y frecuencia ajustadas se calculan como el alcance ajustado multiplicado por la frecuencia.
- Controles y tratamientos que no son de medios ajustados: Se muestran juntos en un gráfico separado, ya que estas variables se transforman de manera similar.
- KPI ajustado: Se muestra en su propio diagrama de caja.
En el caso de los conjuntos de datos a nivel geográfico, el paquete de EDA de Meridian primero agrega las variables sin procesar (sin ajustar) a nivel nacional, luego transforma las variables según la documentación de datos de entrada y, luego, genera los diagramas de caja.
Revisa la variabilidad de las variables explicativas y las variables de respuesta que se muestran en los diagramas de caja. Las variables explicativas con muy poca variabilidad pueden ser difíciles de estimar y pueden obstaculizar la convergencia del modelo. Considera combinarlas o reemplazarlas, descartar las variables insignificantes o usar una distribución a priori personalizada si tienes información pertinente. Si hay valores atípicos, verifica los datos de entrada para asegurarte de que sean legítimos y no erróneos.
Resultado de ejemplo:
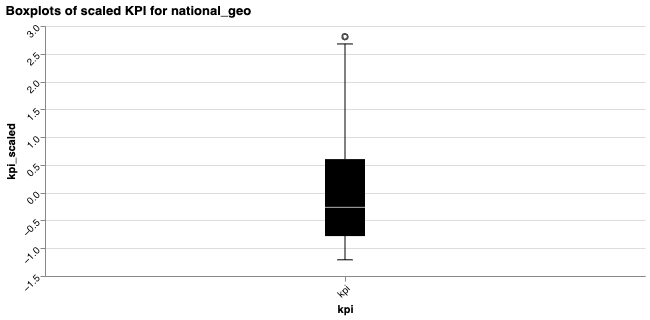
Puedes generar diagramas de caja para ubicaciones geográficas específicas:
# For paid and organic scaled impressions
mmm_eda.plot_treatments_without_non_media_boxplot(geos=<list_of_geos>)

# For controls and non-media treatments
mmm_eda.plot_controls_and_non_media_boxplot(geos=<list_of_geos>)

# For KPI
mmm_eda.plot_kpi_boxplot(geos=<list_of_geos>)
Falta de variación crítica
La desviación estándar del KPI transformado se calcula en todas las ubicaciones geográficas y los períodos en el caso de los modelos geográficos, o en todos los períodos en el caso de los modelos a nivel nacional. Se activa un ERROR cuando el KPI transformado es casi completamente constante, lo que se indica con una desviación estándar inferior a 1e-4. Esto significa que no hay ningún indicador en la variable de respuesta. Debes verificar si hay errores en los datos de entrada o reconsiderar la viabilidad del modelado estadístico con este conjunto de datos.
Para las variables explicativas, Meridian primero calcula la desviación estándar de las variables de control y de tratamiento ajustadas (incluido el alcance ajustado para los canales de alcance y frecuencia tanto pagados como orgánicos) a lo largo de las dimensiones temporal y geográfica (si corresponde) por separado.
- Variación en las ubicaciones geográficas: La desviación estándar de las variables ajustadas según la dimensión geográfica solo se evalúa para los conjuntos de datos a nivel geográfico, ya que un modelo a nivel nacional solo tiene una ubicación geográfica. El estado
ERRORocurre cuando se estableceknots = n_timesy una variable no varía en las diferentes ubicaciones geográficas (por ejemplo, una variable a nivel nacional en un conjunto de datos a nivel geográfico). Cuandoknots = n_times, cada período tiene su propio parámetro de nudo. Dado que una variable a nivel nacional varía solo a lo largo del tiempo y no entre ubicaciones geográficas, es perfectamente colineal con el tiempo y resulta redundante en un modelo de nudos completos. Para resolver esta redundancia, puedes hacer lo siguiente: (1) conservar la variable a nivel nacional y establecerknots < n_times, o (2) descartar las variables que no varían entre las diferentes ubicaciones geográficas. La elección depende de tus objetivos de interpretación específicos. - Variación a lo largo del tiempo: En el caso de los modelos geográficos, el estado
ERRORocurre cuando una variable no varía a lo largo del tiempo, ya que se vuelve perfectamente colineal con el efecto principal de la ubicación geográfica $\tau_g$. Como esta variable redundante genera una convergencia deficiente del modelo, debes descartar cualquier variable que no varíe a lo largo del tiempo. En el caso de los modelos a nivel nacional, una variable que no varía a lo largo del tiempo actúa como término constante que no proporciona ningún indicador y perjudica la convergencia del modelo. Se producirá un estadoERROR, y deberás quitar esta variable constante del modelo.
Valores atípicos y posible dispersión de los datos
El paquete de EDA de Meridian también verifica si hay valores atípicos en las variables de tratamiento, de control y de KPI ajustadas (esta verificación se realiza a nivel geográfico para los conjuntos de datos a nivel geográfico) con la regla práctica estándar del rango intercuartílico (IQR).
Si hay valores atípicos, esta verificación marca el estado ATTENTION y muestra los cinco valores atípicos más extremos (según el valor absoluto) en el informe HTML del EDA.
Debes verificar los datos de entrada para asegurarte de que estos valores sean legítimos y no erróneos.
Independientemente del marcado de los valores atípicos, esta verificación también evalúa la posible dispersión de datos calculando la desviación estándar de cada variable con estos valores atípicos y sin ellos. Si, tras quitar los valores atípicos, la desviación estándar se reduce a cero, lo que significa que la variable solo muestra variación debido a los
valores atípicos, esta verificación marca un estado ATTENTION adicional.
- Si las variables de tratamiento o de control muestran una desviación estándar de cero después de quitar los valores atípicos, esto puede ser un indicador de dispersión de datos. Si bien esto puede ser intencional (p. ej., dispersión de datos debido a períodos de "supresión"), puede afectar la convergencia y la identificabilidad del modelo. Verifica si esto es intencional. Si no es así, considera agregar estas variables para mejorar la estabilidad del modelo.
- Si el KPI tiene una desviación estándar de cero en ciertas ubicaciones geográficas después de quitar los valores atípicos, significa que hay un indicador débil o inexistente en la variable de respuesta para esas ubicaciones. Revisa los datos de entrada o considera agrupar estas ubicaciones geográficas.
Puedes recuperar las desviaciones estándares de cada variable (que se calculan para ubicaciones geográficas específicas en los modelos geográficos) y asignarlas a un diccionario para facilitar el acceso con el siguiente código:
# For geo models
geo_std = mmm_eda.geo_stdev_check_outcome.analysis_artifacts
geo_std_dict = {a.variable: a.std_ds for a in geo_std}

# For national models
national_std = mmm_eda.national_stdev_check_outcome.analysis_artifacts
national_std_dict = {a.variable: a.std_ds for a in national_std}
Categoría 3: Ajuste de las variables explicativas según la población
Esta categoría solo se aplica a los conjuntos de datos a nivel geográfico. En el caso de los conjuntos de datos a nivel nacional, se considera que la única ubicación geográfica (nacional) tiene una población nominal de 1.0, y los valores de población no afectan el modelo porque el ajuste interno de Meridian (ajuste de la mediana o estandarización) anula el efecto de la población nacional.
Correlación entre la población y las variables de medios orgánicos o pagados sin procesar
Esta verificación evalúa la correlación de Spearman entre la población geográfica y las variables de medios orgánicos sin procesar o pagados sin procesar. Estas variables incluyen las versiones sin procesar de unidades de medios, alcance (para canales de alcance y frecuencia), unidades de medios orgánicos y alcance orgánico (para canales de alcance y frecuencia orgánicos). Aquí evaluamos la correlación de Spearman para determinar la relación log-lineal entre la población y estas variables.
Cabe esperar valores positivos en la correlación de Spearman de estas variables. Si observas una correlación baja o negativa, verifica los datos de entrada. El paquete de EDA de Meridian etiqueta estas verificaciones solo como INFO, sin activar los estados ERROR ni ATTENTION, pero se recomienda revisar los valores.
Resultado de ejemplo:
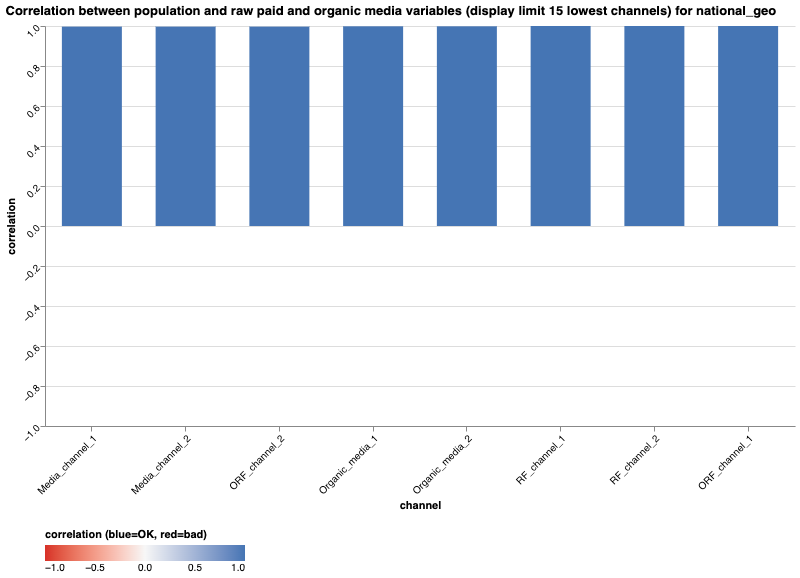
Puedes recuperar los valores de correlación para cada una de las variables mencionadas anteriormente con el siguiente código:
[pop_corr_raw] = (
    mmm_eda.eda_engine.check_population_corr_raw_media()
    .get_overall_artifacts()
)
pop_corr_raw.correlation_ds
Correlación entre la población y los tratamientos y controles ajustados
Los tratamientos y los controles ajustados que se muestran aquí hacen referencia a las cantidades transformadas según la documentación de datos de entrada. En el caso de los controles y los tratamientos que no son de medios, también dependen de los argumentos non_media_population_scaling_id y control_population_scaling_id en ModelSpec, respectivamente. Revisa la correlación de Spearman entre la población y las unidades de tratamiento ajustadas o las variables de control ajustadas.
- Controles y canales que no son de medios: Meridian no ajusta estas variables según la población de forma predeterminada. Una correlación alta indica que es probable que debas aplicar el ajuste de la población con los argumentos
control_population_scaling_idonon_media_population_scaling_idenModelSpec. Para obtener más información, consulta Cómo ajustar las variables de control según la población. - Canales de medios orgánicos y pagados: Meridian ajusta automáticamente estos canales según la población de forma predeterminada. Una correlación alta aquí sugiere que la variable ya podría haberse ajustado según la población antes de pasar a Meridian. Verifica tu canalización de datos de entrada.
Al igual que la verificación anterior, esta se marca solo como INFO, pero debes revisar los valores.
Resultado de ejemplo:
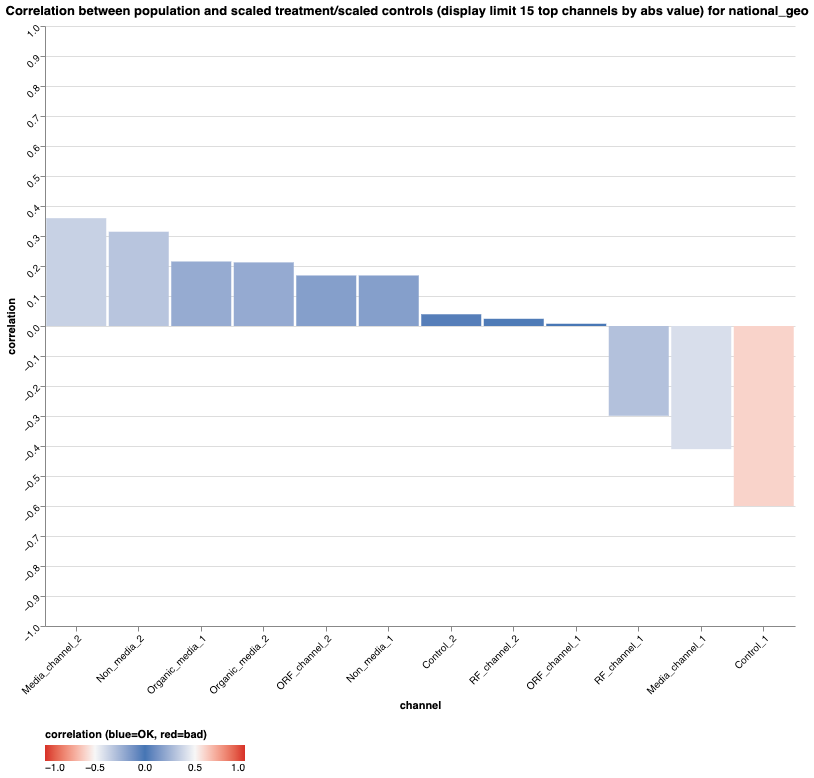
Puedes recuperar los valores de correlación con el siguiente código:
[pop_corr_scaled] = (
    mmm_eda.eda_engine.check_population_corr_scaled_treatment_control()
    .get_overall_artifacts()
)
pop_corr_scaled.correlation_ds
Categoría 4: Relación entre las variables
En esta categoría, se exploran las correlaciones entre las variables, así como las relaciones entre las variables explicativas y los principales efectos geográficos o temporales.
Mapa de calor de correlación
La alta correlación por pares entre las variables puede causar problemas de identificabilidad y convergencia del modelo. Si observas una correlación alta, considera combinar las variables afectadas.
Resultado de ejemplo:
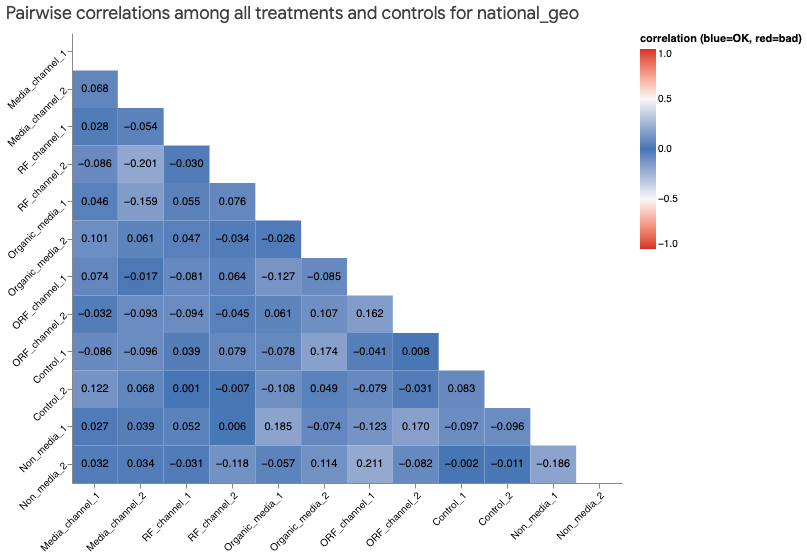
El mapa de calor ilustra la correlación de Pearson entre los tratamientos ajustados y las variables de control ajustadas. Las variables de tratamiento ajustadas incluyen las impresiones de alcance y frecuencia ajustadas para los canales de alcance y frecuencia tanto pagados como orgánicos. Los tratamientos y los controles ajustados que se muestran aquí hacen referencia a las cantidades transformadas según la documentación de datos de entrada. El mapa de calor HTML muestra las correlaciones basadas en variables ajustadas a nivel nacional. En el caso de los conjuntos de datos a nivel geográfico, las variables sin procesar (sin ajustar) se agregan al nivel nacional, luego se transforman y, por último, se calcula su correlación por pares.
Puedes usar el siguiente código para generar el mapa de calor de correlación de cualquier ubicación geográfica específica:
mmm_eda.plot_pairwise_correlation(geos=<list_of_geos>)
Multicolinealidad con la verificación del factor de inflación de varianza (VIF)
Para evaluar aún más la multicolinealidad, se calcula el factor de inflación de varianza (VIF) para todas las unidades de tratamiento ajustadas y las variables de control ajustadas. El VIF estima en qué medida aumenta la varianza de una variable de tratamiento o de control debido a la colinealidad con otros tratamientos o controles. Un VIF de 1 indica que no hay colinealidad, mientras que los valores más altos indican una mayor multicolinealidad. La correlación perfecta por pares es una causa común de multicolinealidad. La multicolinealidad alta amplía los intervalos creíbles de los coeficientes, lo que reduce la confiabilidad de la inferencia de la distribución a posteriori.
Según el tipo de modelo, la verificación del VIF evalúa los datos y activa los siguientes estados:
Estado
ERRORdel modelo geográfico: En el caso de los modelos geográficos, el VIF se calcula en todas las ubicaciones geográficas y todos los períodos. Específicamente, los valores de cada variable en todas las ubicaciones geográficas y todos los períodos se aplanan en un solo array, y luego se calcula el VIF para cada uno de estos arrays aplanados. Se activa un estadoERRORsi alguna variable puede expresarse casi perfectamente como una combinación lineal de otras, lo que se demuestra con un VIF que supera el umbral general predeterminado de 1,000. Para solucionar este problema, descarta las variables que sean combinaciones lineales de otras o considera combinarlas.Puedes recuperar los VIF generales del modelo geográfico (calculados en todas las ubicaciones geográficas y todos los períodos) con el siguiente código:
[overall_vif] = mmm_eda.eda_engine.check_geo_vif().get_overall_artifacts()
overall_vif.vif_da
Estado
ERRORdel modelo a nivel nacional: En el caso de los modelos a nivel nacional, el VIF se calcula en todos los períodos, ya que solo hay una ubicación geográfica. Se activa un estadoERRORsi el VIF de una variable supera el umbral nacional predeterminado de 1,000. Para solucionar este problema, descarta las variables que sean combinaciones lineales de otras o considera combinarlas.Puedes recuperar los VIF calculados para el modelo a nivel nacional con el siguiente código:
[national_vif] = mmm_eda.eda_engine.check_national_vif().get_national_artifacts()
national_vif.vif_da
Estado
ATTENTIONdel modelo geográfico: En el caso de los modelos geográficos, el VIF también se calcula a lo largo de todos los períodos para cada ubicación geográfica específica. Se genera un estadoATTENTIONsi las variables superan el umbral geográfico predeterminado de 1,000 en las ubicaciones geográficas individuales. Para solucionar este problema, verifica los datos o combina estas variables, en especial si muestran un VIF alto en varias ubicaciones geográficas.Puedes recuperar los VIF del modelo geográfico para ubicaciones geográficas individuales con el siguiente código:
[geo_vif] = mmm_eda.eda_engine.check_geo_vif().get_geo_artifacts()
geo_vif.vif_da
Puedes ajustar estos umbrales extremos en caso de ser necesario. Para obtener más detalles sobre cómo establecer estos umbrales, consulta Umbral de VIF personalizado.
Cuando se activa cualquiera de estos estados ERROR o ATTENTION, el informe HTML tabula las cinco variables principales con el VIF más alto y enumera las otras variables con las que se correlacionan en gran medida.
Colinealidad con el efecto principal de la ubicación geográfica $\tau_g$
En esta verificación, se realiza una regresión de cada variable en función de la ubicación geográfica como una variable categórica. En este caso, un valor de R al cuadrado alto indica una variación temporal baja de una variable. Esto podría generar un modelo poco identificable y no convergente debido a los efectos principales de la ubicación geográfica.
Considera descartar la variable con un valor de R al cuadrado muy alto. En el informe HTML, se tabulan las cinco variables principales con los valores de R al cuadrado más altos.
Esta verificación se realiza a nivel de INFO sin umbrales para marcar ERROR o ATTENTION, pero te recomendamos que revises la tabla.
Colinealidad con el efecto principal del tiempo $\mu_t$
Esta verificación realiza una regresión de cada variable en función del tiempo como una variable categórica. Un valor de R al cuadrado alto indica una variación geográfica baja de una variable. Esto podría generar un modelo poco identificable y no convergente si se usa una gran cantidad de nudos.
Considera quitar la variable con un valor de R al cuadrado muy alto o reducir el argumento knots en ModelSpec. En el informe HTML, se tabulan las cinco variables principales con los valores de R al cuadrado más altos. Esta verificación se realiza a nivel de INFO (no hay umbrales para marcar los estados ERROR o ATTENTION), pero recomendamos revisar la tabla.
Puedes recuperar los valores de R al cuadrado calculados para todas las variables (en relación con la ubicación geográfica y el tiempo) con el siguiente código:
[mmm_geo_time_collinearity] = (
    mmm_eda.eda_engine.check_variable_geo_time_collinearity()
    .get_overall_artifacts()
)
mmm_geo_time_collinearity.rsquared_ds
Categoría 5: Especificaciones de la probabilidad a priori
En esta categoría, se evalúan las especificaciones de la probabilidad a priori, específicamente la probabilidad a priori de un valor de referencia negativo. Un valor de referencia negativo es equivalente a que los efectos del tratamiento reciben demasiado crédito. Revisa la probabilidad a priori del modelo de referencia negativo junto con el gráfico de barras de la media de la probabilidad a priori de la contribución a nivel del canal. Si la probabilidad a priori del modelo de referencia negativo es alta, considera usar probabilidades a priori del tratamiento personalizadas. En particular, puede ser apropiado un tipo de probabilidad a priori personalizado de contribution.
Resultado de ejemplo:
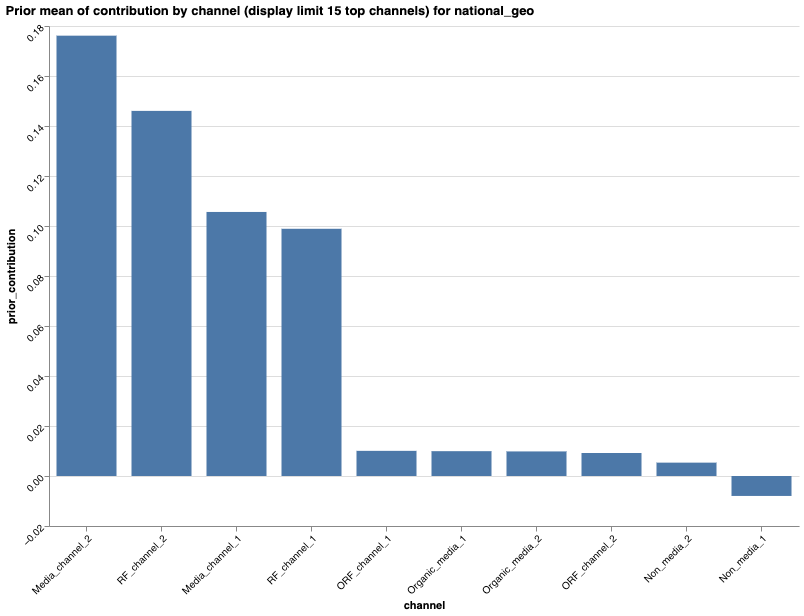
En el gráfico, solo se muestran los 15 canales principales. Puedes obtener la probabilidad a priori de un modelo de referencia negativo y la media de la probabilidad a priori de la contribución a nivel del canal con el siguiente código:
[prior_check] = mmm_eda.eda_engine.check_prior_probability().get_overall_artifacts()

# This returns the prior probability of negative baseline
prior_check.prior_negative_baseline_prob

# This returns the channel-level prior mean of contribution
prior_check.mean_prior_contribution_da
Comprobaciones, visualizaciones y personalizaciones adicionales
Además del informe HTML, puedes explorar diagnósticos de datos adicionales y configuraciones personalizadas para adaptar el proceso de EDA.
Serie temporal del KPI con nudos
Puedes visualizar la serie temporal del KPI a nivel nacional superpuesta con los nudos especificados en ModelSpec:
mmm_eda.plot_national_kpi_with_knots_time_series()
Resultado de ejemplo:
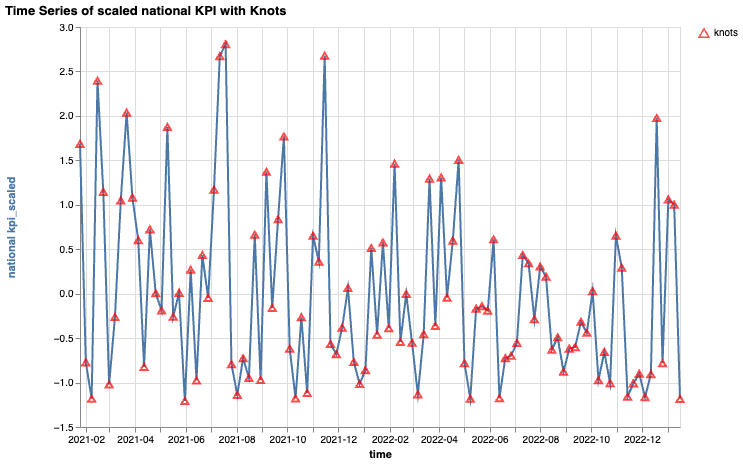
Los nudos que se muestran dependen de la configuración del argumento knots en ModelSpec:
- Configuración predeterminada: Meridian usa nudos completos para los conjuntos de datos a nivel geográfico, mientras que un solo nudo es el valor predeterminado para los modelos a nivel nacional (el gráfico se omite si solo hay un nudo).
- Algoritmo de AKS: Si es
enable_aks = True, esta función genera un gráfico de los nudos seleccionados por el método de selección automática de nudos (AKS). - Especificación manual: Genera un gráfico con las ubicaciones de los nudos que definiste de forma manual.
Este gráfico de la serie temporal del KPI con nudos ofrece una visualización útil para evaluar la ubicación de los nudos y determinar si es necesario agregar o quitar nudos manualmente. Para obtener más orientación, consulta Cómo establecer nudos.
Verificación de correlación por pares
El paquete de EDA de Meridian calcula la correlación de Pearson por pares entre todas las unidades de tratamiento ajustadas y las variables de control ajustadas.
Estado del modelo geográfico
ERROR: En el caso de los modelos geográficos, primero se calcula la correlación por pares en todas las ubicaciones geográficas y todos los períodos. Específicamente, los valores de cada variable en todas las ubicaciones geográficas y todos los períodos se aplanan en un solo array, y se calcula la correlación por pares entre estos arrays aplanados. Se activa un estadoERRORsi un par de variables tienen una correlación casi perfecta en todas las ubicaciones geográficas y todos los períodos (el valor absoluto de su correlación por pares supera el umbral predeterminado de 0.999). Para resolver este problema, quita una de las variables redundantes de los datos de entrada.Puedes recuperar la correlación general por pares del modelo geográfico (calculada en todas las ubicaciones geográficas y todos los períodos) con el siguiente código:
[overall_corr] = mmm_eda.eda_engine.check_geo_pairwise_corr().get_overall_artifacts()
overall_corr.corr_matrix
Estado del modelo a nivel nacional
ERROR: En el caso de los modelos a nivel nacional, la correlación por pares se calcula en todos los períodos, ya que solo hay una ubicación geográfica. Se activa un estadoERRORsi el valor absoluto de la correlación por pares entre un par de variables supera el umbral predeterminado de 0.999. Para resolver este problema, quita una de las variables redundantes de los datos de entrada.Puedes recuperar la correlación por pares calculada para el modelo a nivel nacional con el siguiente código:
[national_corr] = mmm_eda.eda_engine.check_national_pairwise_corr().get_national_artifacts()
national_corr.corr_matrix
Estado del modelo geográfico
ATTENTION: En el caso de los modelos geográficos, la correlación por pares también se calcula a lo largo de todos los períodos para cada ubicación geográfica específica. Se genera un estadoATTENTIONsi un par de variables muestra una correlación casi perfecta dentro de las ubicaciones geográficas individuales, superando el umbral predeterminado de 0.999. Para abordar este problema, verifica los datos o considera combinar estas variables si también muestran una correlación por pares alta en varias ubicaciones geográficas.Puedes recuperar las correlaciones por pares del modelo geográfico para ubicaciones geográficas individuales con el siguiente código:
[geo_corr] = mmm_eda.eda_engine.check_geo_pairwise_corr().get_geo_artifacts()
geo_corr.corr_matrix
Puedes ajustar estos umbrales extremos en caso de ser necesario. Para obtener más detalles sobre cómo establecer estos umbrales, consulta Umbral de correlación por pares personalizado.
Personalizaciones configurables por el usuario
El paquete de EDA de Meridian ofrece varias opciones de configuración para adaptar el proceso de EDA a tus necesidades específicas de modelado y del conjunto de datos.
Método de agregación personalizado del nivel geográfico al nivel nacional
Para realizar un EDA a nivel nacional en un conjunto de datos a nivel geográfico, el paquete de EDA de Meridian agrega internamente los datos sin procesar (sin ajustar) a nivel geográfico al nivel nacional antes de aplicar las transformaciones. Esto garantiza la equivalencia con el caso en el que los usuarios primero deben agregar manualmente su propio conjunto de datos a nivel geográfico al nivel nacional y, luego, pasar esos datos a nivel nacional a Meridian y aplicar el EDA.
De forma predeterminada, todas las unidades de medios sin procesar, las unidades de medios orgánicos sin procesar, el alcance sin procesar y el KPI sin procesar se suman en todas las ubicaciones geográficas. Para agregar la frecuencia, el paquete de EDA de Meridian calcula las impresiones de alcance y frecuencia sin procesar (el alcance multiplicado por la frecuencia) de cada ubicación geográfica, suma las impresiones de alcance y frecuencia y el alcance de todas las ubicaciones geográficas, y divide las impresiones totales de alcance y frecuencia a nivel nacional por el alcance total a nivel nacional. Se aplican cálculos similares cuando se agregan los datos de frecuencia orgánica.
Si bien la agregación de suma predeterminada es adecuada para la mayoría de las variables, puedes definir un método de agregación personalizado para variables de control o tratamientos que no son de medios específicos. Esto es particularmente útil para las variables que son binarias o representan tasas o porcentajes.
Por ejemplo, si deseas obtener el promedio de una variable de control llamada rating en todas las ubicaciones geográficas, haz lo siguiente:
from meridian.model import model
from meridian.model.eda import eda_spec
import numpy as np

mmm_agg_config = eda_spec.AggregationConfig(
    control_variables={'rating': np.mean}
)
mmm_eda_spec = eda_spec.EDASpec(aggregation_config=mmm_agg_config)
mmm = model.Meridian(..., eda_spec=mmm_eda_spec)
Umbral de VIF personalizado
El paquete de EDA de Meridian activa un estado ERROR o ATTENTION para problemas de datos extremos, como la multicolinealidad casi perfecta. Para evitar la inestabilidad numérica y al mismo tiempo mantener la flexibilidad, el paquete usa un umbral predeterminado extremo del VIF de 1,000 en lugar de infinito. Puedes calibrar estos umbrales según el contexto y el criterio de tu empresa:
geo_threshold: Para conjuntos de datos a nivel geográfico. Si el VIF de una variable dentro de una ubicación geográfica específica supera este valor, se activa un estadoATTENTION. Aun así, se puede continuar con el muestreo de distribuciones a posteriori.overall_threshold: Para conjuntos de datos a nivel geográfico. Si el VIF de una variable (calculado en todas las ubicaciones geográficas y todos los períodos) supera este valor, se activa un estadoERROR. Se bloquea el muestreo de distribuciones a posteriori.national_threshold: Para conjuntos de datos a nivel nacional. Si el VIF de una variable supera este valor, se activa un estadoERROR. Se bloquea el muestreo de distribuciones a posteriori.
Por ejemplo, para reducir el overall_threshold de multicolinealidad de 1,000 a 50, haz lo siguiente:
from meridian.model import model
from meridian.model.eda import eda_spec

mmm_custom_vif = eda_spec.VIFSpec(overall_threshold=50)
mmm_eda_spec = eda_spec.EDASpec(vif_spec=mmm_custom_vif)
mmm = model.Meridian(..., eda_spec=mmm_eda_spec)
Umbral de correlación por pares personalizado
También se activa un estado ERROR o ATTENTION para la correlación por pares extrema. El umbral predeterminado de correlación extrema se establece en 0.999. Puedes calibrar estos umbrales según tu conjunto de datos y criterio específicos:
geo_threshold: Para conjuntos de datos a nivel geográfico. Si el valor absoluto de la correlación por pares entre dos variables dentro de una ubicación geográfica específica supera este valor, se activa un estadoATTENTION. Aun así, se puede continuar con el muestreo de distribuciones a posteriori.overall_threshold: Para conjuntos de datos a nivel geográfico. Si el valor absoluto de la correlación por pares (calculado en todas las ubicaciones geográficas y todos los períodos) supera este valor, se activa un estado deERROR. Se bloquea el muestreo de distribuciones a posteriori.national_threshold: Para conjuntos de datos a nivel nacional. Si el valor absoluto de la correlación por pares supera este valor, se activa un estadoERROR. Se bloquea el muestreo de distribuciones a posteriori.
Por ejemplo, para reducir el overall_threshold de la correlación por pares de un modelo geográfico de 0.999 a 0.95, haz lo siguiente:
from meridian.model import model
from meridian.model.eda import eda_spec

mmm_custom_corr = eda_spec.PairwiseCorrSpec(overall_threshold=0.95)
mmm_eda_spec = eda_spec.EDASpec(pairwise_corr_spec=mmm_custom_corr)
mmm = model.Meridian(..., eda_spec=mmm_eda_spec)
Otras personalizaciones
El paquete de EDA de Meridian permite otros umbrales personalizables en el EDASpec.
Estos valores predeterminados sirven como límites internos para lo que el paquete considera variables constantes. Rara vez es necesario ajustar estos valores predeterminados, pero están disponibles para tus propios casos límite específicos.
Personalizar el
KpiInvariabilitySpec: Como se describe en Falta de variación crítica, el paquete de EDA de Meridian activa unERRORy bloquea el muestreo de la distribución a posteriori cuando el KPI transformado tiene una desviación estándar general inferior al umbral predeterminado de 1e-4. Puedes usar elKpiInvariabilitySpecpara ajustar elstd_thresholdque determina cuándo un KPI de baja variabilidad activa esteERROR.Por ejemplo, para reducir este
std_thresholden elKpiInvariabilitySpeca 1e-5, haz lo siguiente:from meridian.model import model from meridian.model.eda import eda_spec custom_kpi_spec = eda_spec.KpiInvariabilitySpec(std_threshold=1e-5) mmm_eda_spec = eda_spec.EDASpec(kpi_invariability_spec=custom_kpi_spec) mmm = model.Meridian(..., eda_spec=mmm_eda_spec)Personalizar el
StandardDeviationSpec: Como se detalla en Valores atípicos y posible dispersión de los datos, las variables con una desviación estándar extremadamente baja (calculada después de quitar los valores atípicos) indican una posible dispersión de los datos o una falta de señal. Puedes usar elStandardDeviationSpecpara ajustar los umbrales que determinan cuándo estas variables de baja variabilidad activan una alerta deATTENTION.Por ejemplo, para reducir el umbral de desviación estándar a 1e-5 para un modelo geográfico, ajusta el
geo_std_threshold:from meridian.model import model from meridian.model.eda import eda_spec custom_std_spec = eda_spec.StandardDeviationSpec(geo_std_threshold=1e-5) mmm_eda_spec = eda_spec.EDASpec(std_spec=custom_std_spec) mmm = model.Meridian(..., eda_spec=mmm_eda_spec)En el caso de un modelo nacional, ajusta el
national_std_threshold.Filtrar variables constantes de los cálculos del VIF: Las variables casi constantes pueden causar errores de cálculo durante los cálculos del factor de inflación de varianza (VIF). De forma predeterminada, cualquier variable con una desviación estándar inferior a 1e-4 se excluye de los cálculos del VIF. Puedes ajustar este límite con el parámetro
std_thresholdenVIFSpec. Por ejemplo, para aumentar este umbral a 1e-3, haz lo siguiente:from meridian.model import model from meridian.model.eda import eda_spec custom_vif_std = eda_spec.VIFSpec(std_threshold=1e-3) mmm_eda_spec = eda_spec.EDASpec(vif_spec=custom_vif_std) mmm = model.Meridian(..., eda_spec=mmm_eda_spec)