

Lavorare con i dati nell'API Google Health è essenzialmente un ciclo di sincronizzazione dei dati tra il datastore dell'API Google Health nel cloud e la tua app o il tuo datastore di backend. Tuttavia, questo ciclo può assumere forme diverse a seconda di una serie di fattori:
- Stai scrivendo dati nell'API Google Health? Solo lettura? O entrambe le cose?
- Il datastore è locale sull'app o sul dispositivo? O nel tuo cloud?
- Devi sincronizzare i dati dell'API Google Health tra l'app dell'utente e un dispositivo indossabile? Con quale frequenza sincronizzi i dispositivi?
- Con quali tipi di dati lavori? Conteggi di base? Unità di misura? Serie con diverse frequenze di campionamento?
- Hai intenzione di leggere i dati mentre la tua app è in background?
- Intendi utilizzare i dati storici registrati prima che la tua app riceva le autorizzazioni utente?
Per capire come si combinano tutti questi elementi, dai un'occhiata al ciclo di vita della sincronizzazione dell'API Google Health. Esistono due versioni di questo ciclo di vita: standard (lettura e scrittura) e di sola lettura.
Il ciclo di vita della sincronizzazione standard
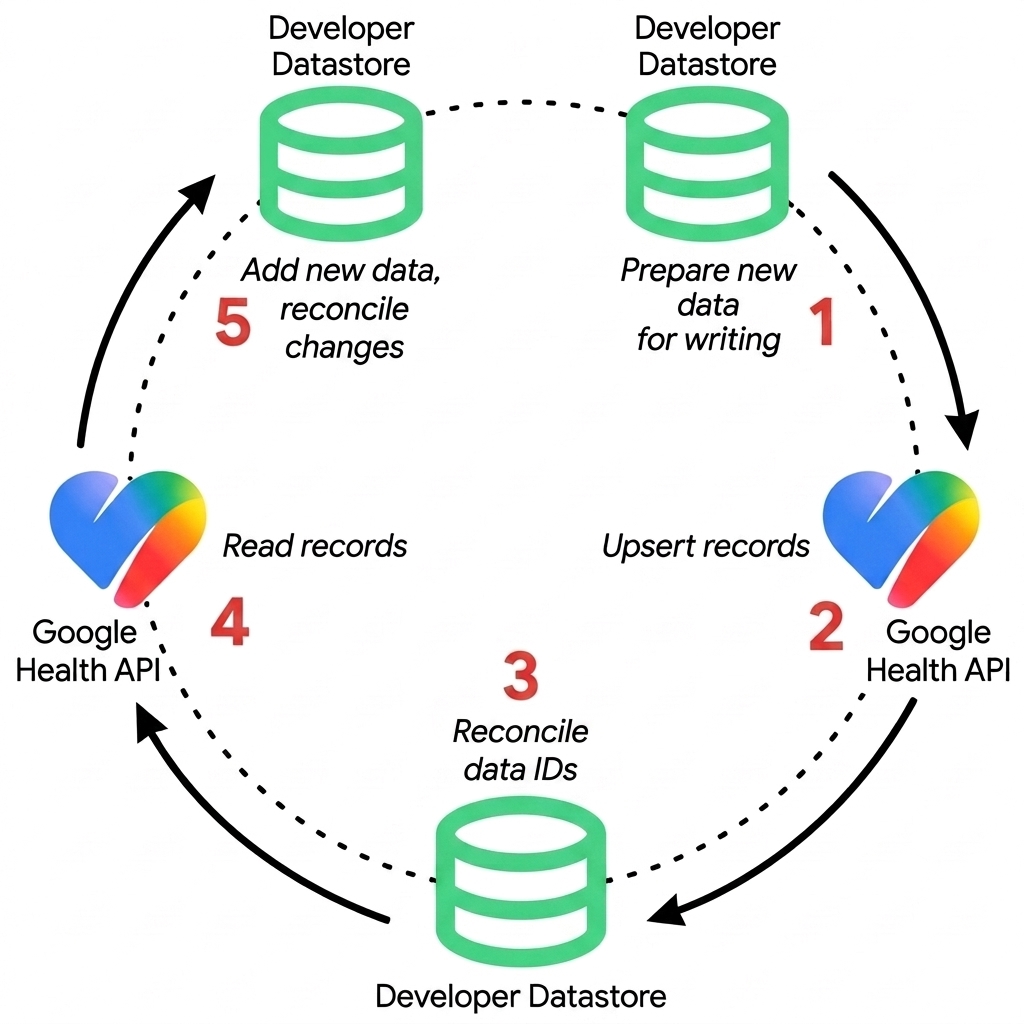
L'integrazione con l'API Google Health comporta la copia dei dati in un'app o in un datastore di backend. Per facilità d'uso in questa documentazione, chiameremo questo datastore datastore per sviluppatori.
"Copia" può sostituire qualsiasi attività discreta, ad esempio la lettura dall'API Google Health (copia nell'archivio dati dello sviluppatore) o la scrittura nell'API Google Health (copia nell'API Google Health). L'esecuzione ripetuta di queste azioni in un ordine specifico costituisce il ciclo di vita della sincronizzazione.
La Figura 1 illustra il ciclo di vita della sincronizzazione standard che prevede operazioni di lettura e scrittura, senza tenere conto di nessuno dei fattori menzionati in precedenza.
Scrittura
- Prepara i nuovi dati per la scrittura: trasferisci i dati da un dispositivo o un'app esterni e formatta i punti dati in rappresentazioni JSON compatibili con i tipi di dati dell'API Google Health. Tieni presente che al momento gli ID personalizzati assegnati dal cliente per le scritture
non sono supportati nell'API Health. Questi ID possono essere forniti in un
POST, ma vengono ignorati. - Applicare l'upsert ai record: invia punti dati all'API Google Health utilizzando
endpoint REST. Utilizza
POSTper creare record ePATCHper inserire e aggiornare i record esistenti. Gli ID necessari per l'operazionePATCHprovengono da un'operazionePOSTprecedente (il passaggio successivo di un ciclo precedente). - Elabora gli ID risorsa restituiti: quando utilizzi gli ID generati dal server, estrai
e rendi persistente la risorsa
nameo l'ID restituito dal server nel datastore dello sviluppatore per consentire aggiornamenti (PATCH) o eliminazioni (DELETE) futuri. Per ulteriori informazioni sui due tipi, consulta Strategie di identificazione.
Lettura
- Leggi record: recupera nuovi dati e modifiche ai dati esistenti nell'API Google Health utilizzando endpoint REST (
GETcon parametri di queryfiltere paginazionepageTokeno endpoint di aggregazione comerollUpedailyRollUp) o ricevi notifiche in tempo reale utilizzando gli abbonamenti webhook (projects.subscribers). Una notifica indica solo che sono disponibili nuovi dati, non quali sono i dati effettivi. - Riconcilia l'archivio dati dello sviluppatore: riconcilia i dati nuovi e aggiornati con l'archivio dati dello sviluppatore. I dispositivi connessi possono produrre intervalli sovrapposti durante le sincronizzazioni. Per scoprire come vengono risolti dall'API Google Health, consulta Timestamp degli intervalli e sincronizzazione dei dispositivi connessi.
Questo ciclo si ripete a intervalli appropriati in base alle esigenze specifiche di app o dispositivi esterni. Questo è in genere l'ordine che consigliamo per sincronizzare i dati tra il tuo datastore e l'API Google Health.
Strategie di identificazione
Se intendi scrivere dati nell'API Google Health, prima di creare l'integrazione con le API Google Health, devi scegliere una strategia di identificazione delle risorse durante la creazione dei punti dati (l'unità di base dei dati).
Al momento, gli ID assegnati dal client per le scritture non sono supportati nell'API Health.
Questi ID possono essere forniti in un POST, ma vengono ignorati. I dettagli di questa
opzione sono forniti qui a scopo informativo.
- ID generati dal server (opzione predefinita): il client invia i dati senza un ID e il backend dell'API Google Health genera e restituisce un identificatore di sistema univoco.
- ID personalizzati assegnati dal client (per AIP-133, non ancora supportati): L'app client genera un identificatore univoco (ad esempio un UUID o una chiave primaria del database locale) e lo fornisce nel percorso della risorsa al momento della creazione.
La tabella seguente mette a confronto entrambe le strategie di identificazione per aiutarti a scegliere l'approccio giusto per la tua integrazione:
| Funzionalità | ID generati dal server | ID personalizzati assegnati dal cliente |
|---|---|---|
| Generazione di ID | Il server genera un ID sistema casuale durante l'esecuzione di POST. |
Il client genera l'ID stabile localmente (UUID v4 / chiave primaria interna) prima della scrittura. |
| Percorso risorsa | .../dataPoints/{server_id} (restituito nella risposta) |
.../dataPoints/{custom_id} |
| Passaggio Post-Write Local | Obbligatorio. Deve archiviare server_id restituito nel DB locale per consentire aggiornamenti/eliminazioni futuri. |
Nessuno. L'app è già proprietaria dell'ID. |
| Tabella di mappatura degli ID | Obbligatorio. Il cliente deve mantenere una mappatura bidirezionale
(local_id ↔ server_id). |
Non è necessario. Il client utilizza direttamente la propria chiave primaria. |
| Comportamento di riprova (rete debole) | Rischio di duplicati. Se riprovi a eseguire un'operazione POST
che ha raggiunto il timeout, viene creato un record duplicato con un nuovo ID server. |
Sicuro e idempotente. Il nuovo tentativo di POST con lo stesso
custom_id impedisce la creazione di duplicati (restituisce 409
ALREADY_EXISTS). |
| Supporto della sincronizzazione offline | Limitata. Devi attendere la risposta del server per ottenere gli ID risorsa ufficiali prima di farvi riferimento. | Full. Le entità possono essere create e modificate offline con ID stabili, quindi sincronizzate senza problemi una volta ristabilita la connessione. |
| Vincoli di formato | Gestito interamente dal server. | Deve seguire ^[a-z0-9-]{4,63}$ (4-63 caratteri alfanumerici
minuscoli e trattini). |
| Quando scegliere |
Scegli gli ID generati dal server se:
|
Scegli ID personalizzati se:
|
Ciclo di vita della sincronizzazione di sola lettura
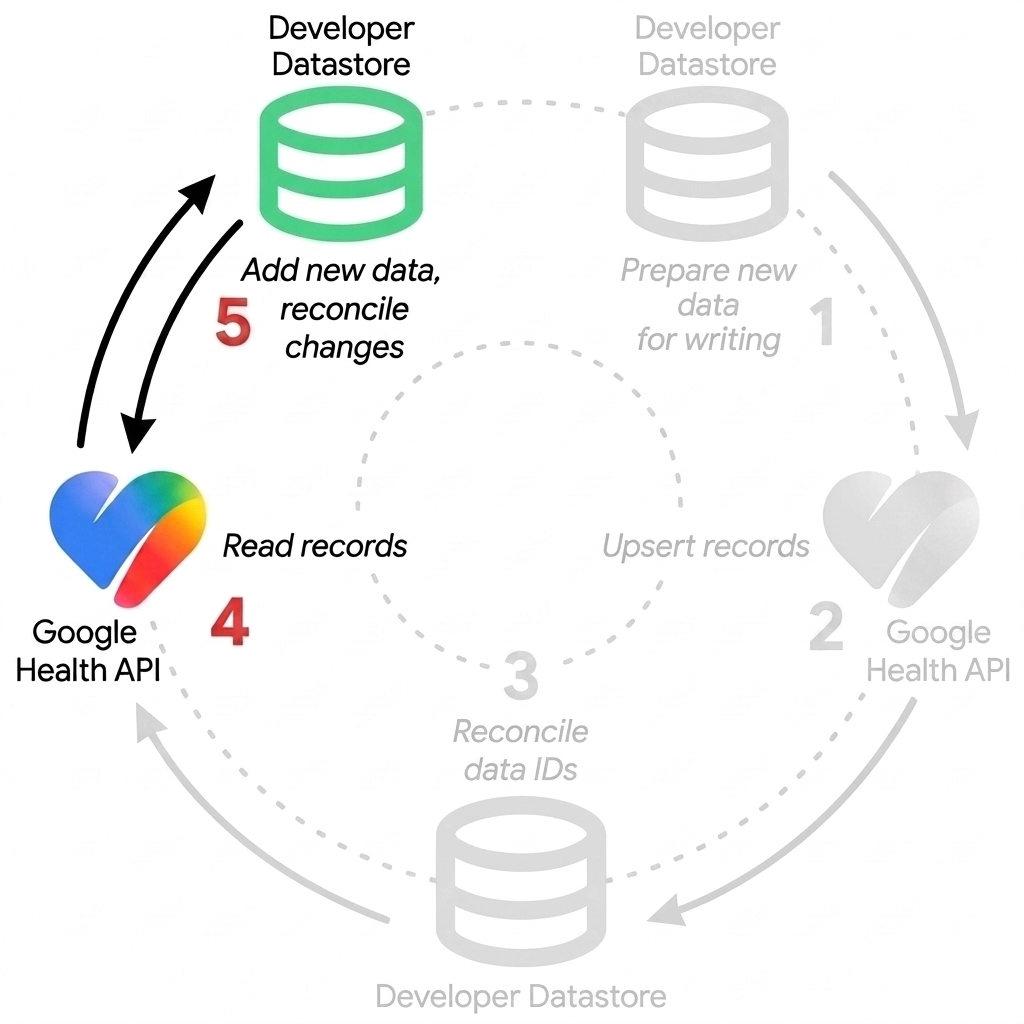
Un'app che intende leggere solo dall'API Google Health deve copiare i dati nel proprio datastore per sviluppatori e gestire la parte di riconciliazione del ciclo di vita.
Qui si applicano le stesse attività trattate nella sezione Lettura.
La figura 2 illustra il ciclo di vita di sola lettura.
Timestamp degli intervalli e sincronizzazione dei dispositivi connessi
I dati a intervalli rappresentano le misurazioni raccolte in un determinato periodo di tempo, ad esempio passi, battito cardiaco o sessioni di allenamento. Al contrario, le misurazioni istantanee includono voci manuali come un registro alimentare o una lettura della bilancia. I dati dell'intervallo in genere provengono dalla sincronizzazione di dispositivi connessi, come smartwatch e fitness tracker.
I timestamp dell'intervallo (startTime e endTime nei payload JSON REST oppure
start_time e end_time nelle espressioni di filtro e in gRPC) introducono comportamenti
unici quando si lavora con i dati dell'intervallo. Questa sezione spiega perché si verificano intervalli
sovrapposti e confronta gli endpoint list e reconcile.
Intervalli sovrapposti dai dispositivi connessi
I dispositivi connessi come i tracker Fitbit e Google Pixel Watch raccolgono continuamente letture biometriche ad alta frequenza quando vengono indossati. Dopo che un dispositivo sincronizza i punti dati con Google Health, non modifica retroattivamente i record esistenti. I timestamp degli intervalli archiviati rimangono invariati.
Tuttavia, prima dei cicli di sincronizzazione successivi, gli algoritmi sul dispositivo spesso reinterpretano la telemetria dei sensori non elaborata. Il dispositivo raggruppa nuovamente le letture raccolte nelle ore precedenti. Quando il dispositivo si sincronizza di nuovo, carica nuovi punti dati. I relativi limiti di inizio e fine possono sovrapporsi a intervalli memorizzati in precedenza.
Ad esempio, considera un utente che indossa uno smartwatch i cui dati delle attività vengono sincronizzati in due batch consecutivi:
- Durante la prima sincronizzazione, il dispositivo carica un punto dati che copre il periodo dal giorno
10:00:00Zal giorno10:14:59Z. - Dopo il ricalcolo sul dispositivo, una seconda sincronizzazione carica un altro punto dati
che copre il periodo dal giorno
10:14:00Zal giorno10:28:59Z.
Entrambi i record vengono archiviati in modo indipendente nel backend di Google Health. Di conseguenza, entrambi i punti dati coprono l'intervallo da 10:14:00Z a 10:14:59Z.
In questo modo si produce una sovrapposizione di 59 secondi durante l'esecuzione di query sui record non elaborati.
Confrontare l'elenco e riconciliare gli endpoint
Puoi gestire questi intervalli sovrapposti utilizzando l'endpoint list o
reconcile. Scegli l'endpoint che corrisponde ai requisiti della tua applicazione:
| Funzionalità | list endpoint |
reconcile endpoint |
|---|---|---|
| Metodo HTTP | GET https://health.googleapis.com/v4/users/me/dataTypes/dataType/dataPoints |
GET https://health.googleapis.com/v4/users/me/dataTypes/dataType/dataPoints:reconcile |
| Comportamento di sovrapposizione | Restituisce tutti i record archiviati come caricati senza deduplicazione. Quando gli intervalli si sovrappongono, vengono restituiti entrambi i record. | Risolve i conflitti ed elimina i duplicati dei record sovrapposti tra dispositivi e sessioni di sincronizzazione in un unico flusso continuo. |
| Vantaggi | Fornisce una traccia di audit completa e non modificata di ogni record caricato da ciascun dispositivo e batch di sincronizzazione. | Semplifica il rendering della sequenza temporale e i calcoli della durata gestendo automaticamente gli intervalli sovrapposti e i conflitti tra più dispositivi. |
| Svantaggi | La tua applicazione è responsabile del rilevamento e della risoluzione di intervalli sovrapposti, conflitti multi-dispositivo e periodi in cui il dispositivo non è indossato. | I record sovrapposti subordinati vengono omessi dalla risposta, pertanto i singoli batch di sincronizzazione dei dispositivi non possono essere controllati in isolamento. |
L'endpoint reconcile è progettato per disegnare interfacce utente, eseguire il rendering
delle cronologie delle attività e calcolare i totali delle durate non sovrapposte. Risolve
gli intervalli in conflitto delle sessioni di sincronizzazione riclassificate. Inoltre, riconcilia
l'attività registrata contemporaneamente su più dispositivi, come uno smartwatch e uno
smartphone.
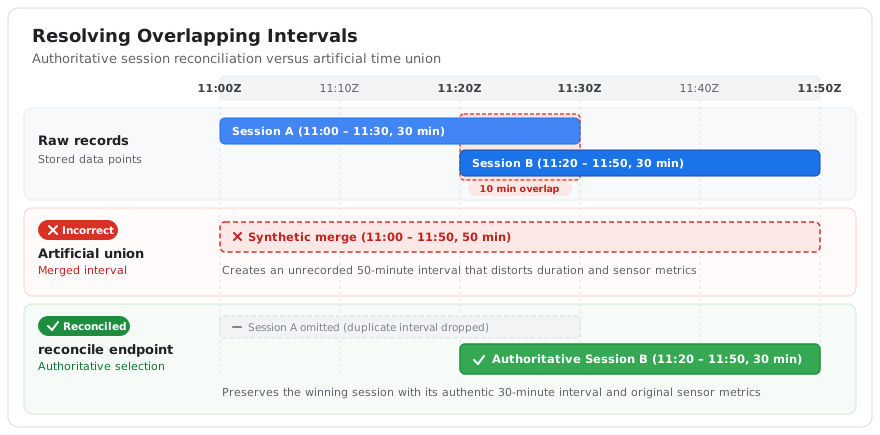
La riconciliazione risolve le sessioni in conflitto selezionando il record autorevole
anziché sintetizzare un'unione temporale artificiale. Ad esempio, non unisce 11:00:00Z a 11:30:00Z e 11:20:00Z a 11:50:00Z in 11:00:00Z a 11:50:00Z. La risposta riconciliata restituisce il punto dati vincente
con l'intervallo registrato originale. In questo modo, viene preservata l'integrità
delle metriche e della telemetria misurate della sessione.
La Figura 3 illustra come l'endpoint reconcile gestisce le sessioni sovrapposte.
Seleziona il record autorevole anziché creare un'unione artificiale di orari.
La guida agli endpoint fornisce esempi completi di richieste e risposte. Per confrontare
i record list non elaborati con l'output reconcile, vedi
Ottenere una visualizzazione riconciliata dei dati sugli intervalli.
L'endpoint list è progettato per la diagnostica dei dispositivi e i controlli dei dati. Utilizzalo
quando il tuo workflow richiede l'ispezione dei record non modificati caricati da ogni
dispositivo. Quando esegui query con list, la logica del client deve gestire eventuali sovrapposizioni di intervalli nei dati non elaborati.
Modificabilità del timestamp e aggiornamenti del proprietario
I dispositivi connessi non modificano retroattivamente i timestamp archiviati durante i normali
cicli di sincronizzazione. Tuttavia, i timestamp dell'intervallo (startTime e endTime nei payload JSON REST o start_time e end_time nelle espressioni di filtro e in gRPC) non sono universalmente immutabili in tutte le origini dati. Solo il creatore o il proprietario originale di un record può modificarne i campi. Altre applicazioni non possono
modificare i punti dati che non hanno creato.
Un'applicazione proprietaria può utilizzare l'endpoint patch per aggiornare i record esistenti. Ciò include la modifica dei timestamp di inizio o fine,
che aggiorna sia i campi UTC (startTime e endTime) sia quelli dell'ora civile
(civilStartTime e civilEndTime) sul server. Per un esempio di
aggiornamento dei timestamp con PATCH, consulta
Aggiorna i timestamp degli intervalli per i dati esistenti
nella guida di Endpoints.
Allo stesso modo, i punti dati sincronizzati da piattaforme esterne come Health Connect o app partner ereditano gli aggiornamenti dall'origine. Se Health Connect riceve successivamente un aggiornamento per un record sincronizzato dall'app di terze parti originale, queste modifiche vengono propagate e sovrascrivono il record esistente.