

Praca z danymi w interfejsie Google Health API to przede wszystkim cykl synchronizacji danych między magazynem danych interfejsu Google Health API w chmurze a Twoją aplikacją lub magazynem danych backendu. Ten cykl może jednak przybierać różne formy w zależności od wielu czynników:
- Czy zapisujesz dane w interfejsie Google Health API? Tylko czytasz? A może jedno i drugie?
- Czy magazyn danych jest lokalny w aplikacji lub na urządzeniu? A może w Twojej własnej chmurze?
- Czy musisz synchronizować dane z interfejsu Google Health API między aplikacją użytkownika a urządzeniem do noszenia? Jak często synchronizujesz urządzenia?
- Jakich typów danych używasz? Podstawowe liczby? Jednostki miary? serii o różnych częstotliwościach próbkowania?
- Czy planujesz odczytywać dane, gdy aplikacja działa w tle?
- Czy planujesz korzystać z danych historycznych zarejestrowanych przed uzyskaniem przez aplikację uprawnień użytkownika?
Aby dowiedzieć się, jak to wszystko działa, zapoznaj się z cyklem synchronizacji interfejsu Google Health API. Ten cykl życia ma 2 wersje: standardową (odczyt i zapis) oraz tylko do odczytu.
Standardowy cykl życia synchronizacji

Integracja z interfejsem API Google Health oznacza kopiowanie danych do aplikacji lub magazynu danych backendu. W tej dokumentacji dla ułatwienia będziemy nazywać ten magazyn danych magazynem danych dewelopera.
„Kopiowanie” może tu oznaczać dowolną odrębną aktywność, np. odczytywanie danych z interfejsu Google Health API (kopiowanie do magazynu danych dewelopera) lub zapisywanie danych w interfejsie Google Health API (kopiowanie do interfejsu Google Health API). Wykonywanie tych działań w określonej kolejności to cykl synchronizacji.
Rysunek 1 przedstawia standardowy cykl życia synchronizacji, który obejmuje operacje odczytu i zapisu bez uwzględniania żadnego z wcześniej wymienionych czynników.
Zapis
- Przygotowywanie nowych danych do zapisu – przesyłanie danych z urządzenia zewnętrznego lub aplikacji i formatowanie punktów danych w postaci reprezentacji JSON zgodnych z typami danych interfejsu Google Health API. Pamiętaj, że niestandardowe identyfikatory przypisane przez klienta do operacji zapisu nie są obecnie obsługiwane w interfejsie Health API. Takie identyfikatory mogą być podane w
POST, ale są ignorowane. - Wstawianie rekordów przez upsert – przesyłanie punktów danych do interfejsu API Google Health za pomocą punktów końcowych REST. Używaj
POSTdo tworzenia rekordów, aPATCHdo wstawiania i aktualizowania istniejących rekordów. Identyfikatory potrzebne do operacjiPATCHpochodzą z poprzedniej operacjiPOST(następny krok w poprzednim cyklu). - Przetwarzaj zwrócone identyfikatory zasobów – jeśli używasz identyfikatorów generowanych przez serwer, wyodrębnij i zapisz zwrócony przez serwer zasób
namelub identyfikator w pamięci danych dewelopera, aby umożliwić przyszłe aktualizacje (PATCH) lub usunięcia (DELETE). Więcej informacji o tych 2 typach znajdziesz w sekcji Strategie identyfikacji.
Odczyt
- Odczytywanie rekordów – pobieranie nowych danych i zmian w danych w interfejsie Google Health API za pomocą punktów końcowych REST (
GETzfilterparametrami zapytania ipageTokenstronicowaniem lub punktów końcowych agregacji, takich jakrollUpidailyRollUp) lub otrzymywanie powiadomień w czasie rzeczywistym za pomocą subskrypcji Webhook (projects.subscribers). Powiadomienie informuje tylko o tym, że dostępne są nowe dane, a nie o tym, jakie to dane. - Uzgodnij magazyn danych dewelopera – uzgodnij nowe i zaktualizowane dane z magazynem danych dewelopera. Podczas synchronizacji połączone urządzenia mogą generować nakładające się interwały. Aby dowiedzieć się, jak interfejs Google Health API rozwiązuje te problemy, przeczytaj artykuł Znaczniki czasu interwałów i synchronizacja połączonych urządzeń.
Ten cykl powtarza się w odpowiednich odstępach czasu w zależności od konkretnych potrzeb urządzeń zewnętrznych lub aplikacji. Zalecamy synchronizowanie danych między własnym magazynem danych a interfejsem Google Health API w tej kolejności.
Strategie identyfikacji
Jeśli zamierzasz zapisywać dane w interfejsie Google Health API, przed utworzeniem integracji z interfejsami Google Health API musisz wybrać strategię identyfikacji zasobów podczas tworzenia punktów danych (podstawowej jednostki danych).
Identyfikatory przypisane przez klienta do operacji zapisu nie są obecnie obsługiwane w interfejsie Health API.
Takie identyfikatory mogą być podane w POST, ale są ignorowane. Szczegóły tej opcji podajemy tutaj w celach informacyjnych.
- Identyfikatory generowane przez serwer (opcja domyślna): klient przesyła dane bez identyfikatora, a backend interfejsu Google Health API generuje i zwraca unikalny identyfikator systemowy.
- Identyfikatory niestandardowe przypisane przez klienta (zgodnie z AIP-133, jeszcze nieobsługiwane): aplikacja kliencka generuje unikalny identyfikator (np. UUID lub klucz podstawowy lokalnej bazy danych) i podaje go w ścieżce zasobu podczas tworzenia.
W tabeli poniżej znajdziesz porównanie obu strategii identyfikacji, które pomoże Ci wybrać odpowiednie podejście do integracji:
| Funkcja | Identyfikatory generowane przez serwer | Niestandardowe identyfikatory przypisane przez klienta |
|---|---|---|
| Generowanie identyfikatorów | Serwer generuje losowy identyfikator systemu podczas POSTwykonywania. |
Klient generuje lokalnie stabilny identyfikator (UUID w wersji 4 / wewnętrzny klucz podstawowy) przed zapisem. |
| Ścieżka zasobu | .../dataPoints/{server_id} (zwrócony w odpowiedzi) |
.../dataPoints/{custom_id} |
| Post-Write Local Step | Parametr wymagany. Musi przechowywać zwrócone server_id w lokalnej bazie danych, aby umożliwić przyszłe aktualizacje i usuwanie. |
Brak. Aplikacja jest już właścicielem identyfikatora. |
| Tabela mapowania identyfikatorów | Parametr wymagany. Klient musi utrzymywać dwukierunkowe mapowanie (local_id ↔ server_id). |
Niepotrzebne. Klient używa bezpośrednio własnego klucza podstawowego. |
| Działanie ponawiania (słaba sieć) | Ryzyko duplikatów. Ponowne wysłanie żądania, które przekroczyło limit czasu POST
, spowoduje utworzenie zduplikowanego rekordu z nowym identyfikatorem serwera. |
Bezpieczne i idempotentne. Ponowna próba POST z tym samym custom_id zapobiega tworzeniu duplikatów (zwraca 409
ALREADY_EXISTS). |
| Obsługa synchronizacji offline | Ograniczone. Przed odwołaniem się do oficjalnych identyfikatorów zasobów musisz poczekać na odpowiedź serwera. | Pełny Encje można tworzyć i zmieniać offline za pomocą stabilnych identyfikatorów, a następnie bezproblemowo synchronizować po ponownym połączeniu. |
| Ograniczenia dotyczące formatu | W całości obsługiwane przez serwer. | Musi być zgodny z wartością ^[a-z0-9-]{4,63}$ (4–63 małe litery alfanumeryczne i łączniki). |
| Kiedy wybrać |
Wybierz identyfikatory generowane przez serwer, jeśli:
|
Wybierz identyfikatory niestandardowe, jeśli:
|
Cykl życia synchronizacji tylko do odczytu

Aplikacja, która ma tylko odczytywać dane z interfejsu Google Health API, musi skopiować dane do pamięci danych dewelopera i obsługiwać część cyklu życia związaną z uzgadnianiem.
Obowiązują tu te same zadania, które zostały opisane w sekcji Czytanie.
Rysunek 2 przedstawia cykl życia tylko do odczytu.
Znaczniki czasu interwałów i synchronizacja połączonych urządzeń
Dane interwałowe to pomiary zbierane w określonym czasie, np. liczba kroków, tętno lub sesje ćwiczeń. Z kolei pomiary punktowe obejmują dane wprowadzane ręcznie, takie jak dziennik żywieniowy czy odczyt wagi. Dane interwałowe pochodzą zwykle z synchronizacji połączonych urządzeń, takich jak smartwatche i trackery fitness.
Sygnatury czasowe przedziałów (startTime i endTime w ładunkach JSON REST lub start_time i end_time w wyrażeniach filtrów i gRPC) wprowadzają unikalne zachowania podczas pracy z danymi przedziałowymi. W tej sekcji wyjaśniamy, dlaczego występują nakładające się przedziały, i porównujemy punkty końcowe list i reconcile.
Nakładające się interwały z połączonych urządzeń
Połączone urządzenia, takie jak trackery Fitbit i zegarki Google Pixel Watch, stale zbierają dane biometryczne o wysokiej częstotliwości, gdy są noszone. Po zsynchronizowaniu danych z Google Health urządzenie nie zmienia wstecznie istniejących rekordów. Przechowywane sygnatury czasowe interwałów pozostają bez zmian.
Jednak przed kolejnymi cyklami synchronizacji algorytmy na urządzeniu często ponownie interpretują surowe dane telemetryczne z czujników. Urządzenie ponownie przypisuje odczyty zebrane w ciągu poprzednich godzin. Gdy urządzenie ponownie się zsynchronizuje, prześle nowe punkty danych. Granice początku i końca mogą się pokrywać z wcześniej zapisanymi przedziałami.
Rozważmy na przykład użytkownika, który nosi zegarek, a dane o jego aktywności są synchronizowane w 2 kolejnych partiach:
- Podczas pierwszej synchronizacji urządzenie przesyła punkt danych obejmujący okres od
10:00:00Zdo10:14:59Z. - Po ponownym obliczeniu na urządzeniu druga synchronizacja przesyła kolejny punkt danych obejmujący okres od
10:14:00Zdo10:28:59Z.
Oba rekordy są przechowywane niezależnie w backendzie Google Health. W rezultacie oba punkty danych obejmują przedział od 10:14:00Z do 10:14:59Z.
Podczas wysyłania zapytań dotyczących nieprzetworzonych rekordów powoduje to 59-sekundowe nakładanie się.
Porównywanie listy i uzgadnianie punktów końcowych
Nakładające się interwały możesz obsługiwać za pomocą punktu końcowego list lub reconcile. Wybierz punkt końcowy, który odpowiada wymaganiom Twojej aplikacji:
| Funkcja | list punkt końcowy |
reconcile punkt końcowy |
|---|---|---|
| Metoda HTTP | GET https://health.googleapis.com/v4/users/me/dataTypes/dataType/dataPoints |
GET https://health.googleapis.com/v4/users/me/dataTypes/dataType/dataPoints:reconcile |
| Zachowanie nakładania się | Zwraca wszystkie zapisane rekordy jako przesłane bez deduplikacji. Jeśli przedziały się nakładają, zwracane są oba rekordy. | Rozwiązuje konflikty i usuwa zduplikowane nakładające się rekordy z różnych urządzeń i sesji synchronizacji, tworząc jeden ciągły strumień. |
| Zalety | Zawiera pełny, niezmodyfikowany rejestr kontrolny każdego rekordu przesłanego przez poszczególne urządzenia i pakiety synchronizacji. | Upraszcza renderowanie osi czasu i obliczanie czasu trwania, automatycznie obsługując nakładające się przedziały i konflikty na wielu urządzeniach. |
| Wady | Twoja aplikacja odpowiada za wykrywanie i rozwiązywanie problemów z nakładającymi się interwałami, konfliktami między urządzeniami i okresami, w których urządzenie nie jest noszone na nadgarstku. | Podrzędne nakładające się rekordy są pomijane w odpowiedzi, więc poszczególnych partii synchronizacji urządzeń nie można sprawdzać oddzielnie. |
Punkt końcowy reconcile służy do rysowania interfejsów użytkownika, renderowania osi czasu aktywności i obliczania sum niepokrywających się okresów. Rozwiązuje konflikty interwałów z sesji synchronizacji po ponownym podziale na przedziały. Uzgadnia też aktywność rejestrowaną jednocześnie na kilku urządzeniach, np. zegarku i telefonie.
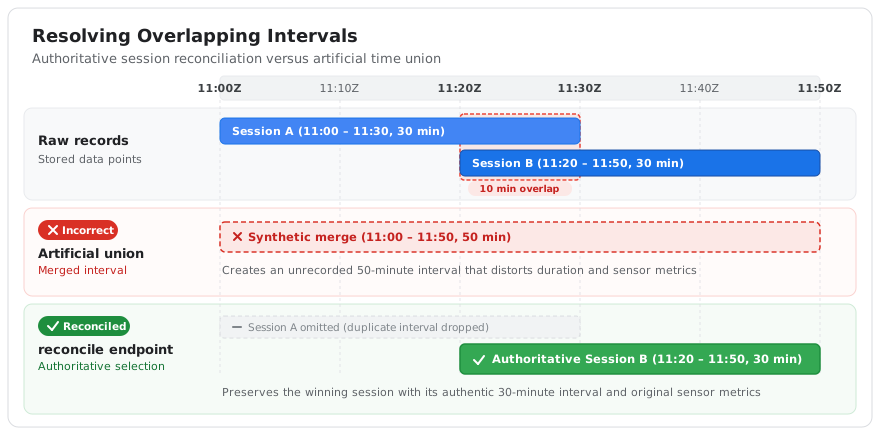
Proces uzgadniania rozwiązuje konflikty między sesjami, wybierając wiarygodny rekord zamiast tworzyć sztuczne połączenie czasowe. Na przykład nie łączy zakresów 11:00:00Z–11:30:00Z i 11:20:00Z–11:50:00Z w zakres 11:00:00Z–11:50:00Z. W uzgodnionej odpowiedzi zwracany jest zwycięski punkt danych z pierwotnym zarejestrowanym przedziałem. Dzięki temu zachowasz integralność danych telemetrycznych i rodzajów danych pomiarowych z tej sesji.
Ilustracja 3 pokazuje, jak punkt końcowy reconcile obsługuje nakładające się sesje.
Wybiera on rekord autorytatywny, zamiast tworzyć sztuczne połączenie czasowe.
W przewodniku po punktach końcowych znajdziesz pełne przykłady żądań i odpowiedzi. Aby porównać surowe rekordy list z danymi wyjściowymi reconcile, zapoznaj się z artykułem Uzyskiwanie uzgodnionego widoku danych interwałowych.
Punkt końcowy list jest przeznaczony do diagnostyki urządzeń i kontroli danych. Używaj go, gdy w procesie pracy musisz sprawdzać niezmienione rekordy przesłane przez poszczególne urządzenia. Podczas wysyłania zapytań za pomocą funkcji list logika klienta musi obsługiwać wszelkie nakładające się na siebie przedziały w danych pierwotnych.
Zmienność sygnatury czasowej i aktualizacje właściciela
Podczas normalnych cykli synchronizacji połączone urządzenia nie modyfikują wstecznie zapisanych sygnatur czasowych. Jednak sygnatury czasowe interwałów (startTime i endTime w ładunkach JSON REST lub start_time i end_time w wyrażeniach filtrów i gRPC) nie są niezmienne we wszystkich źródłach danych. Pola rekordu może modyfikować tylko jego pierwotny twórca lub właściciel. Inne aplikacje nie mogą edytować punktów danych, których nie utworzyły.
Aplikacja będąca właścicielem może używać patch punktu końcowego do aktualizowania istniejących rekordów. Obejmuje to modyfikowanie sygnatur czasowych rozpoczęcia i zakończenia, co powoduje aktualizację pól czasu UTC (startTime i endTime) oraz czasu cywilnego (civilStartTime i civilEndTime) na serwerze. Przykład aktualizowania sygnatur czasowych za pomocą metody PATCH znajdziesz w artykule Aktualizowanie sygnatur czasowych interwałów w przypadku istniejących danych w przewodniku po punktach końcowych.
Podobnie punkty danych zsynchronizowane z platform zewnętrznych, takich jak Health Connect czy aplikacje partnerów, dziedziczą aktualizacje ze źródła. Jeśli Health Connect otrzyma później aktualizację zsynchronizowanego rekordu z pierwotnej aplikacji innej firmy, zmiany te zostaną rozpowszechnione i zastąpią istniejący rekord.