

Về cơ bản, việc xử lý dữ liệu trong Google Health API là một chu trình đồng bộ hoá dữ liệu giữa kho dữ liệu Google Health API trên đám mây và kho dữ liệu ứng dụng hoặc phụ trợ của riêng bạn. Tuy nhiên, chu kỳ này có thể có nhiều hình thức tuỳ thuộc vào nhiều yếu tố:
- Bạn có đang ghi dữ liệu vào Google Health API không? Chỉ đọc? Hay làm cả hai?
- Kho dữ liệu của bạn có phải là kho dữ liệu cục bộ trên ứng dụng hoặc thiết bị không? Hoặc trong đám mây của riêng bạn?
- Bạn có cần đồng bộ hoá dữ liệu Google Health API giữa ứng dụng của người dùng và một thiết bị đeo không? Bạn đồng bộ hoá thiết bị bao lâu một lần?
- Bạn đang làm việc với những loại dữ liệu nào? Số lượt cơ bản? Đơn vị đo lường? Loạt dữ liệu có tốc độ lấy mẫu khác nhau?
- Bạn có dự định đọc dữ liệu trong khi ứng dụng của bạn đang chạy ở chế độ nền không?
- Bạn có dự định xử lý dữ liệu trong quá khứ được ghi lại trước khi ứng dụng của bạn nhận được quyền của người dùng không?
Để hiểu cách tất cả những điều này kết hợp với nhau, hãy xem vòng đời đồng bộ hoá của Google Health API. Có hai phiên bản của vòng đời này: tiêu chuẩn (đọc và ghi) và chỉ đọc.
Vòng đời đồng bộ hoá tiêu chuẩn
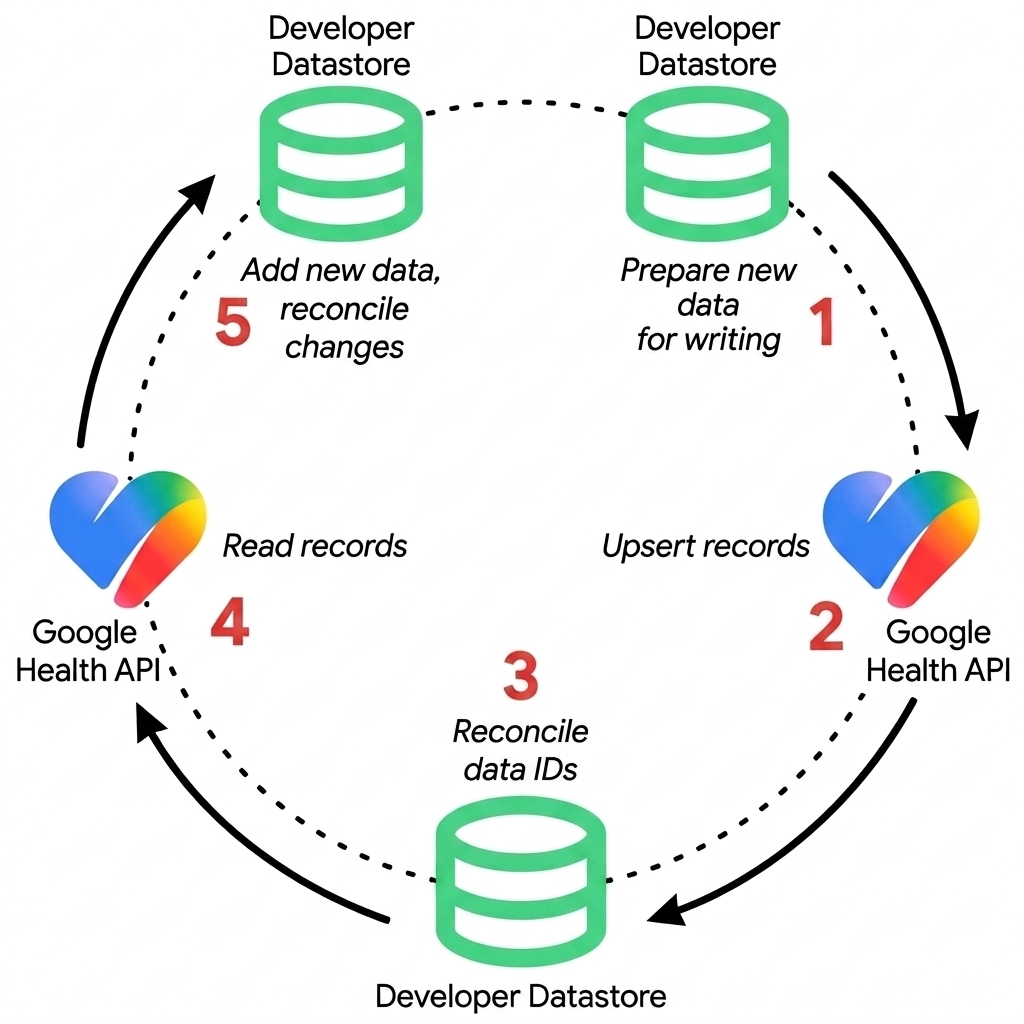
Việc tích hợp với Google Health API có nghĩa là sao chép dữ liệu vào một ứng dụng hoặc kho dữ liệu phụ trợ. Để dễ sử dụng trong tài liệu này, chúng ta sẽ gọi kho dữ liệu này là kho dữ liệu dành cho nhà phát triển.
"Sao chép" ở đây có thể thay thế cho bất kỳ hoạt động riêng biệt nào, chẳng hạn như đọc từ Google Health API (sao chép vào kho dữ liệu của nhà phát triển) hoặc ghi vào Google Health API (sao chép vào Google Health API). Việc thực hiện các thao tác này nhiều lần theo một thứ tự cụ thể là vòng đời đồng bộ hoá.
Hình 1 minh hoạ vòng đời đồng bộ hoá tiêu chuẩn liên quan đến các thao tác đọc và ghi, bất kể yếu tố nào đã đề cập trước đó.
Viết
- Chuẩn bị dữ liệu mới để ghi – Chuyển dữ liệu từ một thiết bị hoặc ứng dụng bên ngoài và định dạng các điểm dữ liệu thành biểu thị JSON tương thích với các loại dữ liệu của Google Health API. Xin lưu ý rằng API Health hiện không hỗ trợ các mã nhận dạng tuỳ chỉnh do ứng dụng khách chỉ định cho các thao tác ghi. Bạn có thể cung cấp những mã nhận dạng như vậy trong
POST, nhưng chúng sẽ bị bỏ qua. - Chèn và cập nhật bản ghi – Gửi điểm dữ liệu đến Google Health API bằng cách sử dụng các điểm cuối REST. Sử dụng
POSTđể tạo bản ghi vàPATCHđể chèn và cập nhật bản ghi hiện có. Các mã nhận dạng cần thiết cho thao tácPATCHsẽ đến từ thao tácPOSTtrước đó (bước tiếp theo trong một chu kỳ trước đó). - Xử lý mã nhận dạng tài nguyên được trả về – Khi sử dụng mã nhận dạng do máy chủ tạo, hãy trích xuất và duy trì tài nguyên
namehoặc mã nhận dạng do máy chủ trả về trong kho dữ liệu của nhà phát triển để cho phép các bản cập nhật (PATCH) hoặc lượt xoá (DELETE) trong tương lai. Hãy xem Chiến lược nhận dạng để biết thêm thông tin về 2 loại này.
Đọc
- Đọc bản ghi – Tìm nạp dữ liệu mới và các thay đổi đối với dữ liệu hiện có trong Google Health API bằng cách sử dụng các điểm cuối REST (
GETvới các tham số truy vấnfiltervà phân trangpageTokenhoặc các điểm cuối tổng hợp nhưrollUpvàdailyRollUp) hoặc nhận thông báo theo thời gian thực bằng cách sử dụng Đăng ký Webhook (projects.subscribers). Thông báo chỉ cho biết có dữ liệu mới chứ không cho biết dữ liệu thực tế là gì. - Điều chỉnh datastore của nhà phát triển – Điều chỉnh dữ liệu mới và dữ liệu đã cập nhật cho datastore của nhà phát triển. Các thiết bị được kết nối có thể tạo ra các khoảng thời gian trùng lặp trong quá trình đồng bộ hoá. Để tìm hiểu cách Google Health API giải quyết các vấn đề này, hãy xem phần Dấu thời gian theo khoảng thời gian và đồng bộ hoá thiết bị thông minh.
Sau đó, chu kỳ này sẽ lặp lại theo các khoảng thời gian thích hợp tuỳ theo nhu cầu cụ thể của các thiết bị hoặc ứng dụng bên ngoài. Đây thường là thứ tự mà chúng tôi đề xuất để đồng bộ hoá dữ liệu giữa kho dữ liệu của bạn và Google Health API.
Chiến lược nhận dạng
Nếu muốn ghi dữ liệu vào Google Health API, trước khi tạo mối tích hợp với Google Health API, bạn phải chọn một chiến lược nhận dạng tài nguyên khi tạo điểm dữ liệu (đơn vị dữ liệu cơ bản).
Health API hiện không hỗ trợ mã nhận dạng do ứng dụng khách chỉ định cho các thao tác ghi.
Bạn có thể cung cấp các mã nhận dạng như vậy trong POST, nhưng chúng sẽ bị bỏ qua. Thông tin chi tiết về lựa chọn này được cung cấp ở đây chỉ nhằm mục đích tham khảo.
- Mã do máy chủ tạo (lựa chọn mặc định): Ứng dụng gửi dữ liệu mà không có mã nhận dạng và phần phụ trợ Google Health API sẽ tạo và trả về một mã nhận dạng hệ thống duy nhất.
- Mã nhận dạng tuỳ chỉnh do khách hàng chỉ định (theo AIP-133, chưa được hỗ trợ): Ứng dụng khách tạo một giá trị nhận dạng riêng biệt (ví dụ: khoá chính UUID hoặc cơ sở dữ liệu cục bộ) và cung cấp giá trị nhận dạng đó trong đường dẫn tài nguyên khi tạo.
Bảng sau đây so sánh cả hai chiến lược nhận dạng để giúp bạn chọn phương pháp phù hợp cho hoạt động tích hợp:
| Tính năng | Mã nhận dạng do máy chủ tạo | Mã nhận dạng tuỳ chỉnh do khách hàng chỉ định |
|---|---|---|
| Tạo mã nhận dạng | Máy chủ tạo mã nhận dạng hệ thống ngẫu nhiên trong quá trình thực thi POST. |
Ứng dụng tạo mã nhận dạng ổn định cục bộ (UUID phiên bản 4 / khoá chính nội bộ) trước khi ghi. |
| Đường dẫn tài nguyên | .../dataPoints/{server_id} (trả về trong phản hồi) |
.../dataPoints/{custom_id} |
| Post-Write Local Step | Bắt buộc. Phải lưu trữ server_id đã trả về trong DB cục bộ để cho phép cập nhật/xoá trong tương lai. |
Không có. Ứng dụng đã sở hữu mã nhận dạng này. |
| Bảng liên kết mã nhận dạng | Bắt buộc. Ứng dụng phải duy trì mối liên kết hai chiều (local_id ↔ server_id). |
Không cần thiết. Ứng dụng khách sử dụng trực tiếp khoá chính của riêng mình. |
| Hành vi thử lại (Mạng yếu) | Rủi ro về nội dung trùng lặp. Việc thử lại POST đã hết thời gian chờ sẽ tạo một bản sao có mã máy chủ mới. |
An toàn và bất biến. Thử lại POST với cùng một custom_id sẽ ngăn việc tạo trùng lặp (trả về 409
ALREADY_EXISTS). |
| Hỗ trợ đồng bộ hoá ngoại tuyến | Bị hạn chế. Phải đợi phản hồi của máy chủ để lấy mã nhận dạng tài nguyên chính thức trước khi tham chiếu đến các mã nhận dạng đó. | Full. Bạn có thể tạo và thay đổi các thực thể ở chế độ ngoại tuyến bằng mã nhận dạng ổn định, sau đó đồng bộ hoá liền mạch khi kết nối lại. |
| Các quy tắc ràng buộc về định dạng | Do máy chủ xử lý hoàn toàn. | Phải tuân theo ^[a-z0-9-]{4,63}$ (4–63 ký tự chữ và số viết thường và dấu gạch nối). |
| Thời điểm lựa chọn |
Chọn mã nhận dạng do máy chủ tạo nếu:
|
Chọn mã nhận dạng tuỳ chỉnh nếu:
|
Vòng đời đồng bộ hoá chỉ có thể đọc

Một ứng dụng chỉ có ý định đọc dữ liệu từ Google Health API phải sao chép dữ liệu vào kho dữ liệu của nhà phát triển và xử lý phần điều chỉnh của vòng đời.
Các nhiệm vụ tương tự được đề cập trong phần Đọc cũng áp dụng ở đây.
Hình 2 minh hoạ vòng đời chỉ đọc.
Dấu thời gian theo khoảng và đồng bộ hoá thiết bị được kết nối
Dữ liệu khoảng thời gian thể hiện các phép đo được thu thập trong một khoảng thời gian, chẳng hạn như số bước, tần số tim hoặc các phiên tập thể dục. Ngược lại, các phép đo tại một thời điểm bao gồm các mục nhập thủ công như nhật ký thực phẩm hoặc chỉ số cân nặng. Dữ liệu khoảng thời gian thường bắt nguồn từ việc đồng bộ hoá các thiết bị được kết nối, chẳng hạn như đồng hồ thông minh và thiết bị theo dõi hoạt động thể dục.
Dấu thời gian theo khoảng (startTime và endTime trong tải trọng JSON REST hoặc start_time và end_time trong biểu thức bộ lọc và gRPC) có các hành vi riêng biệt khi làm việc với dữ liệu theo khoảng. Phần này giải thích lý do xảy ra các khoảng thời gian trùng lặp và so sánh các điểm cuối list và reconcile.
Khoảng thời gian trùng lặp từ các thiết bị đã kết nối
Các thiết bị được kết nối như thiết bị theo dõi Fitbit và Google Pixel Watch liên tục thu thập các chỉ số sinh học có tần suất cao trong khi bạn đeo. Sau khi một thiết bị đồng bộ hoá các điểm dữ liệu với Google Health, thiết bị đó sẽ không thay đổi các bản ghi hiện có đó trở về trước. Dấu thời gian khoảng thời gian được lưu trữ của họ vẫn không thay đổi.
Tuy nhiên, trước các chu kỳ đồng bộ hoá tiếp theo, các thuật toán trên thiết bị thường diễn giải lại dữ liệu đo từ xa thô của cảm biến. Thiết bị sẽ phân loại lại các chỉ số được thu thập trong những giờ trước đó. Khi thiết bị đồng bộ hoá lại, thiết bị sẽ tải các điểm dữ liệu mới lên. Ranh giới bắt đầu và kết thúc của các khoảng thời gian này có thể trùng với các khoảng thời gian đã lưu trữ trước đó.
Ví dụ: hãy xem xét một người dùng đeo đồng hồ thông minh có dữ liệu hoạt động được đồng bộ hoá theo 2 lô liên tiếp:
- Trong lần đồng bộ hoá đầu tiên, thiết bị sẽ tải lên một điểm dữ liệu bao gồm khoảng thời gian từ
10:00:00Zđến10:14:59Z. - Sau khi tính toán lại trên thiết bị, lần đồng bộ hoá thứ hai sẽ tải một điểm dữ liệu khác lên, bao gồm
10:14:00Zđến10:28:59Z.
Cả hai hồ sơ này đều được lưu trữ độc lập trong phần phụ trợ của Google Health. Do đó, cả hai điểm dữ liệu đều bao gồm khoảng thời gian từ 10:14:00Z đến 10:14:59Z.
Điều này tạo ra khoảng thời gian trùng lặp là 59 giây khi truy vấn các bản ghi thô.
So sánh danh sách và đối chiếu các điểm cuối
Bạn có thể xử lý các khoảng thời gian trùng lặp này bằng cách sử dụng điểm cuối list hoặc reconcile. Chọn điểm cuối phù hợp với các yêu cầu của ứng dụng:
| Tính năng | điểm cuối list |
Điểm cuối reconcile |
|---|---|---|
| Phương thức HTTP | GET https://health.googleapis.com/v4/users/me/dataTypes/dataType/dataPoints |
GET https://health.googleapis.com/v4/users/me/dataTypes/dataType/dataPoints:reconcile |
| Hành vi trùng lặp | Trả về tất cả các bản ghi đã lưu trữ dưới dạng được tải lên mà không loại bỏ dữ liệu trùng lặp. Khi các khoảng thời gian chồng chéo, cả hai bản ghi đều được trả về. | Giải quyết xung đột và loại bỏ các bản ghi trùng lặp trên các thiết bị và phiên đồng bộ hoá thành một luồng liên tục duy nhất. |
| Ưu điểm | Cung cấp nhật ký kiểm tra đầy đủ, chưa được sửa đổi của mọi bản ghi do mỗi thiết bị và lô đồng bộ hoá tải lên. | Đơn giản hoá quá trình kết xuất dòng thời gian và tính toán thời lượng bằng cách tự động xử lý các khoảng thời gian trùng lặp và xung đột trên nhiều thiết bị. |
| Nhược điểm | Ứng dụng của bạn chịu trách nhiệm phát hiện và giải quyết các khoảng thời gian trùng lặp, xung đột trên nhiều thiết bị và khoảng thời gian không đeo thiết bị. | Các bản ghi trùng lặp cấp dưới sẽ bị loại khỏi phản hồi, vì vậy, bạn không thể kiểm tra riêng lẻ từng lô đồng bộ hoá thiết bị. |
Điểm cuối reconcile được thiết kế để vẽ giao diện người dùng, kết xuất dòng thời gian hoạt động và tính tổng thời lượng không trùng lặp. Thao tác này sẽ giải quyết các khoảng thời gian xung đột từ các phiên đồng bộ hoá được phân loại lại. API này cũng điều chỉnh hoạt động được ghi lại đồng thời trên nhiều thiết bị, chẳng hạn như đồng hồ và điện thoại.
Quá trình đối chiếu sẽ giải quyết các phiên xung đột bằng cách chọn bản ghi có thẩm quyền thay vì tổng hợp một liên minh thời gian nhân tạo. Ví dụ: tính năng này không hợp nhất 11:00:00Z thành 11:30:00Z và 11:20:00Z thành 11:50:00Z thành 11:00:00Z thành 11:50:00Z. Phản hồi đã được điều chỉnh sẽ trả về điểm dữ liệu chiến thắng cùng với khoảng thời gian ghi lại ban đầu. Điều này giúp duy trì tính toàn vẹn của số liệu đo từ xa và chỉ số được đo lường của phiên đó.
Hình 3 minh hoạ cách điểm cuối reconcile xử lý các phiên trùng lặp.
Thao tác này sẽ chọn bản ghi có thẩm quyền thay vì tạo một liên minh thời gian nhân tạo.

Hướng dẫn về Điểm cuối cung cấp các ví dụ đầy đủ về yêu cầu và phản hồi. Để so sánh các bản ghi list thô với đầu ra reconcile, hãy xem phần Xem dữ liệu khoảng thời gian đã được đối chiếu.
Điểm cuối list được thiết kế để chẩn đoán thiết bị và kiểm tra dữ liệu. Sử dụng khi quy trình làm việc của bạn yêu cầu kiểm tra các bản ghi chưa được sửa đổi khi mỗi thiết bị tải lên. Khi truy vấn bằng list, logic của ứng dụng phải xử lý mọi khoảng thời gian trùng lặp trong dữ liệu thô.
Khả năng thay đổi dấu thời gian và thông tin cập nhật của chủ sở hữu
Các thiết bị được kết nối không sửa đổi ngược dòng dấu thời gian đã lưu trong các chu kỳ đồng bộ hoá thông thường. Tuy nhiên, dấu thời gian theo khoảng (startTime và endTime trong tải trọng JSON REST hoặc start_time và end_time trong biểu thức bộ lọc và gRPC) không phải là bất biến trên tất cả các nguồn dữ liệu. Chỉ người tạo hoặc chủ sở hữu ban đầu của một bản ghi mới có thể sửa đổi các trường của bản ghi đó. Các ứng dụng khác không thể chỉnh sửa những điểm dữ liệu mà chúng không tạo ra.
Ứng dụng chủ sở hữu có thể dùng điểm cuối patch để cập nhật các bản ghi hiện có. Thao tác này bao gồm việc sửa đổi dấu thời gian bắt đầu hoặc kết thúc, thao tác này sẽ cập nhật cả trường UTC (startTime và endTime) và giờ địa phương (civilStartTime và civilEndTime) trên máy chủ. Để biết ví dụ về cách cập nhật dấu thời gian bằng PATCH, hãy xem phần Cập nhật dấu thời gian của khoảng thời gian cho dữ liệu hiện có trong hướng dẫn về Điểm cuối.
Tương tự, các điểm dữ liệu được đồng bộ hoá từ các nền tảng bên ngoài như Health Connect hoặc các ứng dụng đối tác sẽ kế thừa thông tin cập nhật từ nguồn gốc. Nếu sau đó Health Connect nhận được thông tin cập nhật cho một bản ghi đã đồng bộ hoá từ ứng dụng bên thứ ba ban đầu, thì những thay đổi đó sẽ lan truyền và ghi đè bản ghi hiện có.