
Die Arbeit mit Daten in der Google Health API ist im Grunde ein Zyklus der Synchronisierung von Daten zwischen dem Google Health API-Datenspeicher in der Cloud und Ihrem eigenen App- oder Backend-Datenspeicher. Dieser Zyklus kann jedoch je nach verschiedenen Faktoren unterschiedliche Formen annehmen:
- Schreiben Sie Daten in die Google Health API? Nur lesen? Oder beides?
- Ist Ihr Datenspeicher lokal in der App oder auf dem Gerät? Oder in Ihrer eigenen Cloud?
- Müssen Google Health API-Daten zwischen der App des Nutzers und einem Wearable synchronisiert werden? Wie oft synchronisieren Sie Geräte?
- Mit welchen Datentypen arbeiten Sie? Grundlegende Zählungen? Maßeinheiten? Serien mit unterschiedlichen Stichprobenraten?
- Planen Sie, Daten zu lesen, während sich Ihre App im Hintergrund befindet?
- Planen Sie, mit Verlaufsdaten zu arbeiten, die vor der Erteilung von Nutzerberechtigungen für Ihre App aufgezeichnet wurden?
Wie das alles zusammenhängt, erfahren Sie im Synchronisierungszyklus der Google Health API. Es gibt zwei Versionen dieses Lebenszyklus: Standard (Lesen und Schreiben) und schreibgeschützt.
Der Standardlebenszyklus für die Synchronisierung
Bei der Integration in die Google Health API werden Daten in eine App oder einen Backend-Datenspeicher kopiert. Zur besseren Lesbarkeit nennen wir diesen Datenspeicher in dieser Dokumentation Entwickler-Datenspeicher.
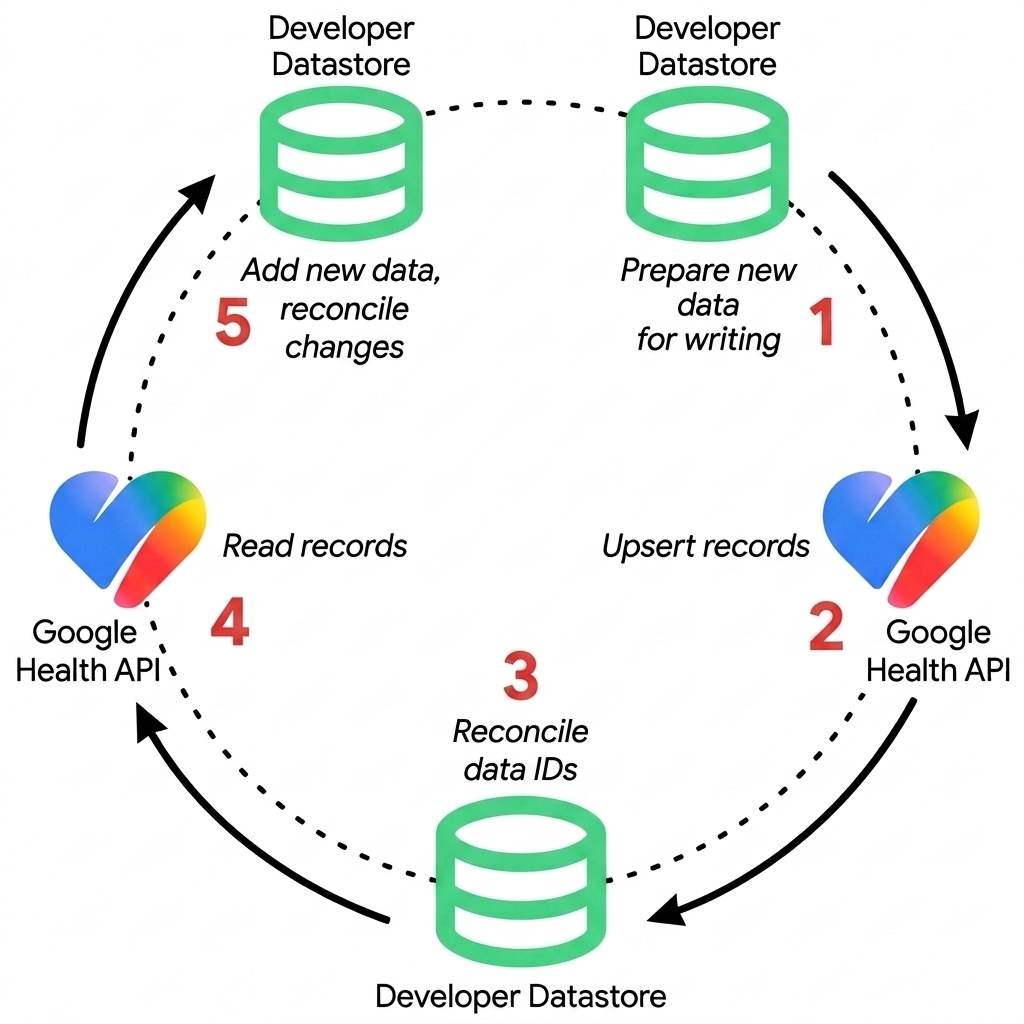
„Kopieren“ kann hier für jede einzelne Aktivität stehen, z. B. das Lesen aus der Google Health API (Kopieren in den Entwicklerdatenspeicher) oder das Schreiben in die Google Health API (Kopieren in die Google Health API). Die wiederholte Ausführung dieser Aktionen in einer bestimmten Reihenfolge ist der Synchronisierungslebenszyklus.
Abbildung 1 zeigt den standardmäßigen Synchronisierungszyklus mit Lese- und Schreibvorgängen, ohne Berücksichtigung der zuvor genannten Faktoren.
Schreiben
- Neue Daten für das Schreiben vorbereiten: Übertrage Daten von einem externen Gerät oder einer externen App und formatiere Datenpunkte in JSON-Darstellungen, die mit den Datentypen der Google Health API kompatibel sind. Benutzerdefinierte, vom Client zugewiesene IDs für Schreibvorgänge werden derzeit in der Health API nicht unterstützt. Solche IDs können in einem
POSTangegeben werden, werden aber ignoriert. - Datensätze einfügen oder aktualisieren: Sie können Datenpunkte über REST-Endpunkte an die Google Health API senden. Verwenden Sie
POSTzum Erstellen von Datensätzen undPATCHzum Einfügen und Aktualisieren vorhandener Datensätze. Die für denPATCH-Vorgang erforderlichen IDs stammen aus einem vorherigenPOST-Vorgang (nächster Schritt in einem vorherigen Zyklus). - Zurückgegebene Ressourcen-IDs verarbeiten: Wenn Sie serverseitig generierte IDs verwenden, extrahieren Sie die vom Server zurückgegebene Ressource
nameoder ID und speichern Sie sie in Ihrem Entwicklerdatenspeicher, um zukünftige Aktualisierungen (PATCH) oder Löschungen (DELETE) zu ermöglichen. Weitere Informationen zu den beiden Typen finden Sie unter Identifikationsstrategien.
Lesen
- Datensätze lesen: Neue Daten und Änderungen an vorhandenen Daten in der Google Health API über REST-Endpunkte abrufen (
GETmitfilter-Abfrageparametern undpageToken-Paginierung oder Aggregationsendpunkte wierollUpunddailyRollUp) oder Echtzeitbenachrichtigungen über Webhook-Abos (projects.subscribers) erhalten. Eine Benachrichtigung gibt nur an, dass neue Daten verfügbar sind, nicht, was die tatsächlichen Daten sind. - Entwickler-Datastore abgleichen: Gleichen Sie die neuen und aktualisierten Daten mit Ihrem Entwickler-Datastore ab. Bei der Synchronisierung können sich Intervalle von verbundenen Geräten überschneiden. Weitere Informationen dazu, wie die Google Health API diese Probleme behebt, finden Sie unter Zeitstempel für Intervalle und Synchronisierung verbundener Geräte.
Dieser Zyklus wird dann in angemessenen Intervallen entsprechend den spezifischen Anforderungen externer Geräte oder Apps wiederholt. Das ist im Allgemeinen die Reihenfolge, die wir für die Synchronisierung von Daten zwischen Ihrem eigenen Datenspeicher und der Google Health API empfehlen.
Strategien zur Identifizierung
Wenn Sie Daten in die Google Health API schreiben möchten, müssen Sie vor der Entwicklung Ihrer Integration mit den Google Health APIs eine Strategie zur Ressourcenidentifizierung auswählen, wenn Sie Datenpunkte (die Grundeinheit von Daten) erstellen.
Clientseitig zugewiesene IDs für Schreibvorgänge werden in der Health API derzeit nicht unterstützt.
Solche IDs können in einem POST angegeben werden, werden aber ignoriert. Details zu dieser Option werden hier zu Informationszwecken bereitgestellt.
- Vom Server generierte IDs (Standardoption): Der Client sendet Daten ohne ID und das Google Health API-Backend generiert und gibt eine eindeutige System-ID zurück.
- Vom Client zugewiesene benutzerdefinierte IDs (gemäß AIP-133, noch nicht unterstützt): Die Client-App generiert eine eindeutige Kennung (z. B. eine UUID oder einen Primärschlüssel der lokalen Datenbank) und gibt sie beim Erstellen im Ressourcenpfad an.
In der folgenden Tabelle werden die beiden Identifizierungsstrategien verglichen, damit Sie den richtigen Ansatz für Ihre Integration auswählen können:
| Funktion | Vom Server generierte IDs | Vom Kunden zugewiesene benutzerdefinierte IDs |
|---|---|---|
| ID-Generierung | Der Server generiert während der Ausführung von POST eine zufällige System-ID. |
Der Client generiert eine stabile ID lokal (UUID v4 / interner Primärschlüssel) vor dem Schreiben. |
| Ressourcenpfad | .../dataPoints/{server_id} (in der Antwort zurückgegeben) |
.../dataPoints/{custom_id} |
| Schritt nach dem Schreiben lokaler Daten | Erforderlich. Der zurückgegebene server_id muss in der lokalen Datenbank gespeichert werden, um zukünftige Aktualisierungen/Löschungen zu ermöglichen. |
Keine. Die App ist bereits Inhaber der ID. |
| ID-Zuordnungstabelle | Erforderlich. Der Client muss eine bidirektionale Zuordnung (local_id ↔ server_id) aufrechterhalten. |
Nicht erforderlich. Der Client verwendet seinen eigenen Primärschlüssel direkt. |
| Wiederholungsverhalten (schwaches Netzwerk) | Risiko von Duplikaten: Wenn Sie einen POST-Vorgang mit Zeitüberschreitung noch einmal versuchen, wird ein doppelter Datensatz mit einer neuen Server-ID erstellt. |
Sicher und idempotent. Wenn Sie POST mit demselben custom_id noch einmal versuchen, wird die doppelte Erstellung verhindert (es wird 409
ALREADY_EXISTS zurückgegeben). |
| Unterstützung der Offlinesynchronisierung | Begrenzt Sie müssen auf die Serverantwort warten, um offizielle Ressourcen-IDs zu erhalten, bevor Sie darauf verweisen. | Vollständig: Entitäten können offline mit stabilen IDs erstellt und geändert werden. Wenn die Verbindung wiederhergestellt wird, werden sie nahtlos synchronisiert. |
| Beschränkungen bei Formaten | Wird vollständig vom Server verarbeitet. | Muss ^[a-z0-9-]{4,63}$ entsprechen (4–63 Kleinbuchstaben, alphanumerische Zeichen und Bindestriche). |
| Wann sollte ich diese Option wählen? |
Wählen Sie vom Server generierte IDs aus, wenn:
|
Wählen Sie benutzerdefinierte IDs aus, wenn:
|
Der schreibgeschützte Synchronisierungslebenszyklus

Eine App, die nur Daten aus der Google Health API lesen möchte, muss Daten in ihren Entwicklerdatenspeicher kopieren und den Abgleichsteil des Lebenszyklus verarbeiten.
Hier gelten dieselben Aufgaben wie im Abschnitt Lesen.
Abbildung 2 veranschaulicht den schreibgeschützten Lebenszyklus.
Zeitstempel für Intervalle und Synchronisierung verbundener Geräte
Intervall-Daten stellen Messungen dar, die über einen bestimmten Zeitraum hinweg erfasst wurden, z. B. Schritte, Herzfrequenz oder Trainingseinheiten. Im Gegensatz dazu enthalten Momentaufnahmen manuelle Einträge wie ein Ernährungsprotokoll oder eine Waagenmessung. Intervalldaten stammen in der Regel von der Synchronisierung verbundener Geräte wie Smartwatches und Fitnesstrackern.
Bei Intervallzeitstempeln (startTime und endTime in REST-JSON-Nutzlasten oder start_time und end_time in Filterausdrücken und gRPC) gibt es Besonderheiten, die bei der Arbeit mit Intervalldaten zu beachten sind. In diesem Abschnitt wird erläutert, warum sich Intervalle überschneiden, und die Endpunkte list und reconcile werden verglichen.
Sich überschneidende Intervalle von verbundenen Geräten
Verbundene Geräte wie Fitbit-Tracker und die Google Pixel Watch erfassen kontinuierlich biometrische Daten mit hoher Frequenz, während sie getragen werden. Nachdem ein Gerät Datenpunkte mit Google Health synchronisiert hat, werden die vorhandenen Datensätze nicht nachträglich geändert. Die gespeicherten Intervall-Zeitstempel bleiben unverändert.
Vor nachfolgenden Synchronisierungszyklen interpretieren On-Device-Algorithmen jedoch oft die Rohdaten der Sensoren neu. Das Gerät ordnet Messwerte, die in den vorangegangenen Stunden erfasst wurden, neu zu. Wenn das Gerät wieder synchronisiert wird, werden neue Datenpunkte hochgeladen. Die Start- und Endgrenzen können sich mit zuvor gespeicherten Intervallen überschneiden.
Angenommen, ein Nutzer trägt eine Smartwatch, deren Aktivitätsdaten in zwei aufeinanderfolgenden Batches synchronisiert werden:
- Bei der ersten Synchronisierung lädt das Gerät einen Datenpunkt für den Zeitraum vom
10:00:00Zbis zum10:14:59Zhoch. - Nach der Neuberechnung auf dem Gerät wird bei einer zweiten Synchronisierung ein weiterer Datenpunkt hochgeladen, der den Zeitraum von
10:14:00Zbis10:28:59Zabdeckt.
Beide Datensätze werden unabhängig voneinander im Google Health-Backend gespeichert. Daher decken beide Datenpunkte das Intervall von 10:14:00Z bis 10:14:59Z ab.
Beim Abfragen von Rohdatensätzen ergibt sich dadurch eine Überschneidung von 59 Sekunden.
Endpunkte vergleichen und abstimmen
Sie können diese sich überschneidenden Intervalle entweder mit dem Endpunkt list oder reconcile verarbeiten. Wählen Sie den Endpunkt aus, der den Anforderungen Ihrer Anwendung entspricht:
| Funktion | list Endpunkt |
reconcile Endpunkt |
|---|---|---|
| HTTP-Methode | GET https://health.googleapis.com/v4/users/me/dataTypes/dataType/dataPoints |
GET https://health.googleapis.com/v4/users/me/dataTypes/dataType/dataPoints:reconcile |
| Überschneidungsverhalten | Gibt alle gespeicherten Datensätze als hochgeladen ohne Deduplizierung zurück. Wenn sich Intervalle überschneiden, werden beide Datensätze zurückgegeben. | Konflikte werden behoben und sich überschneidende Datensätze werden geräte- und synchronisierungsübergreifend in einem einzigen kontinuierlichen Stream zusammengeführt. |
| Vorteile | Bietet einen vollständigen, unveränderten Audit-Trail für jeden Datensatz, der von jedem Gerät und jeder Synchronisierungsbatch hochgeladen wird. | Vereinfacht das Rendern von Zeitachsen und die Berechnung von Zeiträumen, da sich automatisch um sich überschneidende Intervalle und Konflikte für verschiedene Geräte gekümmert wird. |
| Nachteile | Ihre Anwendung ist für das Erkennen und Beheben von sich überschneidenden Intervallen, Konflikten für verschiedene Geräte und Zeiträumen, in denen das Gerät nicht am Handgelenk getragen wird, verantwortlich. | Untergeordnete sich überschneidende Datensätze werden aus der Antwort ausgelassen, sodass einzelne Gerätesynchronisierungs-Batches nicht isoliert geprüft werden können. |
Der reconcile-Endpunkt ist für das Zeichnen von Benutzeroberflächen, das Rendern von Aktivitätszeitachsen und das Berechnen von nicht überlappenden Gesamtdauern konzipiert. Dadurch werden widersprüchliche Intervalle aus neu gruppierten Synchronisierungssitzungen behoben. Außerdem werden Aktivitäten abgeglichen, die gleichzeitig auf mehreren Geräten wie einer Smartwatch und einem Smartphone aufgezeichnet wurden.
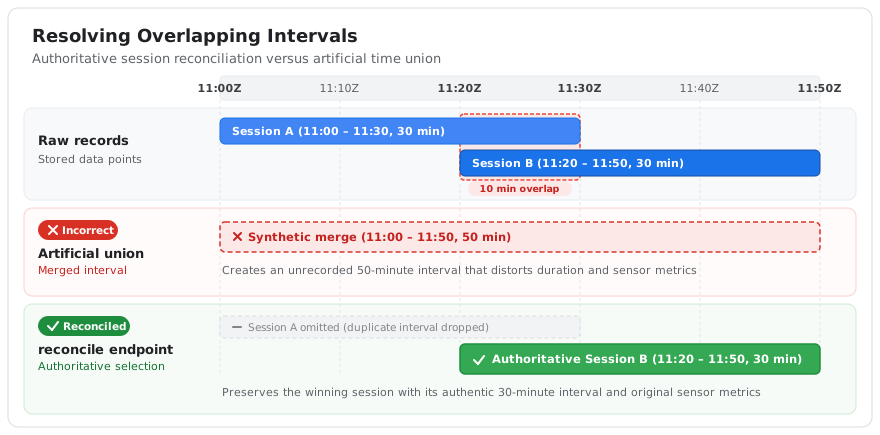
Bei der Abstimmung werden in Konflikt stehende Sitzungen aufgelöst, indem der maßgebliche Datensatz ausgewählt wird, anstatt eine künstliche Zeitvereinigung zu erstellen. Beispiel: 11:00:00Z bis 11:30:00Z und 11:20:00Z bis 11:50:00Z werden nicht in 11:00:00Z bis 11:50:00Z zusammengeführt. Die abgestimmte Antwort gibt den Gewinner-Datenpunkt mit dem ursprünglich aufgezeichneten Intervall zurück. So wird die Integrität der Telemetriedaten und Messwerte dieser Sitzung gewahrt.
Abbildung 3 veranschaulicht, wie der reconcile-Endpunkt überlappende Sitzungen verarbeitet.
Es wird der maßgebliche Datensatz ausgewählt, anstatt eine künstliche Zeitvereinigung zu erstellen.
Die Endpoints-Anleitung enthält vollständige Beispiele für Anfragen und Antworten. Wenn Sie list-Rohdatensätze mit der reconcile-Ausgabe vergleichen möchten, lesen Sie den Abschnitt Abgestimmte Ansicht von Intervall-Daten abrufen.
Der list-Endpunkt ist für Gerätediagnosen und Datenprüfungen vorgesehen. Verwenden Sie sie, wenn in Ihrem Workflow unveränderte Datensätze geprüft werden müssen, die von den einzelnen Geräten hochgeladen wurden. Wenn Sie Abfragen mit list ausführen, muss Ihre Clientlogik alle Intervallüberschneidungen in den Rohdaten verarbeiten.
Unveränderlichkeit von Zeitstempeln und Aktualisierungen des Inhabers
Verbundene Geräte ändern gespeicherte Zeitstempel während normaler Synchronisierungszyklen nicht rückwirkend. Intervall-Zeitstempel (startTime und endTime in REST-JSON-Nutzlasten oder start_time und end_time in Filterausdrücken und gRPC) sind jedoch nicht für alle Datenquellen unveränderlich. Nur der ursprüngliche Ersteller oder Inhaber eines Datensatzes kann seine Felder ändern. Andere Anwendungen können keine Datenpunkte bearbeiten, die sie nicht selbst erstellt haben.
Eine Eigentümeranwendung kann den patch-Endpunkt verwenden, um ihre vorhandenen Datensätze zu aktualisieren. Dazu gehört auch das Ändern von Start- oder Endzeitstempeln, wodurch sowohl die UTC-Felder (startTime und endTime) als auch die Felder für die bürgerliche Zeit (civilStartTime und civilEndTime) auf dem Server aktualisiert werden. Ein Beispiel für das Aktualisieren von Zeitstempeln mit PATCH finden Sie im Endpunkte-Leitfaden unter Zeitstempel für vorhandene Daten aktualisieren.
Ebenso werden Datenpunkte, die von externen Plattformen wie Health Connect oder Partner-Apps synchronisiert werden, von der ursprünglichen Quelle aktualisiert. Wenn Health Connect anschließend ein Update für einen synchronisierten Datensatz von der ursprünglichen Drittanbieter-App erhält, werden diese Änderungen übernommen und der vorhandene Datensatz wird überschrieben.