

Работа с данными в Google Health API по своей сути представляет собой цикл синхронизации данных между хранилищем данных Google Health API в облаке и вашим собственным приложением или серверным хранилищем данных. Однако этот цикл может принимать различные формы в зависимости от множества факторов:
- Вы записываете данные в API Google Health? Только читаете? Или делаете и то, и другое?
- Ваше хранилище данных находится локально в приложении или на устройстве? Или в вашем собственном облаке?
- Вам необходимо синхронизировать данные Google Health API между приложением пользователя и носимым устройством? Как часто вы синхронизируете устройства?
- С какими типами данных вы работаете? С простыми подсчетами? С единицами измерения? С рядами данных с разной частотой выборки?
- Вы планируете считывать данные, пока ваше приложение работает в фоновом режиме?
- Планируете ли вы работать с историческими данными, записанными до того, как ваше приложение получило разрешения пользователей?
Чтобы понять, как всё это взаимосвязано, взгляните на жизненный цикл синхронизации API Google Health. Существует две версии этого жизненного цикла: стандартная (чтение и запись) и только для чтения.
Стандартный жизненный цикл синхронизации
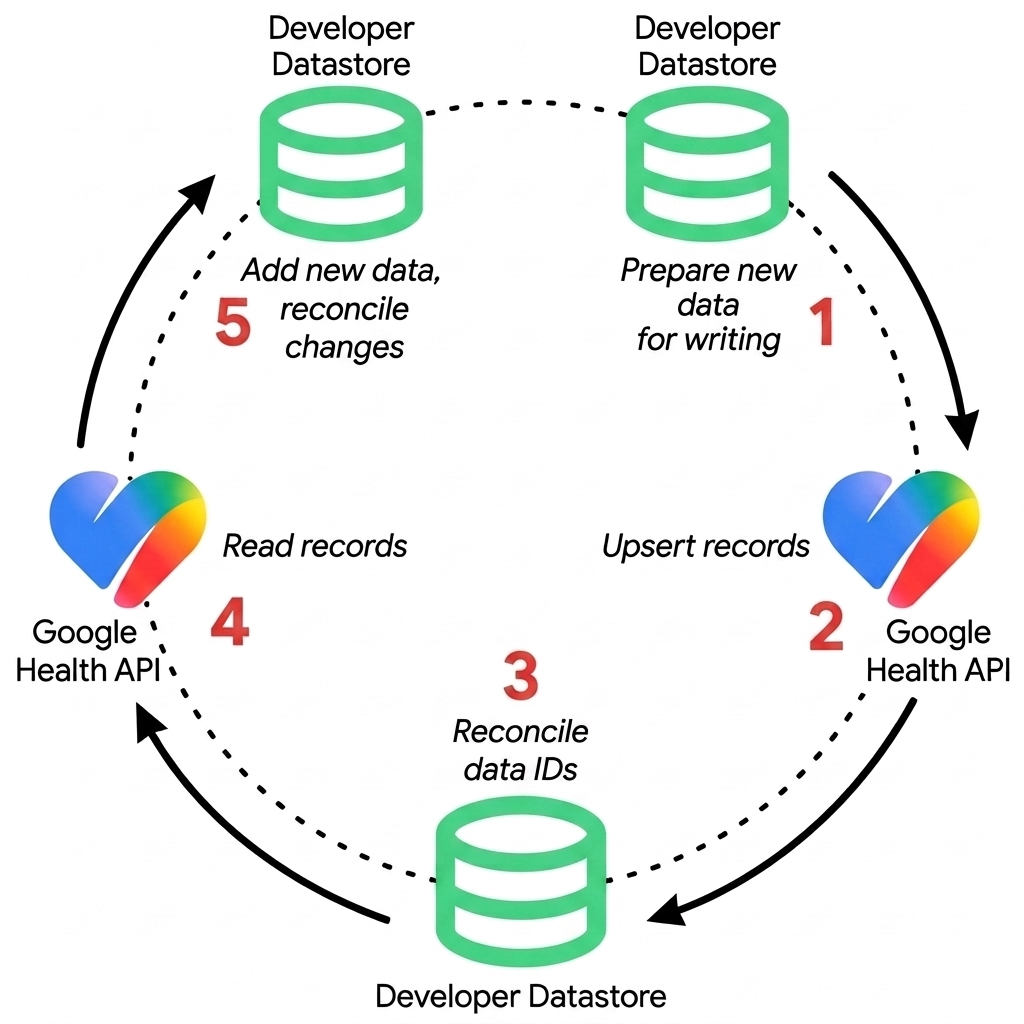
Интеграция с API Google Health подразумевает копирование данных в приложение или серверное хранилище данных. Для удобства использования в этой документации мы будем называть это хранилище данных хранилищем данных для разработчиков .
Здесь под "копированием" может подразумеваться любое отдельное действие, например, чтение из Google Health API (копирование в хранилище данных для разработчиков) или запись в Google Health API (копирование в Google Health API). Повторное выполнение этих действий в определенной последовательности составляет жизненный цикл синхронизации.
На рисунке 1 показан стандартный жизненный цикл синхронизации, включающий операции чтения и записи, без учета каких-либо из ранее упомянутых факторов.
Писать
- Подготовка новых данных к записи — Передача данных с внешнего устройства или приложения и форматирование точек данных в JSON-представления, совместимые с типами данных API Google Health. Обратите внимание, что пользовательские идентификаторы, назначаемые клиентом для записи, в настоящее время не поддерживаются в API Health. Такие идентификаторы могут быть предоставлены в
POST, но они игнорируются. - Обновление/вставка записей — отправка точек данных в API Google Health с использованием REST-конечных точек. Используйте
POSTдля создания записей иPATCHдля вставки и обновления существующих записей. Идентификаторы, необходимые для операцииPATCH, будут получены из предыдущей операцииPOST(следующий шаг в предыдущем цикле). - Обработка возвращаемых идентификаторов ресурсов — При использовании идентификаторов, сгенерированных сервером, извлеките и сохраните возвращаемое сервером
nameили идентификатор ресурса в хранилище данных разработчика, чтобы обеспечить возможность будущих обновлений (PATCH) или удалений (DELETE). Дополнительную информацию о двух типах см. в разделе «Стратегии идентификации» .
Читать
- Чтение записей — Получение новых данных из API Google Health и внесение изменений в существующие данные с помощью REST-конечных точек (
GETс параметрами запросаfilterи пагинациейpageToken, или конечных точек агрегации, таких какrollUpиdailyRollUp), или получение уведомлений в реальном времени с помощью подписок Webhook (projects.subscribers). Уведомление лишь сообщает о наличии новых данных, а не о том, какие именно данные доступны. - Согласование хранилища данных для разработчиков — согласуйте новые и обновленные данные с вашим хранилищем данных для разработчиков. Подключенные устройства могут создавать перекрывающиеся интервалы во время синхронизации. Чтобы узнать, как API Google Health решает эти проблемы, см. раздел «Интерваловые временные метки и синхронизация подключенных устройств» .
Затем этот цикл повторяется через соответствующие интервалы в зависимости от конкретных потребностей внешних устройств или приложений. Как правило, мы рекомендуем именно такой порядок синхронизации данных между вашим собственным хранилищем данных и API Google Health.
Стратегии идентификации
Если вы планируете записывать данные в API Google Health, перед созданием интеграции с API Google Health необходимо выбрать стратегию идентификации ресурсов при создании точек данных (базовой единицы данных).
В настоящее время API мониторинга состояния системы не поддерживает присвоение клиентом идентификаторов для операций записи. Такие идентификаторы могут быть предоставлены в POST , но они игнорируются. Подробная информация об этой опции приведена здесь в ознакомительных целях.
- Идентификаторы, генерируемые сервером (вариант по умолчанию) : клиент отправляет данные без идентификатора, и бэкэнд API Google Health генерирует и возвращает уникальный системный идентификатор.
- Пользовательские идентификаторы, назначаемые клиентом (согласно AIP-133 , пока не поддерживаются) : клиентское приложение генерирует уникальный идентификатор (например, UUID или первичный ключ локальной базы данных) и предоставляет его в пути к ресурсу при создании.
В следующей таблице сравниваются обе стратегии идентификации, чтобы помочь вам выбрать правильный подход для вашей интеграции:
| Особенность | Идентификаторы, сгенерированные сервером | Пользовательские идентификаторы, присвоенные клиентом |
|---|---|---|
| Генерация идентификаторов | В процессе выполнения POST сервер генерирует случайный идентификатор системы. | Перед записью клиент генерирует стабильный идентификатор локально (UUID v4 / внутренний первичный ключ). |
| Путь к ресурсу | .../dataPoints/{server_id} (возвращается в ответе) | .../dataPoints/{custom_id} |
| Локальный шаг после записи | Обязательно. Возвращенный server_id необходимо сохранить в локальной базе данных для обеспечения возможности будущих обновлений/удалений. | Нет. Идентификатор уже принадлежит приложению. |
| Таблица сопоставления идентификаторов | Обязательно. Клиент должен поддерживать двустороннее сопоставление ( local_id ↔ server_id ). | Не требуется. Клиент использует свой собственный первичный ключ напрямую. |
| Повторные попытки (слабая сеть) | Риск дублирования. Повторная попытка отправки POST запроса, завершившаяся по истечении времени ожидания, создаст дубликат записи с новым идентификатором сервера. | Безопасно и идемпотентно. Повторная отправка POST с тем же custom_id предотвращает создание дубликатов (возвращает ошибку 409 ALREADY_EXISTS ). |
| Поддержка синхронизации в автономном режиме | Ограничено. Необходимо дождаться ответа сервера для получения официальных идентификаторов ресурсов, прежде чем ссылаться на них. | Полная версия. Сущности можно создавать и изменять в автономном режиме со стабильными идентификаторами, а затем беспрепятственно синхронизировать при повторном подключении. |
| Ограничения формата | Все это обрабатывается исключительно сервером. | Необходимо следовать ^[a-z0-9-]{4,63}$ (4–63 строчные буквенно-цифровые символы и дефисы). |
| Когда делать выбор | Выбирайте идентификаторы, сгенерированные сервером, если:
| Выберите пользовательские идентификаторы, если:
|
Жизненный цикл синхронизации только для чтения
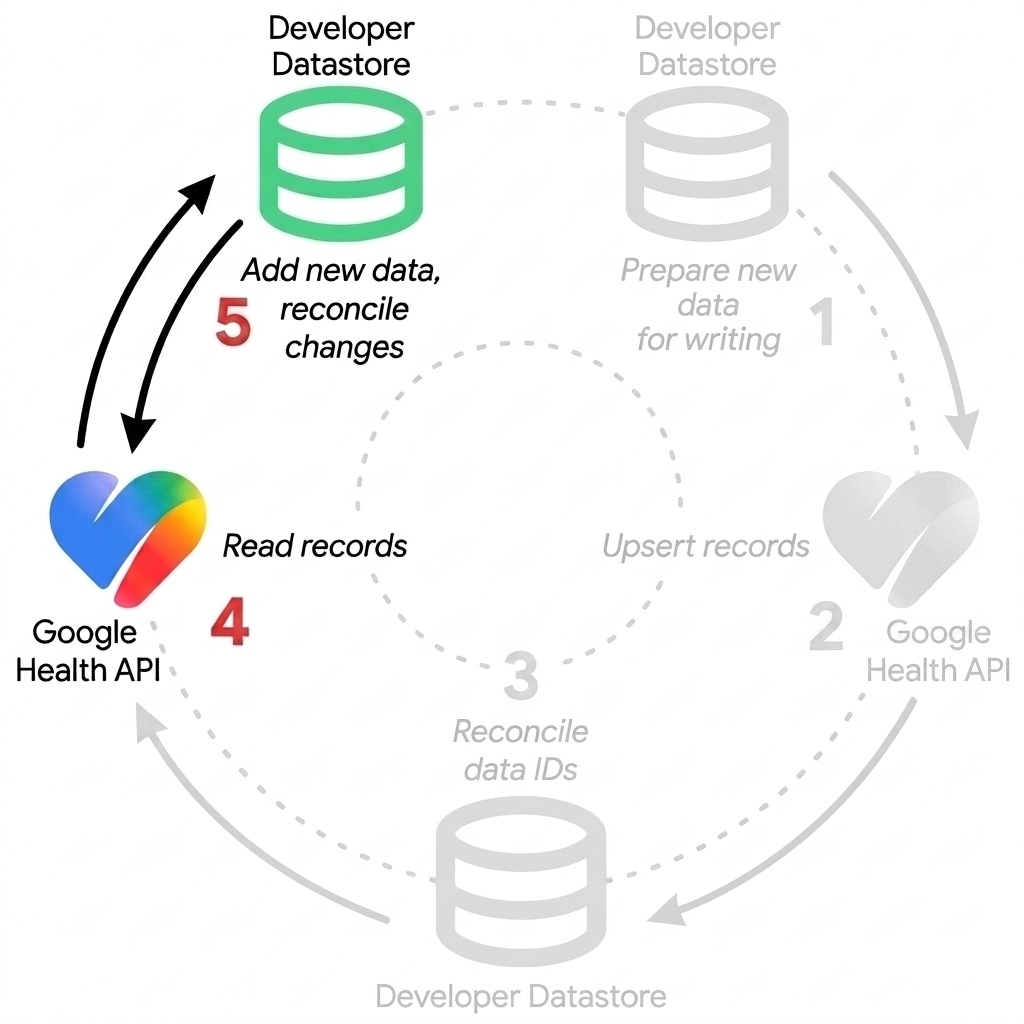
Приложение, предназначенное для чтения данных только из API Google Health, должно скопировать данные в свое хранилище данных для разработчиков и обработать этап согласования в рамках жизненного цикла приложения.
Здесь применяются те же задачи, что и в разделе «Чтение» .
На рисунке 2 показан жизненный цикл только для чтения.
Временные метки интервалов и синхронизация подключенных устройств
Интервальные данные представляют собой измерения, собранные за определенный период времени, такие как количество шагов, частота сердечных сокращений или количество тренировок. В отличие от них, измерения в определенный момент времени включают в себя записи, сделанные вручную, например, в дневнике питания или показания весов. Интервальные данные обычно поступают из синхронизации подключенных устройств, таких как умные часы и фитнес-трекеры.
Временные метки интервалов ( startTime и endTime ) вносят свои особенности в работу с интервальными данными. В этом разделе объясняется, почему возникают перекрывающиеся интервалы, а также сравниваются и reconcile конечные точки list .
Перекрывающиеся интервалы от подключенных устройств
Подключенные устройства, такие как фитнес-трекеры Fitbit и часы Google Pixel Watch, непрерывно собирают высокочастотные биометрические данные во время ношения. После синхронизации данных с Google Health устройство не вносит ретроспективных изменений в существующие записи. Сохраненные временные метки интервалов остаются неизменными.
Однако перед последующими циклами синхронизации встроенные алгоритмы часто заново интерпретируют необработанные телеметрические данные с датчиков. Устройство повторно группирует показания, собранные за предыдущие часы. При повторной синхронизации устройство загружает новые точки данных. Их начальные и конечные границы могут перекрываться с ранее сохраненными интервалами.
Например, рассмотрим пользователя, носящего умные часы, данные об активности которого синхронизируются двумя последовательными партиями:
- В ходе первой синхронизации устройство загружает данные за период
10:00:00Zпо10:14:59Z. - После перерасчета на устройстве выполняется вторая синхронизация, в ходе которой загружается еще одна точка данных, охватывающая период
10:14:00Zдо10:28:59Z.
Обе записи хранятся независимо в бэкэнде Google Health. В результате обе точки данных охватывают интервал с 10:14:00Z до 10:14:59Z . Это приводит к перекрытию в 59 секунд при запросе необработанных записей.
Сравните список и согласуйте конечные точки.
Обработку этих перекрывающихся интервалов можно выполнить с помощью конечной точки list или reconcile . Выберите конечную точку, соответствующую требованиям вашего приложения:
| Особенность | конечная точка list | reconcile конечной точки |
|---|---|---|
| метод HTTP | GET https://health.googleapis.com/v4/users/me/dataTypes/<var>dataType</var>/dataPoints | GET https://health.googleapis.com/v4/users/me/dataTypes/<var>dataType</var>/dataPoints:reconcile |
| Перекрывающееся поведение | Возвращает все сохраненные записи в том виде, в котором они были загружены, без дедупликации. Если интервалы перекрываются, возвращаются обе записи. | Разрешает конфликты и удаляет дубликаты пересекающихся записей на разных устройствах и в сеансах синхронизации, объединяя их в единый непрерывный поток. |
| Преимущества | Предоставляет полный, неизмененный журнал аудита каждой записи, загруженной каждым устройством и пакетом синхронизации. | Упрощает отрисовку временной шкалы и расчет длительности за счет автоматической обработки перекрывающихся интервалов и конфликтов между несколькими устройствами. |
| Недостатки | Ваше приложение отвечает за обнаружение и разрешение перекрывающихся интервалов, конфликтов между несколькими устройствами и периодов отсутствия браслета на запястье. | В ответе отсутствуют подчинённые, частично совпадающие записи, поэтому аудит отдельных пакетов синхронизации устройств невозможно проводить изолированно. |
Конечная точка reconcile предназначена для отрисовки пользовательских интерфейсов, отображения временных шкал активности и вычисления суммарной продолжительности без перекрытия. Она разрешает конфликтующие интервалы в результате повторной синхронизации. Она также согласовывает активность, зарегистрированную одновременно на нескольких устройствах, таких как часы и телефон.
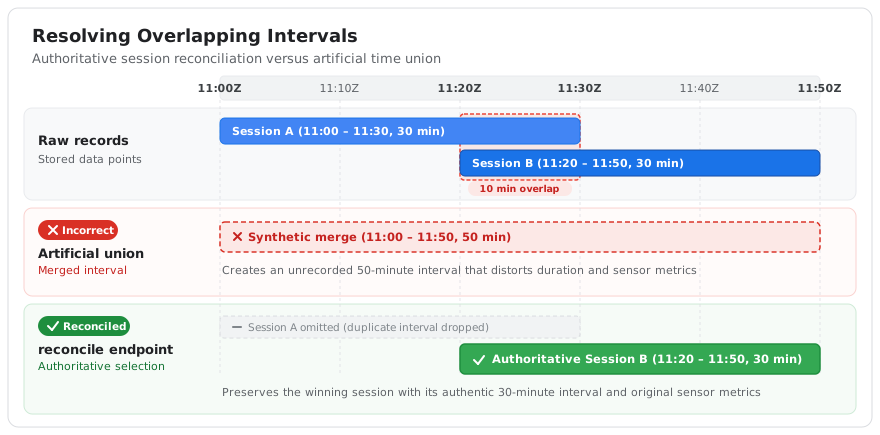
Процесс согласования разрешает конфликтующие сессии, выбирая авторитетную запись, а не создавая искусственное временное объединение. Например, он не объединяет интервалы 11:00:00Z до 11:30:00Z и 11:20:00Z до 11:50:00Z в интервал с 11:00:00Z до 11:50:00Z . Согласованный ответ возвращает выигрышную точку данных с исходным записанным интервалом. Это сохраняет целостность измеренных телеметрических данных и метрик данной сессии.
На рисунке 3 показано, как конечная точка reconcile обрабатывает перекрывающиеся сессии. Она выбирает авторитетную запись, а не создает искусственное временное объединение.
В руководстве по конечным точкам приведены полные примеры запросов и ответов. Чтобы сравнить исходные записи list с результатами reconcile , см. раздел «Получение согласованного представления данных интервала» .
Конечная точка list предназначена для диагностики устройств и аудита данных. Используйте ее, когда ваш рабочий процесс требует проверки неизмененных записей, загруженных каждым устройством. При выполнении запросов с помощью list ваша клиентская логика должна обрабатывать любые перекрытия интервалов в исходных данных.
Возможность изменения временных меток и обновления владельца.
Подключенные устройства не изменяют сохраненные метки времени задним числом во время обычных циклов синхронизации. Однако интервальные метки времени ( startTime и endTime ) не являются универсально неизменяемыми для всех источников данных. Изменять поля записи может только ее первоначальный создатель или владелец. Другие приложения не могут редактировать точки данных, которые они не создавали.
Приложение-владелец может использовать конечную точку patch для обновления существующих записей. Это включает в себя изменение меток времени начала или окончания. Пример обновления меток времени с помощью PATCH см. в разделе «Обновление меток времени интервала для существующих данных» в руководстве по конечным точкам.
Аналогичным образом, данные, синхронизированные с внешних платформ, таких как Health Connect или партнерские приложения, наследуют обновления из исходного источника. Когда исходное приложение изменяет существующую запись, эти обновления распространяются в Google Health.