
L'API Google Health fournit des points de terminaison d'agrégation dédiés qui regroupent et résument les dossiers médicaux dans des périodes de temps. Au lieu de récupérer et d'additionner des enregistrements bruts individuels sur le client, utilisez les points de terminaison d'agrégation pour calculer des métriques (telles que les totaux, les moyennes, les minimums et les maximums) sur un flux de données rapproché :
- Le point de terminaison
rollUpagrège les points de données sur des intervalles de temps physiques en UTC à l'aide d'une durée de fenêtre configurable en secondes (windowSize). - Le point de terminaison
dailyRollUpregroupe les points de données sur un ou plusieurs jours calendaires (windowSizeDays) en utilisant l'heure civile par rapport à l'horloge locale de l'utilisateur.
Les deux points de terminaison rapprochent automatiquement les points de données qui se chevauchent sur les appareils connectés et excluent les périodes où l'appareil n'est pas porté pour les types de données d'accessoires connectés qui sont compatibles avec la détection de port.
Comparer les points de terminaison d'agrégation
Choisissez le point de terminaison d'agrégation qui correspond à la manière dont votre application regroupe et affiche les indicateurs de santé des séries temporelles :
| Fonctionnalité | rollUp point de terminaison |
dailyRollUp point de terminaison |
|---|---|---|
| Requête HTTP | POST https://health.googleapis.com/v4/users/me/dataTypes/data-type/dataPoints:rollUp |
POST https://health.googleapis.com/v4/users/me/dataTypes/data-type/dataPoints:dailyRollUp |
| Représentation du temps | Heure physique au format UTC (startTime et endTime au format RFC 3339). |
Heure civile (start et end en tant qu'objets CivilDateTime). |
| Paramètre de fenêtrage | windowSize (durée de la chaîne requise en secondes, minimum "1s"). |
windowSizeDays (nombre entier de jours facultatif, valeur par défaut : 1). |
| Objet de réponse | RollupDataPoint |
DailyRollupDataPoint |
| Ordre des réponses | Ordre chronologique inverse (la fenêtre la plus récente en premier). | Ordre chronologique inverse (la fenêtre la plus récente en premier). |
| Application idéale | Graphiques intrajournaliers, histogrammes horaires ou à la minute, et analyse UTC à durée fixe. | Tableaux de bord quotidiens, tendances sur plusieurs jours et résumés qui tiennent compte des changements de fuseau horaire ou de l'heure d'été. |
Les deux points de terminaison appliquent des limites maximales de plage de requêtes en fonction du type de données :
- Une plage de requêtes maximale de 14 jours s'applique à
calories-in-heart-rate-zone,heart-rate,active-minutesettotal-calories. - Une plage de requêtes maximale de 90 jours s'applique à tous les autres types de données acceptés.
Pour savoir quels types de données sont compatibles avec rollup et dailyRollup, consultez la documentation de référence sur les types de données de l'API Google Health.
Agréger sur des intervalles de temps physiques
Utilisez le point de terminaison rollUp pour agréger les points de données sur une période physique range (en UTC) regroupés par durée de fenêtre en secondes (windowSize).
Lorsque vous appelez le point de terminaison rollUp, fournissez un corps de requête JSON contenant l'intervalle semi-ouvert range (startTime inclus, endTime exclu) et windowSize. Gardez à l'esprit les exigences windowSize suivantes :
- La durée
windowSizedoit être d'au moins une seconde ("1s"). L'API rejette les durées inférieures à une seconde, nulles ou négatives avec une erreur400 Bad Request(INVALID_ROLLUP_WINDOW). - Pour éviter une répartition inégale des données agrégées entre les sous-buckets, choisissez un
windowSizeégal ou supérieur à la résolution de stockage sous-jacente du type de données (par exemple,"60s"pour des intervalles de pas d'une minute). Pour en savoir plus, consultez Fenêtre de cumul et résolution de stockage.
Par exemple, la requête suivante regroupe le nombre de pas par intervalles d'une minute (60s) :
Requête
POST https://health.googleapis.com/v4/users/me/dataTypes/steps/dataPoints:rollUp
Authorization: Bearer access-token
Accept: application/json

{
  "range": {
    "startTime": "2026-02-17T17:00:00Z",
    "endTime": "2026-02-17T17:59:59Z"
  },
  "windowSize": "60s"
}
Réponse
{
  "rollupDataPoints": [
    {
      "startTime": "2026-02-17T17:55:00Z",
      "endTime": "2026-02-17T17:56:00Z",
      "steps": {
        "countSum": "72"
      }
    },
    {
      "startTime": "2026-02-17T17:54:00Z",
      "endTime": "2026-02-17T17:55:00Z",
      "steps": {
        "countSum": "85"
      }
    },
...
  ]
}
Agréger sur plusieurs jours calendaires
Utilisez le point de terminaison dailyRollUp pour agréger les données sur un seul jour calendaire ou sur plusieurs jours (windowSizeDays). Indiquez l'heure civile fermée-ouverte range (start et end) dans le corps de la requête. Selon le type de données, le point de terminaison renvoie des valeurs agrégées telles que la somme ou la moyenne sur chaque fenêtre civile.
Étant donné que dailyRollUp fonctionne sur l'heure civile en utilisant les décalages UTC enregistrés avec chaque point de données, il rapproche automatiquement les longueurs de jour variables causées par les transitions d'heure d'été ou les déplacements entre les fuseaux horaires.
Par exemple, la requête suivante agrège le nombre de pas sur un seul jour civil (windowSizeDays: 1) :
Requête
POST https://health.googleapis.com/v4/users/me/dataTypes/steps/dataPoints:dailyRollUp
Authorization: Bearer access-token
Accept: application/json

{
  "range": {
    "start": {
      "date": {
        "year": 2026,
        "month": 2,
        "day": 26
      },
      "time": {
        "hours": 0,
        "minutes": 0,
        "seconds": 0,
        "nanos": 0
      }
    },
    "end": {
      "date": {
        "year": 2026,
        "month": 2,
        "day": 26
      },
      "time": {
        "hours": 23,
        "minutes": 59,
        "seconds": 59,
        "nanos": 0
      }
    }
  },
  "windowSizeDays": 1
}
Réponse
{
  "rollupDataPoints": [
    {
      "civilStartTime": {
        "date": {
          "year": 2026,
          "month": 2,
          "day": 26
        },
        "time": {}
      },
      "civilEndTime": {
        "date": {
          "year": 2026,
          "month": 2,
          "day": 26
        },
        "time": {
          "hours": 23,
          "minutes": 59,
          "seconds": 59
        }
      },
      "steps": {
        "countSum": "3822"
      }
    }
  ]
}
Agréger par famille de sources de données
rollUp et dailyRollUp acceptent tous deux un champ dataSourceFamily facultatif dans le corps de la requête JSON pour limiter l'agrégation à des groupes sources spécifiques :
- L'option
users/me/dataSourceFamilies/all-sources(par défaut) agrège les données rapprochées de toutes les sources propriétaires et tierces enregistrées. - L'option
users/me/dataSourceFamilies/google-wearablesregroupe les données enregistrées par les appareils connectés Google et Fitbit, à l'exclusion des données enregistrées manuellement et estimées par le téléphone. - L'option
users/me/dataSourceFamilies/google-sourcesregroupe les données provenant de sources first party Google et Fitbit, y compris les bracelets d'activité, Santé Connect et les entrées manuelles dans les applications first party.
Pour connaître toutes les exigences concernant les paramètres et obtenir des exemples de requêtes et de réponses, consultez Filtrer par famille de sources de données dans le guide "Filtrer les données".
Période de cumul et résolution de stockage
Bien que le point de terminaison rollUp accepte n'importe quel windowSize d'une seconde ("1s") ou plus, différents types de données enregistrent et conservent les mesures à des taux d'échantillonnage ou des durées d'intervalle différents dans l'espace de stockage sous-jacent. Par exemple, les métriques d'activité physique des accessoires connectés, telles que steps, distance, active-minutes et active-energy-burned, sont généralement enregistrées à des intervalles d'une minute (60s).
Le tableau suivant liste les résolutions de stockage sous-jacentes et les valeurs windowSize minimales recommandées pour les types de données courants :
| Résolution du stockage | Minimum recommandé : windowSize |
Types de données |
|---|---|---|
1 seconde (1s) |
"1s" |
heart-rate |
1 minute (60s) |
"60s" |
active-energy-burned, active-minutes, active-zone-minutes, altitude, calories-in-heart-rate-zone, distance, floors, steps, time-in-heart-rate-zone, total-calories |
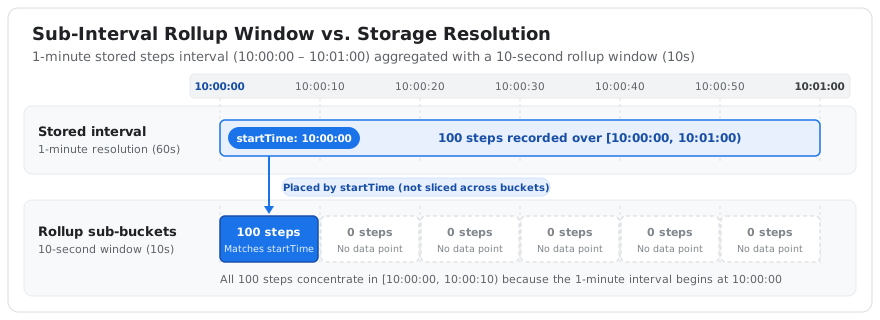
Lors de l'agrégation des types de données d'intervalle, le point de terminaison rollUp place chaque point de données enregistré dans le bucket contenant le startTime du point de données. L'API ne segmente pas, n'interpole pas et ne distribue pas les données d'intervalle entre les buckets de sous-intervalles.
Si vous spécifiez un windowSize inférieur à l'intervalle de stockage des données sous-jacent (par exemple, en demandant une fenêtre de 10 secondes pour steps stocké à des intervalles d'une minute) :
- Le premier sous-bucket correspondant à l'intervalle
startTime(par exemple, de10:00:00à10:00:10) reçoit le nombre cumulé de la minute entière (par exemple, les 100 pas enregistrés pour cette minute). - Les sous-buckets restants de cette même minute (
10:00:10à10:00:20,10:00:20à10:00:30, etc.) ne reçoivent aucun point de données, car aucun intervalle ne commence dans ces fenêtres.
Cela produit des données irrégulières, où la valeur de l'intervalle entier est concentrée dans la première sous-fenêtre, comme illustré dans la figure 1.
Pour obtenir des agrégats significatifs et répartis de manière uniforme, définissez toujours windowSize sur une durée égale ou supérieure à la résolution de stockage sous-jacente du type de données cible (par exemple, "60s" ou plus pour steps). Pour connaître la résolution de stockage et la fenêtre de cumul minimale recommandée pour chaque type de données, consultez la documentation de référence sur les types de données de l'API Google Health.
Mise en buckets lorsque la plage n'est pas un multiple de la taille de la fenêtre
Si la plage demandée n'est pas un multiple exact de windowSize (ou windowSizeDays), le dernier bucket chronologique est tronqué au point de terminaison supérieur de la plage et couvre une durée plus courte que la taille de la fenêtre. L'API accepte votre requête sans modification et n'effectue pas d'arrondi, de décalage horaire ni d'interpolation de données.
Pour couvrir l'intégralité de la plage demandée, l'API utilise la division par plafond pour calculer le nombre total de fenêtres d'agrégation :
Number of windows = ceiling(Range duration / Window size)
Chaque bucket commence de manière séquentielle à partir du début de votre plage. Si l'ajout d'une autre fenêtre de taille standard dépasse l'heure de fin demandée, la fenêtre finale est tronquée (limitée) à l'heure de fin de la plage.
Fonctionnement de la segmentation
Lorsque vous demandez des cumuls avec des plages non divisibles, l'API applique les règles suivantes :
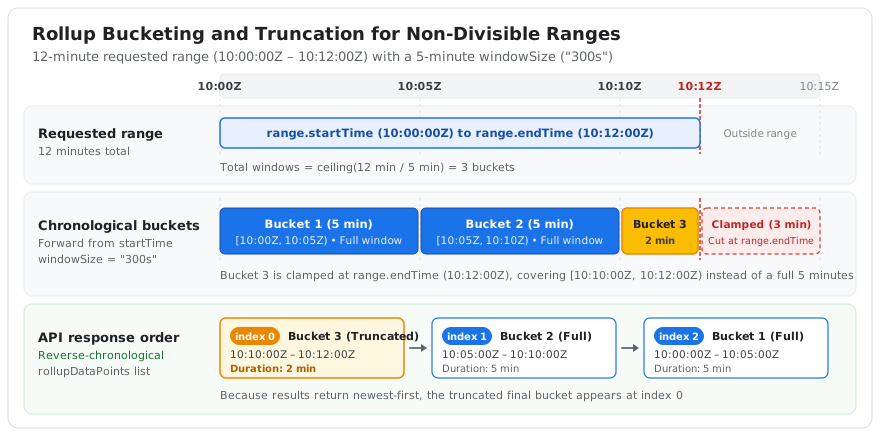
- La segmentation commence au début de la plage demandée (
range.startTimeourange.start) et progresse en fonction de la taille de la fenêtre (windowSizeouwindowSizeDays). - Le dernier bucket chronologique est limité à la fin de la plage demandée (
range.endTimeourange.end), couvrant une durée plus courte que la taille de la fenêtre demandée. - Les objets
RollupDataPointouDailyRollupDataPointrenvoyés incluent leurs propres codes temporels de début et de fin explicites, que vous pouvez utiliser pour inspecter la durée réelle du bucket tronqué. - Étant donné que l'API renvoie les données de cumul dans l'ordre chronologique inverse (les plus récentes en premier), le bucket chronologique final (le bucket tronqué) apparaît comme le premier élément (
index 0) de la liste renvoyée.
La figure 2 illustre comment l'API regroupe une plage non divisible à partir de range.startTime, limite le bucket final à range.endTime et renvoie les buckets obtenus dans l'ordre chronologique inverse.
Exemple de plage de 12 minutes avec une fenêtre de 5 minutes
Supposons qu'un client demande un cumul sur une période de 12 minutes avec un windowSize ("300s") de 5 minutes :
- La valeur de
range.startTimeest10:00:00Z. - La valeur
range.endTimeest10:12:00Z, pour une durée totale de 12 minutes. - La valeur
windowSizeest"300s"(5 minutes).
Étant donné que 12 minutes n'est pas un multiple exact de 5 minutes (12 = 5 * 2 + 2), l'API calcule le nombre de fenêtres comme suit : ceiling(12 / 5) = 3. Cela produit trois buckets chronologiques :
| Bucket | Intervalle | Durée | État de la période |
|---|---|---|---|
| Bin 1 | [10:00:00Z, 10:05:00Z) |
5 minutes | Plein écran |
| Bin 2 | [10:05:00Z, 10:10:00Z) |
5 minutes | Plein écran |
| Bin 3 | [10:10:00Z, 10:12:00Z) |
2 minutes | Tronqué à range.endTime |
Impact sur les valeurs agrégées
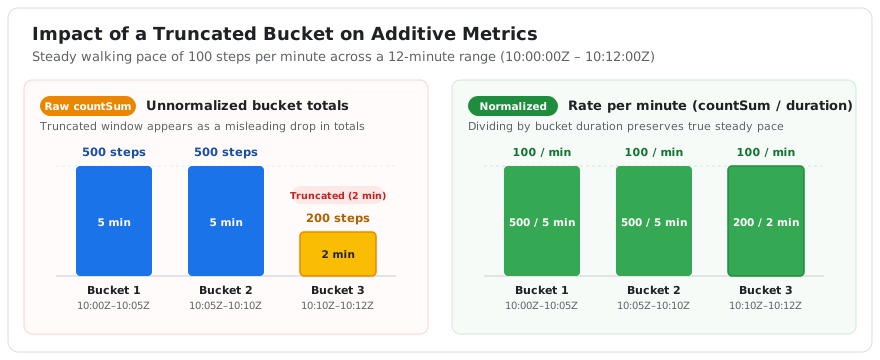
Étant donné que la dernière fenêtre chronologique est plus courte, les métriques additives (telles que la somme ou le nombre d'étapes) sont plus faibles dans le bucket tronqué en raison de la période plus courte.
Si un utilisateur marche à un rythme régulier de 100 pas par minute pendant toute cette période de 12 minutes, les buckets contiennent les totaux suivants :
- La tranche 1 (
10:00:00Zà10:05:00Z) enregistre 500 pas (5 minutes à 100 pas par minute). - Le segment 2 (
10:05:00Zà10:10:00Z) enregistre 500 pas (5 minutes à 100 pas par minute). - Le bucket 3 (
10:10:00Zà10:12:00Z) enregistre 200 pas (2 minutes à 100 pas par minute).
Le nombre de pas inférieur (200 pas) dans le bucket 3 est dû à la durée de deux minutes de la fenêtre tronquée, et non à une baisse de l'activité de l'utilisateur. Lorsque vous tracez ou analysez ces données, normalisez les nombres en utilisant la durée explicite de chaque bucket pour éviter de présenter une baisse trompeuse de l'activité des utilisateurs.
La figure 3 compare les totaux bruts de pas additifs (countSum) aux taux normalisés par durée dans les trois buckets.
Exemple de réponse de l'API montrant l'ordre
Étant donné que l'API renvoie les résultats dans l'ordre chronologique inverse, le bucket tronqué apparaît comme premier élément de la liste renvoyée :
{
  "rollupDataPoints": [
    {
      "startTime": "2026-08-20T10:10:00Z",
      "endTime": "2026-08-20T10:12:00Z",
      "steps": {
        "countSum": "200"
      }
    },
    {
      "startTime": "2026-08-20T10:05:00Z",
      "endTime": "2026-08-20T10:10:00Z",
      "steps": {
        "countSum": "500"
      }
    },
    {
      "startTime": "2026-08-20T10:00:00Z",
      "endTime": "2026-08-20T10:05:00Z",
      "steps": {
        "countSum": "500"
      }
    }
  ]
}