

Trabalhar com dados na API Google Health é basicamente um ciclo de sincronização de dados entre o armazenamento de dados da API Google Health na nuvem e seu próprio app ou armazenamento de dados de back-end. No entanto, esse ciclo pode assumir formas diferentes dependendo de vários fatores:
- Você está gravando dados na API Google Health? Só quer ler? Ou as duas coisas?
- O armazenamento de dados é local no app ou dispositivo? Ou na sua própria nuvem?
- Você precisa sincronizar dados da API Google Health entre o app do usuário e um dispositivo wearable? Com que frequência você sincroniza dispositivos?
- Com que tipos de dados você está trabalhando? Contagens básicas? Unidades de medida? Séries com diferentes taxas de amostragem?
- Você planeja ler dados enquanto o app está em segundo plano?
- Você planeja trabalhar com dados históricos gravados antes de o app receber permissões do usuário?
Para entender como tudo isso funciona, confira o ciclo de vida de sincronização da API Google Health. Há duas versões desse ciclo de vida: padrão (leitura e gravação) e somente leitura.
O ciclo de vida de sincronização padrão
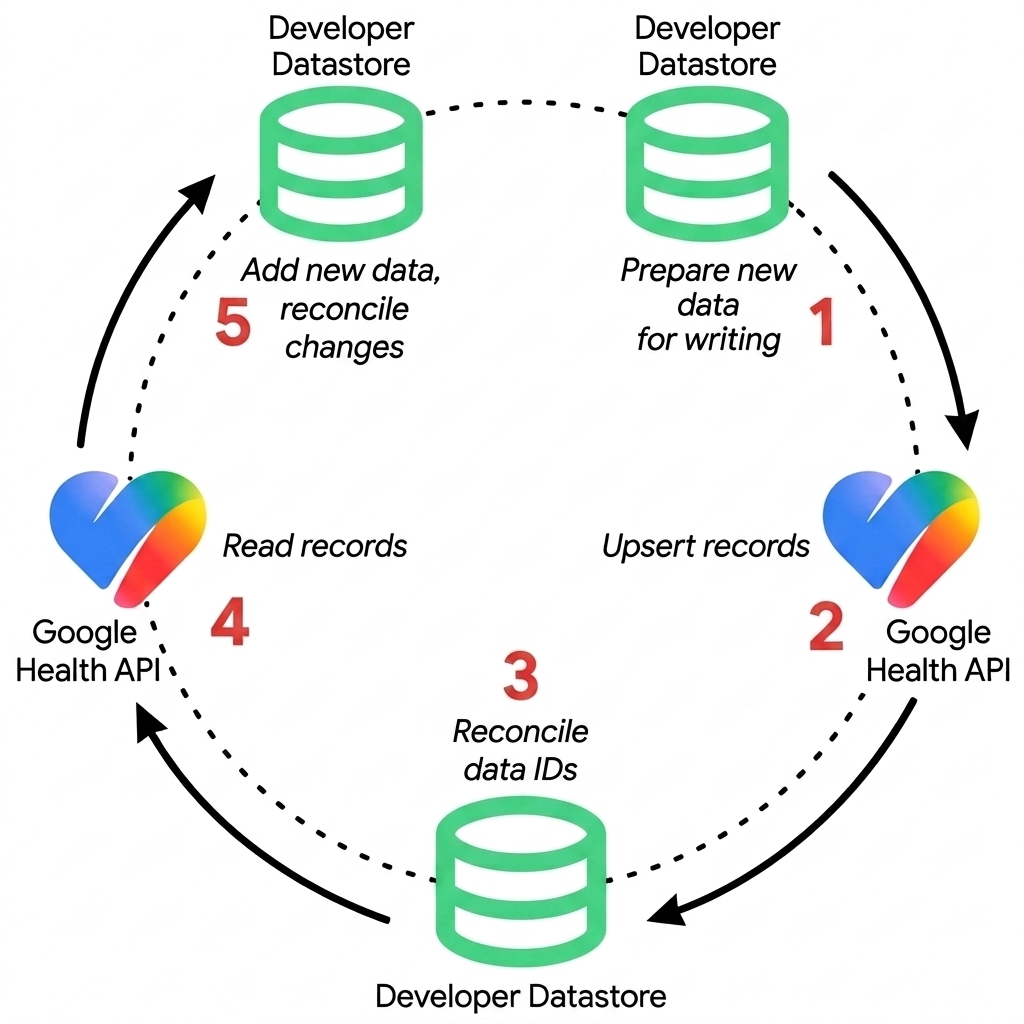
A integração com a API Google Health significa copiar dados para um app ou repositório de dados de back-end. Para facilitar o uso nesta documentação, vamos chamar esse datastore de datastore do desenvolvedor.
"Copiar" aqui pode substituir qualquer atividade discreta, como leitura da API Google Health (copiar para o repositório de dados do desenvolvedor) ou gravação na API Google Health (copiar para a API Google Health). Realizar essas ações repetidamente em uma ordem específica é o ciclo de vida da sincronização.
A Figura 1 ilustra o ciclo de vida de sincronização padrão que envolve operações de leitura e gravação, sem considerar nenhum dos fatores mencionados anteriormente.
Gravação
- Preparar novos dados para gravação: transfira dados de um dispositivo ou
app externo e formate pontos de dados em representações JSON compatíveis com os tipos de dados da API Google
Health. No momento, a API Health não aceita IDs personalizados atribuídos pelo cliente para gravações. Esses IDs podem ser fornecidos em um
POST, mas são ignorados. - Inserir ou atualizar registros: envie pontos de dados para a API Google Health usando
endpoints REST. Use
POSTpara criar registros ePATCHpara inserir e atualizar registros atuais. Os IDs necessários para a operaçãoPATCHvieram de uma operaçãoPOSTanterior (próxima etapa em um ciclo anterior). - Processar IDs de recursos retornados: ao usar IDs gerados pelo servidor, extraia
e mantenha o recurso
nameou ID retornado pelo servidor no seu repositório de dados do desenvolvedor para permitir atualizações (PATCH) ou exclusões (DELETE) futuras. Consulte Estratégias de identificação para mais informações sobre os dois tipos.
Ler
- Ler registros: extraia novos dados e mudanças nos dados atuais da
API Google Health usando endpoints REST (
GETcom parâmetros de consultafiltere paginaçãopageTokenou endpoints de agregação comorollUpedailyRollUp) ou receba notificações em tempo real usando assinaturas de webhook (projects.subscribers). Uma notificação indica apenas que novos dados estão disponíveis, não quais são os dados reais. - Conciliar o datastore do desenvolvedor: concilie os dados novos e atualizados com o datastore do desenvolvedor. Dispositivos conectados podem produzir intervalos sobrepostos durante as sincronizações. Para saber como a API Google Health resolve esses problemas, consulte Timestamps de intervalo e sincronização de dispositivos conectados.
Esse ciclo se repete em intervalos adequados de acordo com as necessidades específicas de dispositivos ou apps externos. Essa é geralmente a ordem recomendada para sincronizar dados entre seu próprio repositório de dados e a API Google Health.
Estratégias de identificação
Se você pretende gravar dados na API Google Health, antes de criar sua integração com as APIs Google Health, escolha uma estratégia de identificação de recursos ao criar pontos de dados (a unidade básica de dados).
No momento, a API Health não aceita IDs atribuídos pelo cliente para gravações.
Esses IDs podem ser fornecidos em um POST, mas são ignorados. Os detalhes dessa opção são fornecidos aqui para fins informativos.
- IDs gerados pelo servidor (opção padrão): o cliente envia dados sem um ID, e o back-end da API Google Health gera e retorna um identificador de sistema exclusivo.
- IDs personalizados atribuídos pelo cliente (por AIP-133, ainda não compatível): o app cliente gera um identificador exclusivo (por exemplo, um UUID ou uma chave primária de banco de dados local) e o fornece no caminho do recurso durante a criação.
A tabela a seguir compara as duas estratégias de identificação para ajudar você a escolher a abordagem certa para sua integração:
| Recurso | IDs gerados pelo servidor | IDs personalizados atribuídos pelo cliente |
|---|---|---|
| Geração de ID | O servidor gera um ID do sistema aleatório durante a execução de POST. |
O cliente gera um ID estável localmente (UUID v4 / PK interno) antes da gravação. |
| Caminho do recurso | .../dataPoints/{server_id} (retornado na resposta) |
.../dataPoints/{custom_id} |
| Etapa local pós-gravação | Obrigatório. É necessário armazenar o server_id retornado no banco de dados local para permitir atualizações/exclusões futuras. |
Nenhum. O app já é proprietário do ID. |
| Tabela de mapeamento de IDs | Obrigatório. O cliente precisa manter um mapeamento bidirecional
(local_id ↔ server_id). |
Não é necessário. O cliente usa a própria chave primária diretamente. |
| Comportamento de nova tentativa (rede fraca) | Risco de duplicatas. Tentar novamente um POST
com tempo esgotado cria um registro duplicado com um novo ID do servidor. |
Seguro e idempotente. Tentar novamente POST com o mesmo
custom_id evita a criação de duplicados (retorna 409
ALREADY_EXISTS). |
| Suporte à sincronização off-line | Limitado. É necessário aguardar a resposta do servidor para receber os IDs de recursos oficiais antes de fazer referência a eles. | Completo. As entidades podem ser criadas e alteradas off-line com IDs estáveis e sincronizadas sem problemas quando reconectadas. |
| Restrições de formato | Processado totalmente pelo servidor. | Precisa seguir ^[a-z0-9-]{4,63}$ (4 a 63 caracteres alfanuméricos minúsculos e hífens). |
| Quando escolher |
Escolha IDs gerados pelo servidor se:
|
Escolha IDs personalizados se:
|
O ciclo de vida da sincronização somente leitura
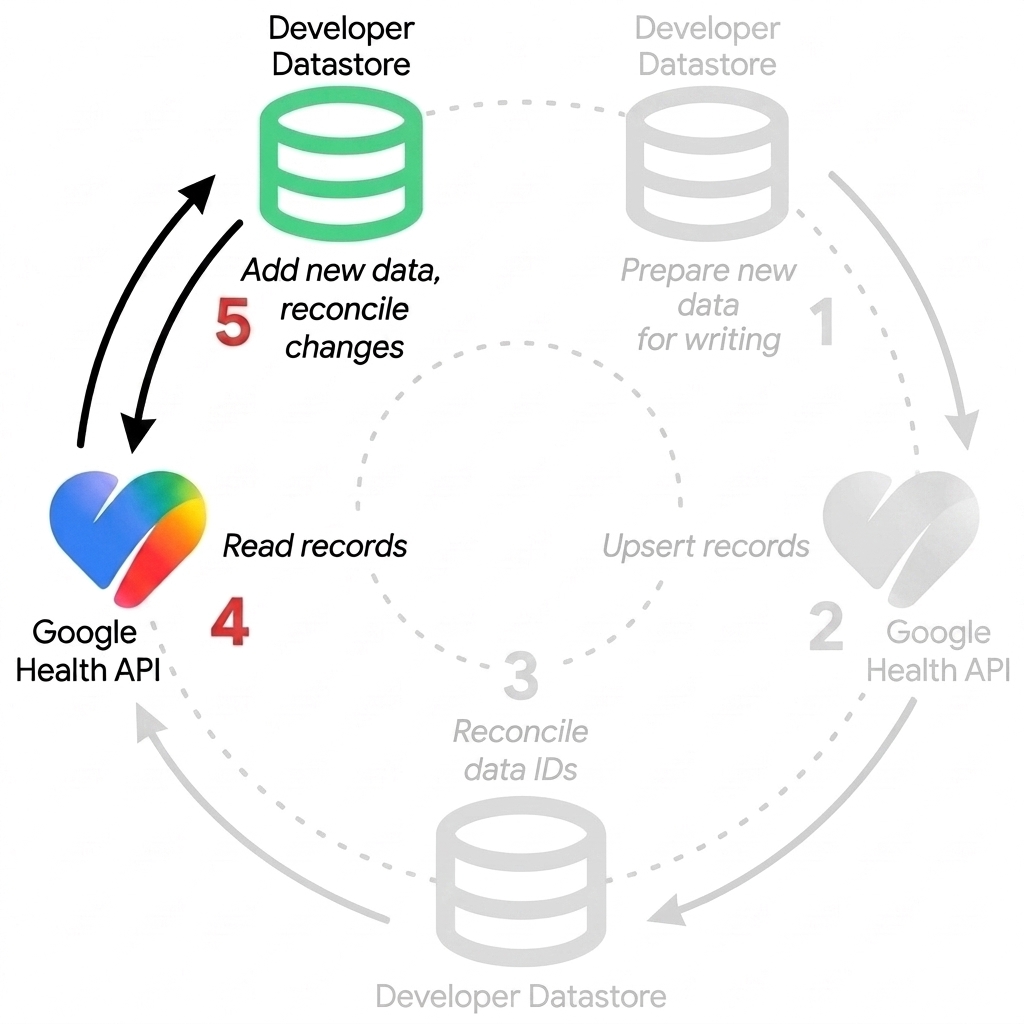
Um app que pretende apenas ler dados da API Google Health precisa copiar os dados para o repositório de dados do desenvolvedor e processar a parte de conciliação do ciclo de vida.
As mesmas tarefas abordadas na seção Ler se aplicam aqui.
A Figura 2 ilustra o ciclo de vida somente leitura.
Carimbos de data/hora de intervalo e sincronização de dispositivos conectados
Os dados de intervalo representam medições coletadas durante um período, como passos, frequência cardíaca ou sessões de exercícios. Já as medições pontuais incluem entradas manuais, como um registro de alimentos ou a leitura de uma balança. Os dados de intervalo geralmente são originados da sincronização de dispositivos conectados, como smartwatches e monitores de atividade física.
Os carimbos de data/hora de intervalo (startTime e endTime) introduzem comportamentos exclusivos ao trabalhar com dados de intervalo. Esta seção explica por que ocorrem intervalos sobrepostos e compara os endpoints list e reconcile.
Intervalos sobrepostos de dispositivos conectados
Dispositivos conectados, como trackers Fitbit e o Google Pixel Watch, coletam continuamente leituras biométricas de alta frequência enquanto são usados. Depois que um dispositivo sincroniza pontos de dados com o Google Health, ele não altera retroativamente os registros existentes. Os carimbos de data/hora de intervalo armazenados permanecem inalterados.
No entanto, antes dos ciclos de sincronização subsequentes, os algoritmos no dispositivo geralmente reinterpretam a telemetria bruta do sensor. O dispositivo reclassifica as leituras coletadas nas horas anteriores. Quando o dispositivo sincronizar novamente, ele vai fazer upload de novos pontos de dados. Os limites de início e fim podem se sobrepor a intervalos armazenados anteriormente.
Por exemplo, considere um usuário usando um smartwatch cujos dados de atividade são sincronizados em dois lotes consecutivos:
- Durante a primeira sincronização, o dispositivo faz upload de um ponto de dados que abrange
10:00:00Za10:14:59Z. - Após o recálculo no dispositivo, uma segunda sincronização faz upload de outro ponto de dados que abrange
10:14:00Za10:28:59Z.
Os dois registros são armazenados de forma independente no back-end do Google Health. Como resultado, os dois pontos de dados abrangem o intervalo de 10:14:00Z a 10:14:59Z.
Isso produz uma sobreposição de 59 segundos ao consultar registros brutos.
Comparar lista e conciliar endpoints
É possível processar esses intervalos sobrepostos usando o endpoint list ou reconcile. Escolha o endpoint que corresponda aos requisitos do seu aplicativo:
| Recurso | Endpoint list |
Endpoint reconcile |
|---|---|---|
| Método HTTP | GET https://health.googleapis.com/v4/users/me/dataTypes/<var>dataType</var>/dataPoints |
GET https://health.googleapis.com/v4/users/me/dataTypes/<var>dataType</var>/dataPoints:reconcile |
| Comportamento de sobreposição | Retorna todos os registros armazenados como enviados sem remoção de duplicação. Quando os intervalos se sobrepõem, os dois registros são retornados. | Resolve conflitos e remove registros duplicados em dispositivos e sessões de sincronização em um único fluxo contínuo. |
| Vantagens | Fornece uma trilha de auditoria completa e não modificada de todos os registros enviados por cada dispositivo e lote de sincronização. | Simplifica a renderização da linha do tempo e os cálculos de duração ao processar automaticamente intervalos sobrepostos e conflitos multidispositivo. |
| Desvantagens | O aplicativo é responsável por detectar e resolver intervalos sobrepostos, conflitos multidispositivo e períodos sem o relógio no pulso. | Os registros subordinados sobrepostos são omitidos da resposta. Portanto, não é possível auditar lotes de sincronização de dispositivos individuais isoladamente. |
O endpoint reconcile foi projetado para desenhar interfaces de usuário, renderizar
cronogramas de atividades e calcular totais de duração não sobrepostos. Ele resolve intervalos conflitantes de sessões de sincronização redefinidas. Ele também reconcilia
a atividade registrada simultaneamente em vários dispositivos, como um relógio e um
smartphone.
A conciliação resolve sessões conflitantes selecionando o registro
autoritário em vez de sintetizar uma união de tempo artificial. Por exemplo, ela não mescla 11:00:00Z para 11:30:00Z e 11:20:00Z para 11:50:00Z em 11:00:00Z para 11:50:00Z. A resposta conciliada retorna o ponto de dados vencedor com o intervalo gravado original. Isso preserva a integridade da telemetria e das métricas medidas dessa sessão.
A Figura 3 ilustra como o endpoint reconcile processa sessões sobrepostas.
Ele seleciona o registro oficial em vez de criar uma união de tempo artificial.

O guia do Endpoints oferece exemplos completos de solicitações e respostas. Para comparar registros list brutos com a saída reconcile, consulte Receber uma visualização conciliada dos dados de intervalo.
O endpoint list foi projetado para diagnósticos de dispositivos e auditorias de dados. Use-o
quando seu fluxo de trabalho exigir a inspeção de registros não modificados conforme enviados por cada
dispositivo. Ao consultar com list, a lógica do cliente precisa processar todas as sobreposições de intervalo nos dados brutos.
Mutabilidade de carimbo de data/hora e atualizações de proprietário
Os dispositivos conectados não modificam de forma retroativa os carimbos de data/hora armazenados durante os ciclos normais
de sincronização. No entanto, os carimbos de data/hora de intervalo (startTime e endTime) não são universalmente imutáveis em todas as fontes de dados. Somente o criador ou proprietário original de um registro pode modificar os campos dele. Outros aplicativos não podem editar pontos de dados que não foram criados por eles.
Um aplicativo proprietário pode usar o
endpoint patch para
atualizar os registros atuais. Isso inclui modificar os carimbos de data/hora de início ou término.
Para um exemplo de atualização de carimbos de data/hora com PATCH, consulte
Atualizar carimbos de data/hora de intervalo para dados atuais
no guia do Endpoints.
Da mesma forma, os pontos de dados sincronizados de plataformas externas, como a Conexão Saúde ou apps parceiros, herdam atualizações da fonte original. Quando o aplicativo de origem modifica um registro, essas atualizações são propagadas para o Google Health.