

Google Health API でのデータの操作は、クラウド内の Google Health API データストアと独自のアプリまたはバックエンド データストアの間でデータを同期するサイクルが基本となります。ただし、このサイクルはさまざまな要因によって異なる形式になることがあります。
- Google Health API にデータを書き込んでいますか?読み取り専用ですか?あるいは両方を行うべきか?
- データストアはアプリまたはデバイスのローカルにありますか?それとも、独自のクラウドですか?
- ユーザーのアプリとウェアラブル デバイスの間で Google Health API のデータを同期する必要がありますか?デバイスを同期する頻度はどのくらいですか?
- どのような種類のデータを扱っていますか?Basic のカウントはありますか?測定単位は? サンプリング レートが異なる系列はありますか?
- アプリがバックグラウンドにあるときにデータを読み取る予定はありますか?
- アプリがユーザーの権限を取得する前に記録された過去のデータを処理する予定はありますか?
これらがどのように連携するかについては、Google Health API の同期ライフサイクルをご覧ください。このライフサイクルには、標準(読み取りと書き込み)と読み取り専用の 2 つのバージョンがあります。
標準同期のライフサイクル
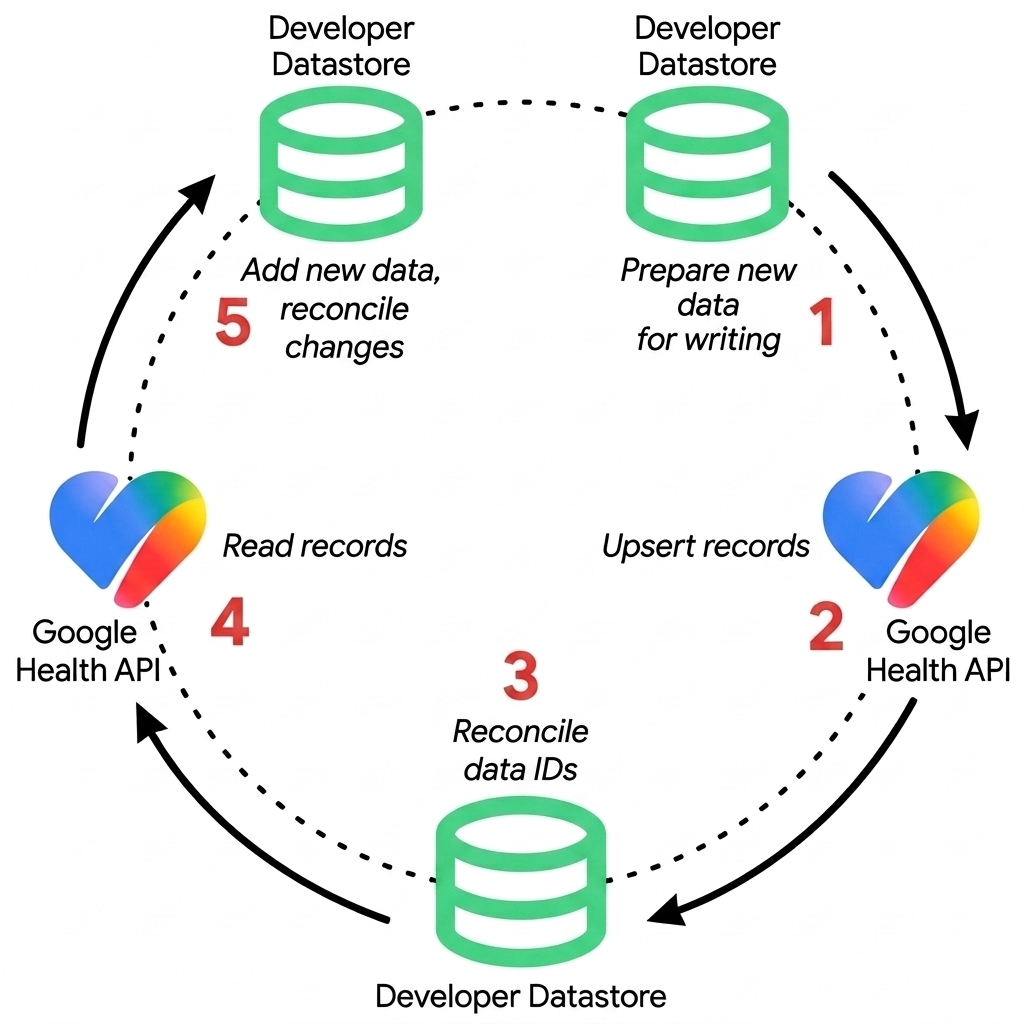
Google Health API との統合とは、アプリまたはバックエンド データストアにデータをコピーすることです。このドキュメントでは、このデータストアをデベロッパー データストアと呼びます。
ここで「コピー」は、Google Health API からの読み取り(デベロッパー データストアへのコピー)や Google Health API への書き込み(Google Health API へのコピー)など、個別の任意のアクティビティに置き換えることができます。これらのアクションを特定の順序で繰り返し実行することが同期のライフサイクルです。
図 1 は、前述の要因を考慮しない、読み取りと書き込みのオペレーションを含む標準の同期ライフサイクルを示しています。
書き込み
- 書き込み用の新しいデータを準備する - 外部デバイスまたはアプリからデータを転送し、Google Health API のデータ型と互換性のある JSON 表現にデータポイントをフォーマットします。現時点では、Health API で書き込み用のカスタム クライアント割り当て ID はサポートされていません。このような ID は
POSTで提供されることがありますが、無視されます。 - レコードを更新または挿入する - REST エンドポイントを使用して、データポイントを Google Health API に送信します。レコードの作成には
POSTを使用し、既存のレコードの挿入と更新にはPATCHを使用します。PATCHオペレーションに必要な ID は、前のPOSTオペレーション(前のサイクルの次のステップ)から取得されます。 - 返されたリソース ID を処理する - サーバー生成 ID を使用する場合は、サーバーから返されたリソース
nameまたは ID をデベロッパー データストアで抽出して永続化し、今後の更新(PATCH)または削除(DELETE)を可能にします。2 種類の ID について詳しくは、識別戦略をご覧ください。
読み取り
- レコードの読み取り - REST エンドポイント(
GETとfilterクエリ パラメータ、pageTokenページネーション、rollUpやdailyRollUpなどの集計エンドポイント)を使用して、Google Health API から新しいデータと既存のデータへの変更を取得するか、Webhook サブスクリプション(projects.subscribers)を使用してリアルタイム通知を受信します。通知は、新しいデータが利用可能であることを示すだけで、実際のデータの内容は示しません。 - デベロッパー データストアを調整する - 新しいデータと更新されたデータをデベロッパー データストアに調整します。接続されたデバイスは、同期中に重複する間隔を生成する可能性があります。Google Health API がこれらの問題を解決する方法については、間隔のタイムスタンプと接続されたデバイスの同期をご覧ください。
このサイクルは、外部デバイスやアプリの特定のニーズに応じて適切な間隔で繰り返されます。通常、独自のデータストアと Google Health API の間でデータを同期する場合は、この順序をおすすめします。
識別戦略
Google Health API にデータを書き込む場合は、Google Health API との統合を構築する前に、データポイント(データの基本単位)の作成時にリソース識別戦略を選択する必要があります。
現時点では、Health API で書き込み用のクライアント割り当て ID はサポートされていません。このような ID は POST で提供されることがありますが、無視されます。このオプションの詳細については、情報提供のみを目的としてこちらに記載しています。
- サーバー生成 ID(デフォルト オプション): クライアントは ID なしでデータを送信し、Google Health API バックエンドは一意のシステム ID を生成して返します。
- クライアント割り当てのカスタム ID(AIP-133 に準拠、まだサポートされていません): クライアント アプリは一意の識別子(UUID やローカル データベースの主キーなど)を生成し、作成時にリソースパスで提供します。
次の表に、2 つの識別戦略を比較します。この表を参考にして、統合に適したアプローチを選択してください。
| 機能 | サーバー生成 ID | クライアント割り当てのカスタム ID |
|---|---|---|
| ID の生成 | サーバーは POST の実行中にランダムなシステム ID を生成します。 |
クライアントは、書き込み前にローカルで安定した ID(UUID v4 / 内部 PK)を生成します。 |
| リソースパス | .../dataPoints/{server_id}(レスポンスで返される) |
.../dataPoints/{custom_id} |
| Post-Write Local Step | 必須。今後の更新や削除を可能にするため、返された server_id をローカル DB に保存する必要があります。 |
なし。アプリがすでに ID を所有しています。 |
| ID マッピング テーブル | 必須。クライアントは双方向マッピング(local_id ↔ server_id)を維持する必要があります。 |
不要。クライアントが独自の主キーを直接使用します。 |
| 再試行の動作(ネットワークが弱い場合) | 重複のリスク。タイムアウトした POST を再試行すると、新しいサーバー ID を持つ重複レコードが作成されます。 |
安全でべき等。同じ custom_id で POST を再試行すると、重複作成が防止されます(409
ALREADY_EXISTS が返されます)。 |
| オフライン同期のサポート | 上限あり。公式リソース ID を参照する前に、サーバーの応答を待って取得する必要があります。 | フル。エンティティは、安定した ID を使用してオフラインで作成および変更し、再接続時にシームレスに同期できます。 |
| 形式の制約 | サーバーによって完全に処理されます。 | ^[a-z0-9-]{4,63}$(4 ~ 63 文字の小文字の英数字とハイフン)に従う必要があります。 |
| 選択するタイミング |
サーバー生成 ID を選択する条件:
|
次のような場合はカスタム ID を選択します。
|
読み取り専用同期のライフサイクル
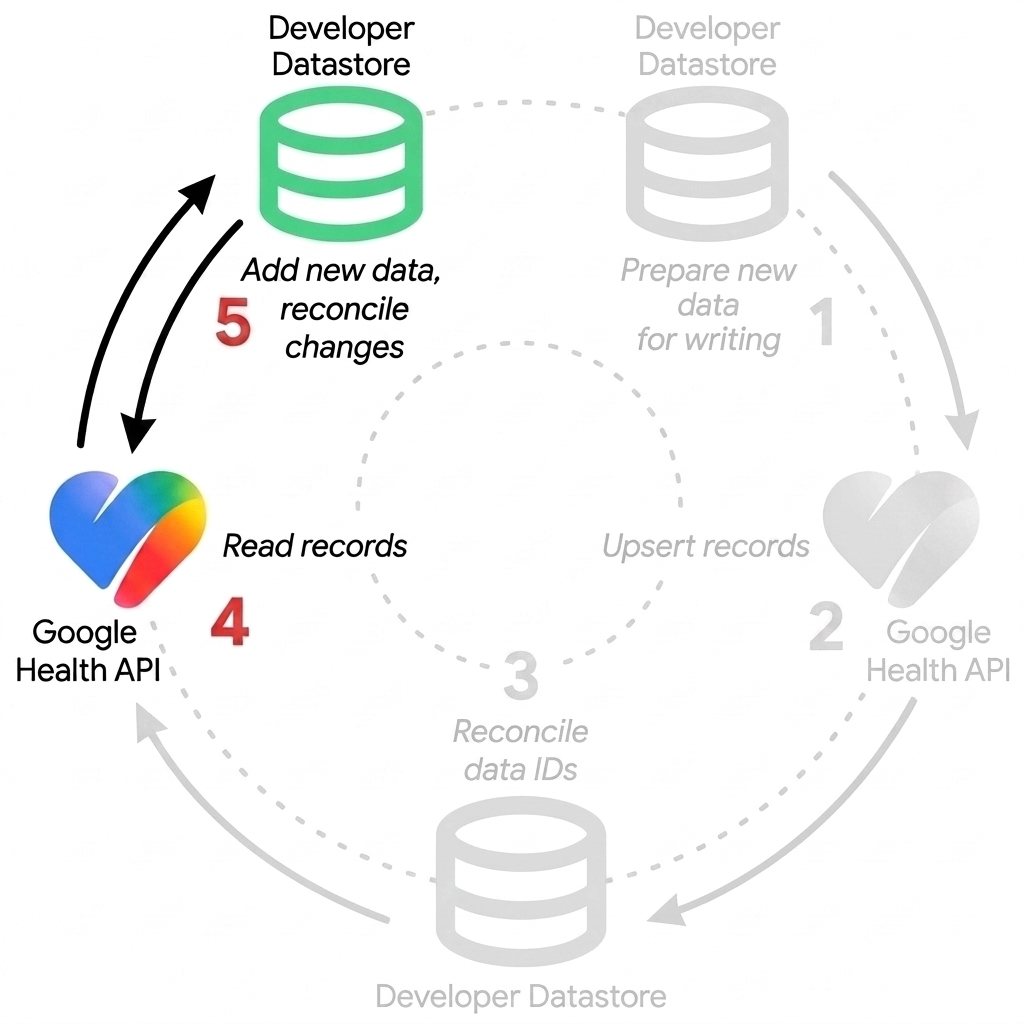
Google Health API からの読み取りのみを目的とするアプリは、データをデベロッパー データストアにコピーし、ライフサイクルの調整部分を処理する必要があります。
読み取りセクションで説明したタスクが、ここでも適用されます。
図 2 は、読み取り専用のライフサイクルを示しています。
インターバルのタイムスタンプとコネクテッド デバイスの同期
インターバル データは、歩数、心拍数、エクササイズ セッションなど、一定期間にわたって収集された測定値を表します。一方、特定の時点での測定には、食事の記録や体重計の測定値などの手動入力が含まれます。通常、インターバル データはスマートウォッチやフィットネス トラッカーなどの接続デバイスの同期から取得されます。
間隔タイムスタンプ(startTime と endTime)は、間隔データを操作する際に固有の動作を導入します。このセクションでは、重複する間隔が発生する理由と、list エンドポイントと reconcile エンドポイントの比較について説明します。
コネクテッド デバイスの重複する間隔
Fitbit トラッカーや Google Pixel Watch などの接続デバイスは、装着中に高頻度の生体認証データを継続的に収集します。デバイスがデータポイントを Google Health に同期した後、既存のレコードが遡及的に変更されることはありません。保存されている間隔のタイムスタンプは変更されません。
ただし、後続の同期サイクルの前に、デバイス上のアルゴリズムがセンサーの生テレメトリーを再解釈することがよくあります。デバイスは、過去数時間にわたって収集された測定値を再分類します。デバイスが再度同期されると、新しいデータポイントがアップロードされます。開始境界と終了境界は、以前に保存された間隔と重複する可能性があります。
たとえば、スマートウォッチを装着しているユーザーのアクティビティ データが 2 つの連続するバッチで同期されるとします。
- 初回同期時に、デバイスは
10:00:00Zをカバーするデータポイントを10:14:59Zにアップロードします。 - デバイス上の再計算に続いて、2 回目の同期で
10:14:00Zをカバーする別のデータポイントが10:28:59Zにアップロードされます。
両方のレコードは Google Health バックエンドに個別に保存されます。その結果、両方のデータポイントが 10:14:00Z から 10:14:59Z までの間隔をカバーします。これにより、未加工のレコードをクエリするときに 59 秒の重複が発生します。
リストを比較してエンドポイントを調整する
これらの重複する間隔は、list エンドポイントまたは reconcile エンドポイントを使用して処理できます。アプリケーションの要件に合ったエンドポイントを選択します。
| 機能 | list エンドポイント |
reconcile エンドポイント |
|---|---|---|
| HTTP メソッド | GET https://health.googleapis.com/v4/users/me/dataTypes/<var>dataType</var>/dataPoints |
GET https://health.googleapis.com/v4/users/me/dataTypes/<var>dataType</var>/dataPoints:reconcile |
| 重複動作 | 重複除去を行わずに、保存されているすべてのレコードをアップロード済みとして返します。間隔が重複している場合は、両方のレコードが返されます。 | デバイスと同期セッションにまたがる重複するレコードの競合を解決し、重複を排除して、1 つの連続したストリームに統合します。 |
| メリット | 各デバイスと同期バッチによってアップロードされたすべてのレコードの完全な未変更の監査証跡を提供します。 | 重複する間隔やマルチデバイスの競合を自動的に処理することで、タイムラインのレンダリングと期間の計算を簡素化します。 |
| デメリット | 重複する間隔、マルチデバイスの競合、手首から外している期間の検出と解決は、アプリケーションが行います。 | 重複する下位レコードはレスポンスから除外されるため、個々のデバイスの同期バッチを単独で監査することはできません。 |
reconcile エンドポイントは、ユーザー インターフェースの描画、アクティビティ タイムラインのレンダリング、重複しない期間の合計の計算を目的としています。これにより、再バケット化された同期セッションの競合する間隔が解決されます。また、スマートウォッチやスマートフォンなど、複数のデバイスで同時に記録されたアクティビティを調整します。
調整では、人工的な時間結合を合成するのではなく、信頼できるレコードを選択することで、競合するセッションを解決します。たとえば、11:00:00Z から 11:30:00Z と 11:20:00Z から 11:50:00Z を 11:00:00Z から 11:50:00Z に統合しません。調整されたレスポンスは、元の記録された間隔で勝ったデータポイントを返します。これにより、そのセッションの測定されたテレメトリーと指標の整合性が維持されます。
図 3 は、reconcile エンドポイントが重複するセッションを処理する方法を示しています。人工的な時間結合を作成するのではなく、信頼できるレコードを選択します。
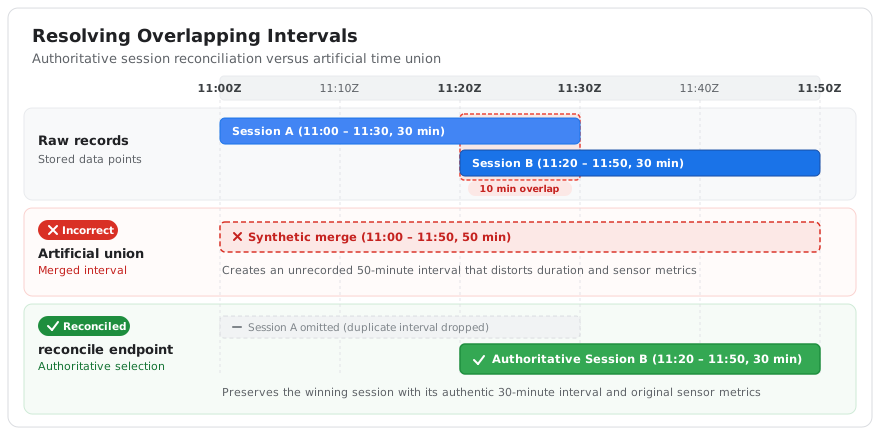
Endpoints ガイドには、リクエストとレスポンスの完全な例が記載されています。未加工の list レコードと reconcile 出力を比較するには、期間データの調整済みビューを取得するをご覧ください。
list エンドポイントは、デバイスの診断とデータ監査用に設計されています。ワークフローで、各デバイスからアップロードされた未変更のレコードを検査する必要がある場合に使用します。list でクエリを実行する場合、クライアント ロジックで元データの期間の重複を処理する必要があります。
タイムスタンプの変更可能性とオーナーの更新
接続されたデバイスは、通常の同期サイクル中に保存されたタイムスタンプを遡及的に変更しません。ただし、間隔タイムスタンプ(startTime と endTime)は、すべてのデータソースで普遍的に不変ではありません。レコードのフィールドを変更できるのは、レコードの元の作成者またはオーナーのみです。他のアプリケーションは、作成していないデータポイントを編集できません。
オーナー アプリケーションは、patch エンドポイントを使用して既存のレコードを更新できます。これには、開始タイムスタンプまたは終了タイムスタンプの変更が含まれます。PATCH を使用してタイムスタンプを更新する例については、Endpoints ガイドの既存のデータのインターバル タイムスタンプを更新するをご覧ください。
同様に、ヘルスコネクトやパートナー アプリなどの外部プラットフォームから同期されたデータポイントは、元のソースからの更新を継承します。元のアプリケーションが既存のレコードを変更すると、それらの更新が Google Health に伝播されます。