

使用 Google Health API 中的資料時,核心作業是在雲端 Google Health API 資料儲存庫與您自己的應用程式或後端資料儲存庫之間,同步處理資料。不過,這個週期會因多種因素而有不同形式:
- 您是否要將資料寫入 Google Health API?是否只能讀取?還是兩者都做?
- 資料儲存區是否位於應用程式或裝置的本機?還是您自己的雲端?
- 您是否需要在使用者應用程式和穿戴式裝置之間同步處理 Google Health API 資料?你多常同步裝置?
- 您處理哪些類型的資料?基本計數?測量單位? 取樣率不同的序列?
- 您是否打算在應用程式於背景執行時讀取資料?
- 您是否打算使用應用程式取得使用者權限前記錄的歷來資料?
如要瞭解整體運作方式,請參閱 Google Health API 同步生命週期。這個生命週期有兩個版本:標準 (讀取和寫入) 和唯讀。
標準同步生命週期
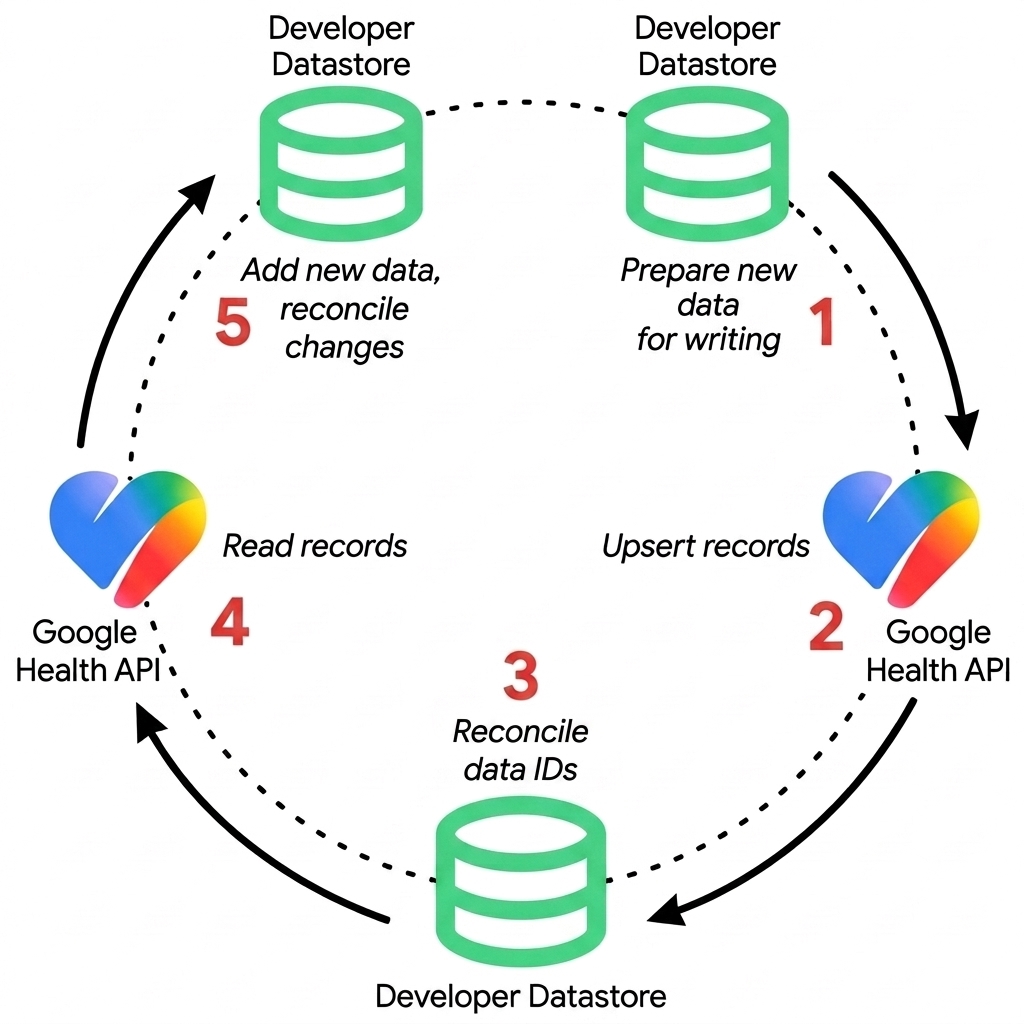
整合 Google Health API 代表將資料複製到應用程式或後端資料存放區。為方便在本說明文件中使用,我們將這個資料儲存區稱為「開發人員資料儲存區」。
這裡的「複製」可以取代任何獨立活動,例如從 Google Health API 讀取資料 (複製到開發人員資料儲存庫),或是寫入 Google Health API (複製到 Google Health API)。以特定順序重複執行這些動作,就是同步生命週期。
圖 1 說明標準同步生命週期,其中包含讀取和寫入作業,不考慮先前提及的任何因素。
寫入
- 準備要寫入的新資料:從外部裝置或應用程式轉移資料,並將資料點格式化為與 Google Health API 資料類型相容的 JSON 表示法。請注意,健康資料 API 目前不支援寫入作業的自訂用戶端指派 ID。這類 ID 可能會出現在
POST中,但系統會忽略這些 ID。 - 新增或更新記錄:使用 REST 端點將資料點提交至 Google Health API。使用
POST建立記錄,並使用PATCH插入及更新現有記錄。PATCH作業所需的 ID 來自先前的POST作業 (前一週期的下一個步驟)。 - 處理傳回的資源 ID - 使用伺服器產生的 ID 時,請在開發人員資料存放區中擷取並保存伺服器傳回的資源
name或 ID,以便日後更新 (PATCH) 或刪除 (DELETE)。如要進一步瞭解這兩種 ID,請參閱識別策略。
讀取
- 讀取記錄:使用 REST 端點 (
GET搭配filter查詢參數和pageToken分頁,或rollUp和dailyRollUp等匯總端點),從 Google Health API 擷取新資料和現有資料的變更,或使用 Webhook 訂閱 (projects.subscribers) 接收即時通知。通知只會指出有新資料可用,不會顯示實際資料。 - 協調開發人員資料儲存庫:將新資料和更新資料協調至開發人員資料儲存庫。連線裝置在同步處理期間可能會產生重疊間隔。如要瞭解 Google Health API 如何解決這些問題,請參閱「間隔時間戳記和連結裝置同步」。
然後,這個週期會根據外部裝置或應用程式的特定需求,在適當間隔重複執行。一般來說,我們建議您按照這個順序,在自己的資料儲存庫和 Google Health API 之間同步資料。
識別策略
如要將資料寫入 Google Health API,請先選擇資源識別策略,再建立資料點 (基本資料單位),然後與 Google Health API 整合。
健康資料 API 目前不支援寫入作業的用戶端指派 ID。
這類 ID 可能會以 POST 形式提供,但系統會忽略這些 ID。我們在此提供這項選項的詳細資料,僅供參考。
- 伺服器產生的 ID (預設選項):用戶端提交資料時不含 ID,Google Health API 後端會產生並傳回專屬的系統 ID。
- 用戶端指派的自訂 ID (根據 AIP-133,尚未支援): 用戶端應用程式會產生專屬 ID (例如 UUID 或本機資料庫主鍵),並在建立時提供於資源路徑中。
下表比較兩種識別策略,協助您為整合項目選擇合適的做法:
| 功能 | 伺服器產生的 ID | 客戶指派的自訂 ID |
|---|---|---|
| ID 生成 | 伺服器會在執行期間產生隨機系統 ID。POST |
用戶端會在寫入前,在本機產生穩定 ID (UUID v4 / 內部 PK)。 |
| 資源路徑 | .../dataPoints/{server_id} (在回應中傳回) |
.../dataPoints/{custom_id} |
| 撰寫當地內容後的步驟 | 必填項目。必須將傳回的 server_id 儲存在本機資料庫中,才能在日後更新/刪除。 |
無。應用程式已擁有該 ID。 |
| ID 對應表 | 必填項目。用戶端必須維護雙向對應 (local_id ↔ server_id)。 |
不需要。用戶端直接使用自己的主鍵。 |
| 重試行為 (網路訊號微弱) | 重複的風險。如果逾時後重試,系統會建立重複記錄,並指派新的伺服器 ID。POST
|
安全且具等冪性。使用相同的 custom_id 重試 POST,可避免重複建立 (傳回 409
ALREADY_EXISTS)。 |
| 離線同步支援 | 受限。必須等待伺服器回應,取得正式資源 ID,才能參照這些 ID。 | 完整。您可以使用穩定的 ID 離線建立及變動實體,然後在重新連線時順暢地同步處理。 |
| 格式限制 | 完全由伺服器處理。 | 必須遵循 ^[a-z0-9-]{4,63}$ (4 至 63 個小寫英數字元和連字號)。 |
| 選用時機 |
如果符合下列情況,請選擇伺服器產生的 ID:
|
在下列情況下,請選擇自訂 ID:
|
唯讀同步生命週期
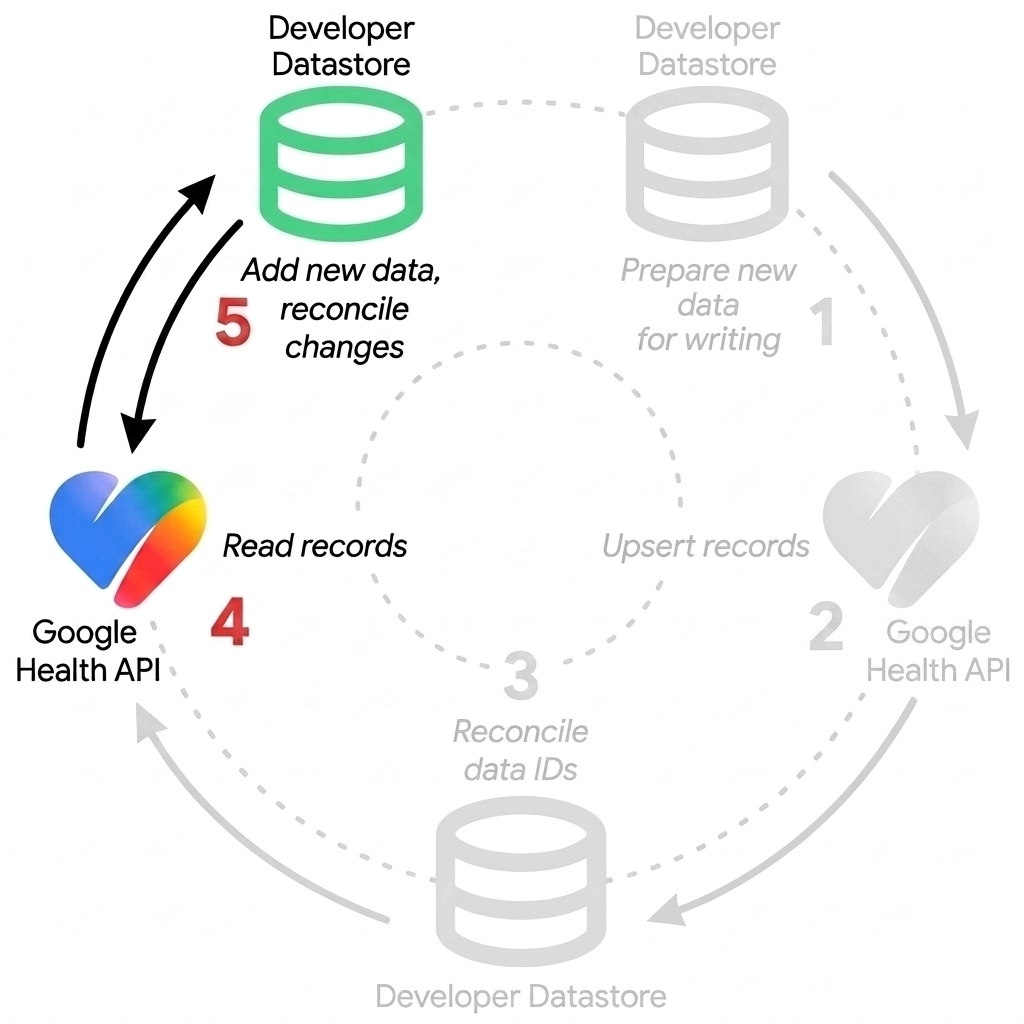
如果應用程式只打算從 Google Health API 讀取資料,就必須將資料複製到開發人員資料存放區,並處理生命週期的對帳部分。
「閱讀」一節中涵蓋的相同工作也適用於此。
圖 2 說明唯讀生命週期。
間隔時間戳記和連結裝置同步
間隔資料代表一段時間內收集的測量結果,例如步數、心率或運動階段。相較之下,時間點測量值包括手動輸入的資料,例如飲食記錄或體重計讀數。間隔資料通常來自同步處理已連結的裝置,例如智慧手錶和健身追蹤裝置。
使用間隔資料時,間隔時間戳記 (startTime 和 endTime) 會產生獨特的行為。本節說明發生間隔重疊的原因,並比較 list 和 reconcile 端點。
已連結裝置的重疊間隔
連結的裝置 (例如 Fitbit 智慧手環和 Google Pixel Watch) 會在配戴時持續收集高頻率的生物特徵辨識讀數。裝置將資料點同步至 Google Health 後,不會回溯變更現有記錄。儲存的時間間隔時間戳記維持不變。
不過,在後續的同步週期前,裝置端演算法通常會重新解讀原始感應器遙測資料。裝置會重新將前幾小時收集的讀數分類。裝置再次同步時,就會上傳新的資料點。開始和結束界線可以與先前儲存的時間間隔重疊。
舉例來說,假設使用者戴著智慧手錶,活動記錄會連續同步處理兩批:
- 首次同步處理時,裝置會上傳涵蓋
10:00:00Z至10:14:59Z的資料點。 - 裝置端重新計算後,第二次同步會上傳涵蓋
10:14:00Z到10:28:59Z的另一個資料點。
這兩項記錄會分別儲存在 Google Health 後端。因此,這兩個資料點涵蓋從 10:14:00Z 到 10:14:59Z 的間隔。查詢原始記錄時,這會產生 59 秒的重疊。
比較清單並比對端點
您可以使用 list 或 reconcile 端點處理這些重疊的時間間隔。請選擇符合應用程式需求的端點:
| 功能 | list 個端點 |
reconcile 個端點 |
|---|---|---|
| HTTP 方法 | GET https://health.googleapis.com/v4/users/me/dataTypes/<var>dataType</var>/dataPoints |
GET https://health.googleapis.com/v4/users/me/dataTypes/<var>dataType</var>/dataPoints:reconcile |
| 重疊行為 | 傳回所有儲存的記錄,視為已上傳,不會刪除重複項目。如果間隔重疊,系統會傳回兩筆記錄。 | 解決衝突並移除重複記錄,將不同裝置和同步工作階段的資料整合成單一連續串流。 |
| 優點 | 提供每個裝置和同步處理批次上傳的每筆記錄,完整且未經修改的稽核追蹤記錄。 | 自動處理重疊的時間間隔和多部裝置的衝突,簡化時間軸的算繪和時間長度計算。 |
| 缺點 | 您的應用程式負責偵測及解決時間間隔重疊、多裝置衝突和未戴手錶的時間。 | 回應中會省略重疊的下層記錄,因此無法單獨稽核個別裝置的同步批次。 |
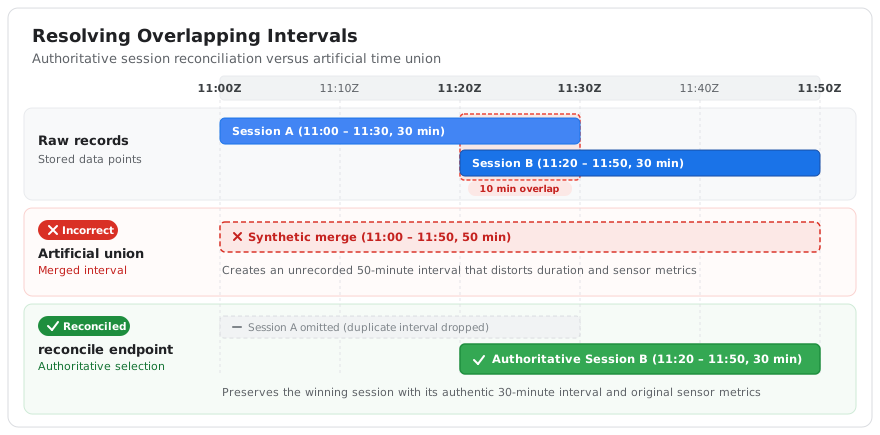
reconcile 端點用於繪製使用者介面、算繪活動時間軸,以及計算不重疊的總時長。解決重新分組的同步工作階段中發生衝突的時間間隔。此外,這項功能還會比對多部裝置 (例如手錶和手機) 同時記錄的活動。
系統會選取權威記錄,而非合成人工時間聯集,藉此解決工作階段衝突。舉例來說,這項功能不會將 11:00:00Z 合併至 11:30:00Z,也不會將 11:20:00Z 合併至 11:50:00Z,而是合併至 11:00:00Z 至 11:50:00Z。調解後的回應會傳回獲勝的資料點,以及原始記錄間隔。這樣一來,該工作階段的遙測資料和指標完整性就不會受到影響。
圖 3 說明 reconcile 端點如何處理重疊的工作階段。系統會選取權威記錄,而不是建立人工時間聯集。
Endpoints 指南提供完整的要求和回應範例。如要比較原始 list 記錄與 reconcile 輸出內容,請參閱「取得間隔資料的對帳檢視畫面」。
list 端點專為裝置診斷和資料稽核而設計。如果工作流程需要檢查各裝置上傳的未修改記錄,請使用這項功能。使用 list 查詢時,用戶端邏輯必須處理原始資料中的任何間隔重疊。
時間戳記可變動性與擁有者更新
在正常同步週期中,連線裝置不會追溯修改儲存的時間戳記。不過,間隔時間戳記 (startTime 和 endTime) 並非所有資料來源都一律不可變更。只有記錄的原始建立者或擁有者可以修改記錄的欄位。其他應用程式無法編輯自己未建立的資料點。
擁有者應用程式可以使用 patch 端點更新現有記錄。包括修改開始或結束時間戳記。
如需使用 PATCH 更新時間戳記的範例,請參閱 Endpoints 指南中的「更新現有資料的時間間隔時間戳記」。
同樣地,從外部平台 (例如「健康資料同步」或合作夥伴應用程式) 同步的資料點,也會沿用原始來源的更新。當原始應用程式修改現有記錄時,這些更新會傳播至 Google 健康。