

Trabajar con datos en la API de Google Health es, en esencia, un ciclo de sincronización de datos entre el almacén de datos de la API de Google Health en la nube y tu propia app o almacén de datos de backend. Sin embargo, este ciclo puede tomar diferentes formas según una variedad de factores:
- ¿Estás escribiendo datos en la API de Google Health? ¿Solo lectura? ¿O ambas?
- ¿Tu almacén de datos es local en la app o el dispositivo? ¿O en tu propia nube?
- ¿Necesitas sincronizar los datos de la API de Google Health entre la app del usuario y un dispositivo wearable? ¿Con qué frecuencia sincronizas los dispositivos?
- ¿Con qué tipos de datos trabajas? ¿Recuentos básicos? ¿Unidades de medida? ¿Series con diferentes tasas de muestreo?
- ¿Planeas leer datos mientras tu app se ejecuta en segundo plano?
- ¿Planeas trabajar con datos históricos registrados antes de que tu app recibiera permisos del usuario?
Para comprender cómo se relaciona todo, consulta el ciclo de vida de la sincronización de la API de Google Health. Existen dos versiones de este ciclo de vida: estándar (lectura y escritura) y de solo lectura.
El ciclo de vida de la sincronización estándar
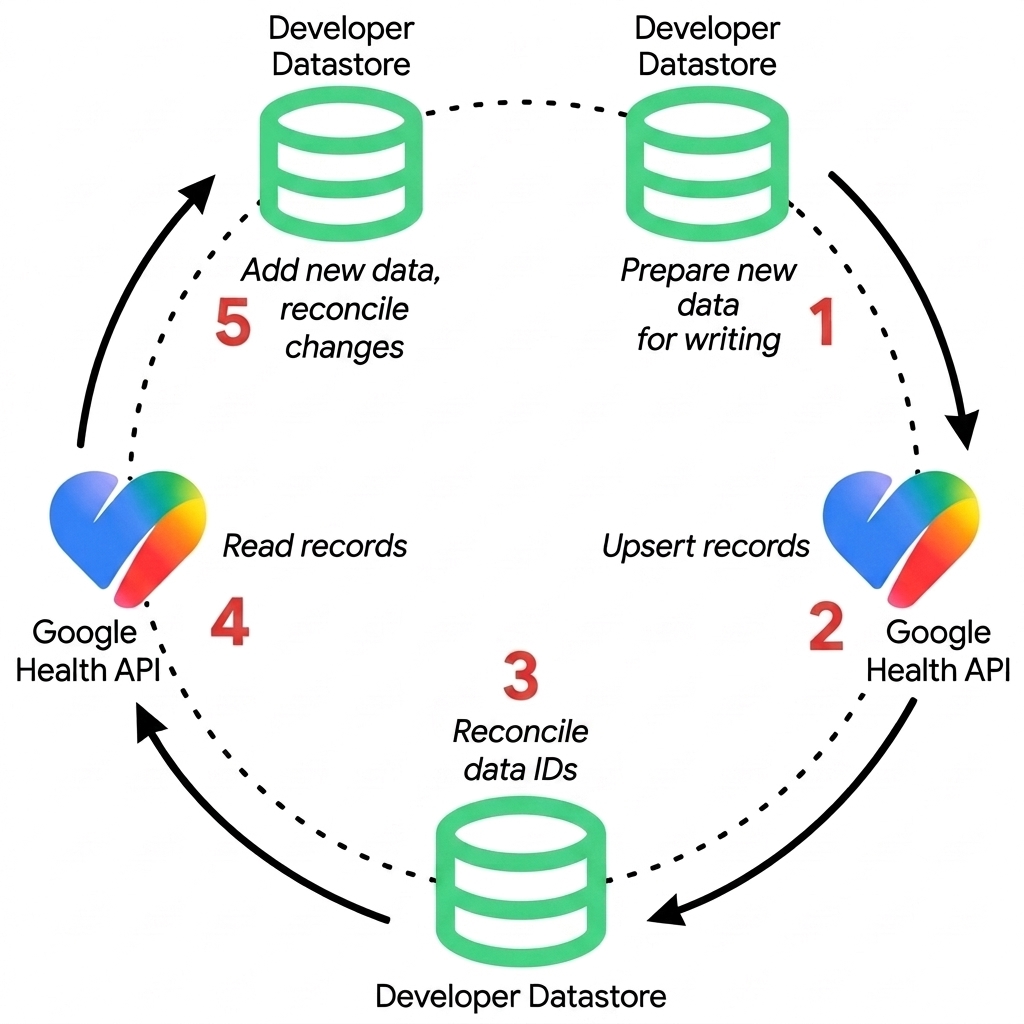
La integración con la API de Google Health implica copiar datos en un almacén de datos de backend o de una app. Para facilitar el uso en esta documentación, llamaremos a este almacén de datos el almacén de datos del desarrollador.
Aquí, "copiar" puede reemplazar cualquier actividad discreta, como leer desde la API de Google Health (copiar al almacén de datos del desarrollador) o escribir en la API de Google Health (copiar a la API de Google Health). Realizar estas acciones de forma repetida en un orden específico es el ciclo de vida de la sincronización.
En la figura 1, se ilustra el ciclo de vida de sincronización estándar que involucra operaciones de lectura y escritura, sin tener en cuenta ninguno de los factores mencionados anteriormente.
Escritura
- Prepara datos nuevos para escribir: Transfiere datos desde un dispositivo o una app externos, y formatea los puntos de datos en representaciones JSON compatibles con los tipos de datos de la API de Google Health. Ten en cuenta que, por el momento, la API de Health no admite IDs personalizados asignados por el cliente para las escrituras. Estos IDs se pueden proporcionar en un
POST, pero se ignoran. - Actualizar o insertar registros: Envía datos a la API de Google Health con endpoints de REST. Usa
POSTpara crear registros yPATCHpara insertar y actualizar registros existentes. Los IDs necesarios para la operaciónPATCHprovendrán de una operaciónPOSTanterior (próximo paso en un ciclo anterior). - Procesa los IDs de recursos devueltos: Cuando uses IDs generados por el servidor, extrae y conserva el recurso
nameo el ID devuelto por el servidor en el almacén de datos del desarrollador para habilitar futuras actualizaciones (PATCH) o eliminaciones (DELETE). Consulta Estrategias de identificación para obtener más información sobre los dos tipos.
Leer
- Leer registros: Recupera datos nuevos y cambios en los datos existentes de la API de Google Health con extremos de REST (
GETcon parámetros de consultafiltery paginaciónpageToken, o extremos de agregación comorollUpydailyRollUp), o recibe notificaciones en tiempo real con suscripciones a Webhooks (projects.subscribers). Una notificación solo indica que hay datos nuevos disponibles, no cuáles son los datos reales. - Reconcile developer datastore: Concilia los datos nuevos y actualizados con tu almacén de datos para desarrolladores. Los dispositivos conectados pueden producir intervalos superpuestos durante las sincronizaciones. Para obtener más información sobre cómo la API de Google Health los resuelve, consulta Marcas de tiempo de intervalos y sincronización de dispositivos conectados.
Luego, este ciclo se repite en intervalos adecuados según las necesidades específicas de los dispositivos o las apps externos. En general, este es el orden que recomendamos para sincronizar los datos entre tu propio almacén de datos y la API de Google Health.
Estrategias de identificación
Si planeas escribir datos en la API de Google Health, antes de crear tu integración con las APIs de Google Health, debes elegir una estrategia de identificación de recursos cuando crees puntos de datos (la unidad básica de datos).
Por el momento, la API de Health no admite los IDs asignados por el cliente para las escrituras.
Estos IDs se pueden proporcionar en un POST, pero se ignoran. Los detalles sobre esta opción se proporcionan aquí con fines informativos.
- IDs generados por el servidor (opción predeterminada): El cliente envía datos sin un ID, y el backend de la API de Google Health genera y devuelve un identificador único del sistema.
- IDs personalizados asignados por el cliente (según AIP-133, aún no se admiten): La app cliente genera un identificador único (por ejemplo, un UUID o una clave principal de la base de datos local) y lo proporciona en la ruta de acceso del recurso durante la creación.
En la siguiente tabla, se comparan ambas estrategias de identificación para ayudarte a elegir el enfoque adecuado para tu integración:
| Función | IDs generados por el servidor | IDs personalizados asignados por el cliente |
|---|---|---|
| Generación de ID | El servidor genera un ID del sistema aleatorio durante la ejecución de POST. |
El cliente genera un ID estable de forma local (UUID v4 / PK interno) antes de la escritura. |
| Ruta de acceso al recurso | .../dataPoints/{server_id} (se devuelve en la respuesta) |
.../dataPoints/{custom_id} |
| Paso posterior a la escritura local | Obligatorio. Se debe almacenar el server_id devuelto en la base de datos local para permitir futuras actualizaciones o eliminaciones. |
Ninguno. La app ya posee el ID. |
| Tabla de asignación de ID | Obligatorio. El cliente debe mantener una asignación bidireccional (local_id ↔ server_id). |
No es necesario. El cliente usa su propia clave primaria directamente. |
| Comportamiento de reintento (red débil) | Riesgo de duplicados: Si se reintenta una operación POST que agotó el tiempo de espera, se crea un registro duplicado con un nuevo ID de servidor. |
Seguro y idempotente. Volver a intentar POST con el mismo custom_id evita la creación de duplicados (muestra 409
ALREADY_EXISTS). |
| Compatibilidad con la sincronización sin conexión | Limitada. Debe esperar la respuesta del servidor para obtener los IDs de recursos oficiales antes de hacer referencia a ellos. | Full. Las entidades se pueden crear y modificar sin conexión con IDs estables, y luego se sincronizan sin problemas cuando se restablece la conexión. |
| Restricciones de formato | El servidor se encarga de todo. | Debe seguir el formato ^[a-z0-9-]{4,63}$ (de 4 a 63 caracteres alfanuméricos en minúscula y guiones). |
| Cuándo elegir |
Elige IDs generados por el servidor en los siguientes casos:
|
Elige IDs personalizados en los siguientes casos:
|
El ciclo de vida de la sincronización de solo lectura
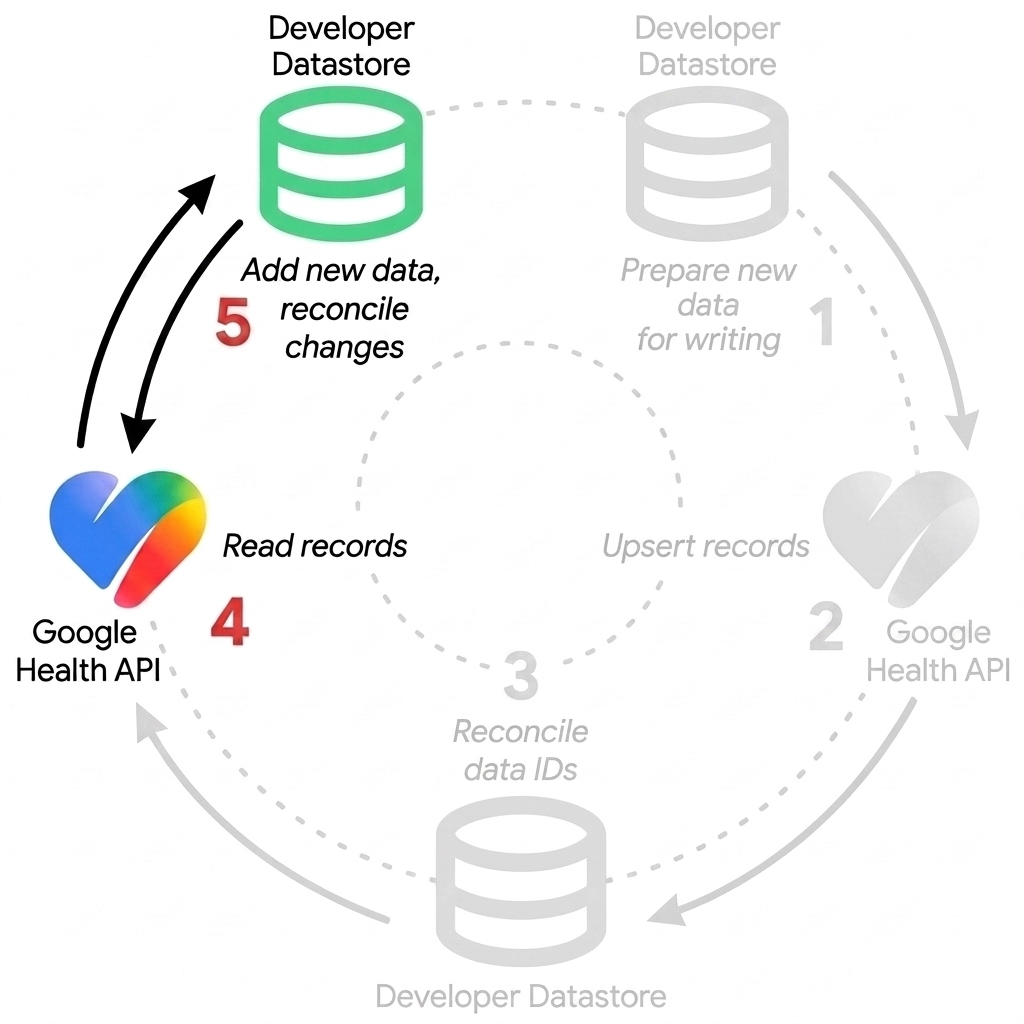
Una app que solo pretenda leer datos de la API de Google Health debe copiar los datos en su almacén de datos para desarrolladores y controlar la parte de conciliación del ciclo de vida.
Aquí se aplican las mismas tareas que se describen en la sección Lectura.
En la figura 2, se ilustra el ciclo de vida de solo lectura.
Marcas de tiempo de intervalos y sincronización de dispositivos conectados
Los datos de intervalo representan las mediciones recopiladas durante un período, como los pasos, la frecuencia cardíaca o las sesiones de ejercicio. Por el contrario, las mediciones en un momento determinado incluyen entradas manuales, como un registro de alimentos o la lectura de una báscula. Por lo general, los datos de intervalo provienen de la sincronización de dispositivos conectados, como relojes inteligentes y monitores de estado físico.
Las marcas de tiempo de intervalo (startTime y endTime) introducen comportamientos únicos cuando se trabaja con datos de intervalo. En esta sección, se explica por qué se producen intervalos superpuestos y se comparan los extremos list y reconcile.
Intervalos superpuestos de dispositivos conectados
Los dispositivos conectados, como los monitores Fitbit y el Google Pixel Watch, recopilan continuamente lecturas biométricas de alta frecuencia mientras se usan. Después de que un dispositivo sincroniza los puntos de datos con Google Health, no altera de forma retroactiva esos registros existentes. Las marcas de tiempo de intervalo almacenadas permanecen sin cambios.
Sin embargo, antes de los ciclos de sincronización posteriores, los algoritmos integrados en el dispositivo suelen reinterpretar los datos de telemetría sin procesar del sensor. El dispositivo vuelve a agrupar las lecturas recopiladas durante las horas anteriores. Cuando el dispositivo se vuelva a sincronizar, subirá nuevos puntos de datos. Sus límites de inicio y fin pueden superponerse con intervalos almacenados anteriormente.
Por ejemplo, considera un usuario que usa un reloj inteligente cuyos datos de actividad se sincronizan en dos lotes consecutivos:
- Durante la primera sincronización, el dispositivo sube un punto de datos que abarca desde
10:00:00Zhasta10:14:59Z. - Después del recálculo integrado en el dispositivo, una segunda sincronización sube otro punto de datos que abarca desde
10:14:00Zhasta10:28:59Z.
Ambos registros se almacenan de forma independiente en el backend de Google Health. Como resultado, ambos datos abarcan el intervalo de 10:14:00Z a 10:14:59Z.
Esto produce una superposición de 59 segundos cuando se consultan registros sin procesar.
Comparar la lista y conciliar los extremos
Puedes controlar estos intervalos superpuestos con el extremo list o reconcile. Elige el extremo que coincida con los requisitos de tu aplicación:
| Función | Extremo list |
Extremo reconcile |
|---|---|---|
| Método HTTP | GET https://health.googleapis.com/v4/users/me/dataTypes/<var>dataType</var>/dataPoints |
GET https://health.googleapis.com/v4/users/me/dataTypes/<var>dataType</var>/dataPoints:reconcile |
| Comportamiento de superposición | Devuelve todos los registros almacenados como cargados sin deduplicación. Cuando los intervalos se superponen, se devuelven ambos registros. | Resuelve conflictos y elimina registros duplicados que se superponen en dispositivos y sesiones de sincronización en un solo flujo continuo. |
| Ventajas | Proporciona un registro de auditoría completo y sin modificaciones de cada registro que sube cada dispositivo y lote de sincronización. | Simplifica la renderización de la línea de tiempo y los cálculos de duración, ya que controla automáticamente los intervalos superpuestos y los conflictos multidispositivo. |
| Desventajas | Tu aplicación es responsable de detectar y resolver los intervalos superpuestos, los conflictos multidispositivo y los períodos sin el dispositivo en la muñeca. | Los registros superpuestos subordinados se omiten en la respuesta, por lo que los lotes de sincronización de dispositivos individuales no se pueden auditar de forma aislada. |
El extremo reconcile está diseñado para dibujar interfaces de usuario, renderizar cronogramas de actividad y calcular totales de duración sin superposiciones. Resuelve los intervalos en conflicto de las sesiones de sincronización con cambios en la discretización. También concilia la actividad registrada de forma simultánea en varios dispositivos, como un reloj y un teléfono.
La conciliación resuelve las sesiones en conflicto seleccionando el registro autorizado en lugar de sintetizar una unión de tiempo artificial. Por ejemplo, no combina 11:00:00Z con 11:30:00Z y 11:20:00Z con 11:50:00Z en 11:00:00Z con 11:50:00Z. La respuesta conciliada devuelve el punto de datos ganador con su intervalo registrado original. Esto preserva la integridad de la telemetría y las métricas medidas de esa sesión.
En la Figura 3, se ilustra cómo el extremo reconcile controla las sesiones superpuestas.
Selecciona el registro autorizado en lugar de crear una unión artificial de tiempo.
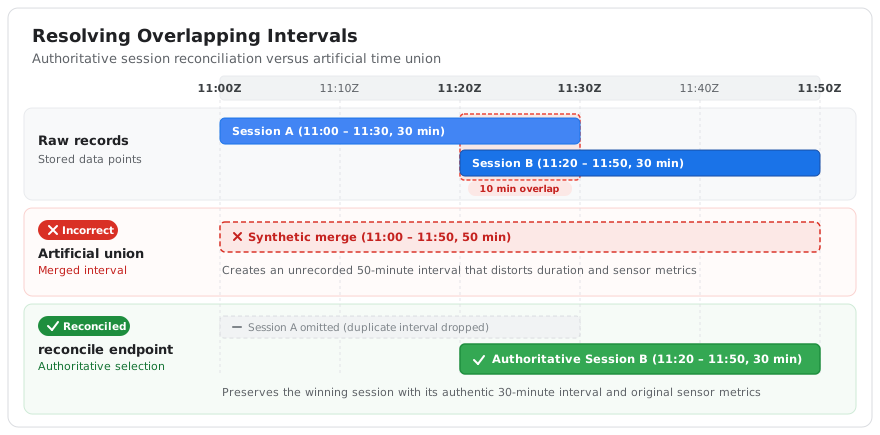
La guía de Endpoints proporciona ejemplos completos de solicitudes y respuestas. Para comparar los registros list sin procesar con el resultado de reconcile, consulta Cómo obtener una vista conciliada de los datos de intervalos.
El extremo list está diseñado para el diagnóstico de dispositivos y las auditorías de datos. Úsalo cuando tu flujo de trabajo requiera inspeccionar registros sin modificar tal como los subió cada dispositivo. Cuando realices consultas con list, la lógica del cliente debe controlar cualquier superposición de intervalos en los datos sin procesar.
Inmutabilidad de la marca de tiempo y actualizaciones del propietario
Los dispositivos conectados no modifican de forma retroactiva las marcas de tiempo almacenadas durante los ciclos de sincronización normales. Sin embargo, las marcas de tiempo de intervalo (startTime y endTime) no son universalmente inmutables en todas las fuentes de datos. Solo el creador o propietario original de un registro puede modificar sus campos. Otras aplicaciones no pueden editar los puntos de datos que no crearon.
Una aplicación propietaria puede usar el endpoint patch para actualizar sus registros existentes. Esto incluye la modificación de las marcas de tiempo de inicio o finalización.
Para ver un ejemplo de cómo actualizar marcas de tiempo con PATCH, consulta Cómo actualizar marcas de tiempo de intervalos para datos existentes en la guía de Endpoints.
Del mismo modo, los puntos de datos sincronizados desde plataformas externas, como Health Connect o apps de socios, heredan las actualizaciones de la fuente original. Cuando la aplicación de origen modifica un registro existente, esas actualizaciones se propagan a Google Health.